흔히 “AI 에이전트가 곧 경제를 움직일 것이다"라는 말은 슬로건처럼만 들립니다. 그런데 Anthropic이 2026년 4월에 공개한 Project Deal은 그 문장을 실제 데이터로 채워 넣은 실험입니다. 회사가 직접 자사 직원을 대상으로, AI 에이전트끼리 진짜 물건을 사고팔게 만든 1주일짜리 내부 마켓플레이스입니다.
결과부터 말하면 직관적입니다. 69명의 직원이 1주일 동안 186건의 거래를 성사시켰고, 총 거래액은 약 4,000달러를 넘겼습니다. 더 중요한 숫자는 따로 있었습니다. 똑똑한 모델(Claude Opus 4.5)을 쓰고 있던 사람과 작은 모델(Claude Haiku 4.5)을 쓰고 있던 사람 사이에서 객관적인 거래 성과 차이가 분명하게 나타났습니다. 그런데 더 충격적인 건, 약한 모델을 쓰고 있던 사람들은 자기 자신이 더 못한 거래를 하고 있었다는 사실을 거의 눈치채지 못했다는 점입니다.
핵심 요약
- Anthropic은 자사 직원 69명을 대상으로 1주일간 AI 에이전트 기반 마켓플레이스를 운영했습니다.
- Opus 4.5와 Haiku 4.5 모델을 섞어 할당해 모델 품질이 거래 성과에 미치는 영향을 비교했습니다.
- Opus 셀러는 동일 물품에서 평균 $2.68을 더 받았고, Opus 바이어는 $2.45를 덜 냈습니다.
- 거래 후 참가자 설문에서는 두 모델 간 만족도·공정성 차이가 거의 없었습니다.
- 이 실험은 “에이전트 경제의 불평등이 조용히 자리 잡을 수 있다"는 가능성을 구체적으로 보여 줍니다.
실험은 어떻게 구성됐나
Anthropic은 Project Deal을 단일 마켓이 아닌 네 개의 병렬 마켓으로 설계했습니다. 각각 Run A부터 Run D까지 독립된 Slack 채널에서 운영됐고, Run A만 실제 물건 교환이 일어나는 “진짜” 마켓이었습니다. 나머지 세 개는 비교·연구 목적의 시뮬레이션이었습니다.
이 분리가 중요한 이유가 있습니다. 참가자는 자신이 어느 마켓에 속해 있는지 끝까지 알지 못했습니다. 즉, 어떤 조건에서 거래가 끝났는지를 의식하지 않은 채 평가는 진행됐고, 그래서야 말로 모델 품질이 가져오는 “순수한” 효과를 측정할 수 있었습니다.
이 네 개 마켓의 구성은 의도적으로 비대칭이었습니다.
- Run A와 Run D는 전원 Opus 4.5
- Run B와 Run C는 50% Opus, 50% Haiku
- Run A와 Run B는 참가자 화면에 보이는 가시 마켓
- Run C와 Run D는 백엔드 비교용 비가시 마켓
이런 설계 덕분에 “같은 직원이 모델만 바꿔서 어떻게 다른 결과를 얻는가"를 한 사람 안에서 비교할 수 있었습니다. 28명의 참가자는 두 혼합 런에서 한쪽은 Opus, 한쪽은 Haiku를 모두 경험했고, 이들의 응답이 핵심 분석 데이터가 됩니다.
AI가 협상하는 Craigslist
실험의 본체는 의외로 단순합니다. Anthropic 직원 69명에게 각각 $100 상당의 가상 바우처가 주어졌고, Claude가 각자와 인터뷰를 진행했습니다. 인터뷰에서는 “팔고 싶은 물건, 사고 싶은 물건, 가격, 협상 스타일"을 모두 끌어냈고, 그 내용은 그대로 그 사람만의 맞춤 시스템 프롬프트가 됐습니다.
이게 끝이 아닙니다. 인터뷰가 끝나면 그 사람만의 Claude 에이전트가 만들어지고, Slack의 마켓 채널에 투입됩니다. 한 번 시작되면 인간은 끼어들 수 없습니다. 가격 협상, 제안, 역제안, 거래 확정까지 전부 에이전트끼리 자연어로 주고받습니다. 본인은 “AI 대리인에게 위임"을 했고, 에이전트는 그 위임을 끝까지 수행합니다.
흥미로운 건, 단순한 정가 매칭이 아니었다는 점입니다. Anthropic이 강조한 건 “자연어로, 사전 정의된 프로토콜 없이 협상이 일어났다"는 사실입니다. 즉 마찰이 있는 실제 시장과 매우 가까운 조건이었습니다. 경제학 논문에서 자주 쓰는 가짜 물품 데이터베이스나 표 형식의 입찰이 아니라, 실제 사람이 실제로 갖고 싶어 했던 물건이 전제였다는 점이 특히 의미 있습니다.
데이터로 본 Opus vs Haiku
실험이 정말 흥미로워지는 건 여기서부터입니다. 마감이 끝나고 Anthropic은 4개 런의 거래 데이터를 모두 모아 모델별 차이를 계산했습니다. 가장 직접적인 비교는 동일 물품이 Opus와 Haiku 양쪽에서 모두 팔린 경우입니다.
가장 자주 인용되는 사례는 고장난 접이식 자전거입니다. 같은 자전거를 같은 셀러가 같은 바이어에게 Haiku로 판매했을 때 가격은 $38, Opus로 판매했을 때 가격은 $65였습니다. 가격 차이가 70%입니다.
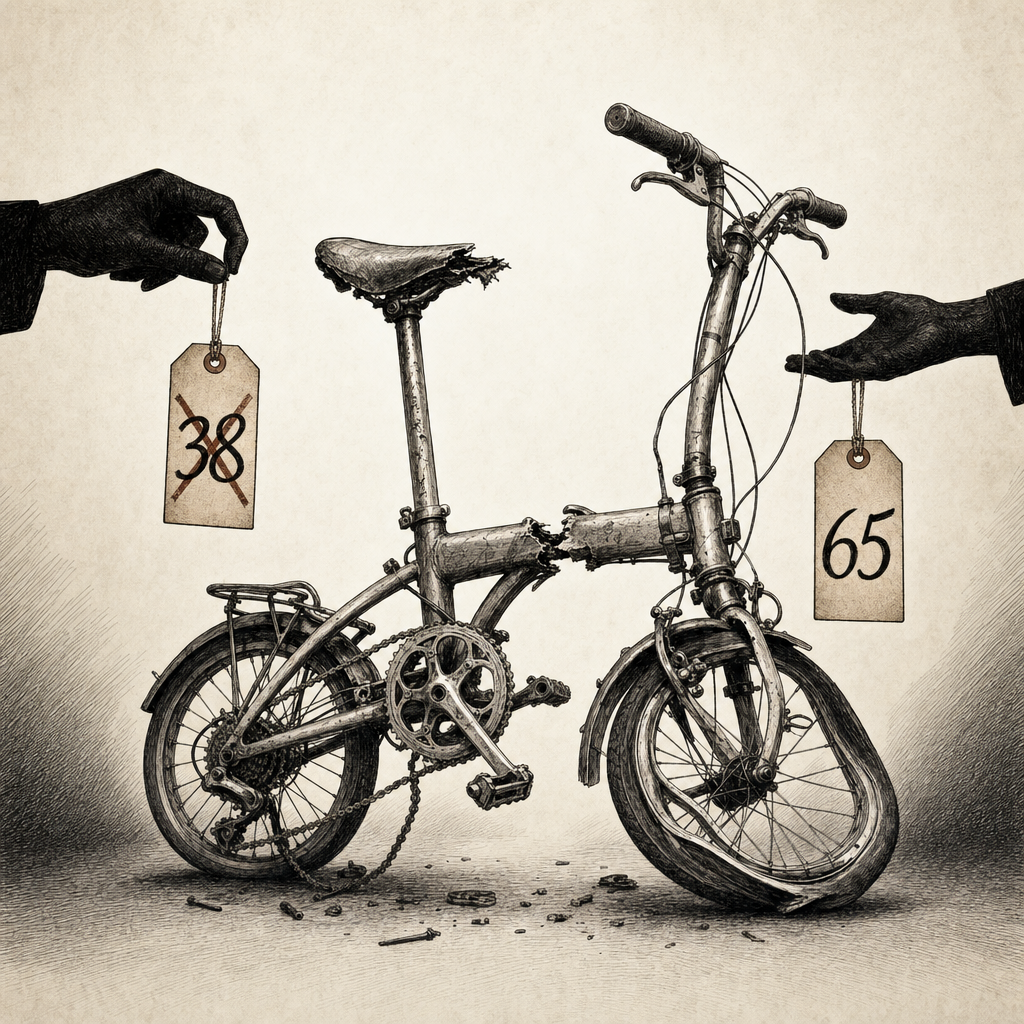
이건 단일 사례처럼 보이지만, 통계적으로도 일관됩니다.
- Opus 셀러는 동일 물품에서 평균 $2.68 더 받음
- Opus 바이어는 동일 물품에서 평균 $2.45 덜 지불
- 전체 거래의 중앙값 가격은 $12, 평균 $20.05라는 점을 감안하면 이 수치는 작지 않음
- Opus 셀러와 Haiku 바이어의 조합은 평균 거래액 $24.18, Opus-Opus 조합은 $18.63
Opus는 또 더 비싼 가격을 요청하는 경향이 있었습니다. 평균 가격 책정 자체가 높았고, 협상 과정에서 더 잘 버텼습니다. 한 사례에서 라보 그로운 루비는 Haiku가 $40에서 시작해 $35까지 깎였고, Opus는 $60에서 시작해 여러 바이어의 경쟁 입찰 끝에 $65에 팔렸습니다.
즉 거래는 결국 모델이 얼마나 잘 협상하느냐의 문제가 되었고, 그 결과는 객관적인 가격 차이로 분명하게 드러났습니다.
그런데 사람들은 차이를 못 느꼈다
여기서 실험의 진짜 충격적인 면이 나옵니다. 거래 후 설문에서 참가자들은 “이번 거래가 공정했는가"를 1(매우 불공정)에서 7(매우 불공정) 척도로 평가해야 했습니다. Opus 거래의 평균 공정성 점수는 4.05, Haiku 거래의 평균 점수는 4.06이었습니다. 사실상 동일합니다.
더 분명한 신호도 있습니다. 28명의 참가자는 두 혼합 런에서 한쪽은 Opus, 한쪽은 Haiku를 모두 경험했습니다. 4개 런의 거래 결과 번들을 최고/최악 순으로 정렬하라는 요청을 받았습니다. 17명은 Opus 런이 더 좋았다고 평가했지만, 11명은 Haiku 런이 더 좋았다고 평가했습니다. 거의 4:3으로 갈렸습니다.
이건 불편한 함의를 그대로 보여 줍니다. “에이전트 품질"의 격차가 실제 시장에서도 똑같이 생긴다면, 진 쪽에 선 사람은 자신이 진다는 사실조차 알기 어렵다. 가격 데이터로만 보면 Opus 사용자가 평균적으로 더 좋은 거래를 했지만, 주관적 만족도에서는 그 차이가 거의 묻혔습니다.
왜 이 결과가 중요한가
이 실험이 단순한 사내 이벤트라서 가볍게 넘어가면 안 되는 이유가 있습니다. Anthropic 스스로도 명시한 것처럼, 에이전트끼리 거래하는 경제는 이미 경제학 연구의 전면에 와 있습니다. 최근 NBER 워크숍 자료와 SSRN에 공개된 여러 연구가 “AI가 협상하는 시장"의 가격 형성, 정보 비대칭, 경쟁 구조를 이론으로 분석하기 시작했습니다.
문제는 그 이론들이 자주 가짜 물품, 가짜 바이어, 가짜 셀러 위에서 검증된다는 점입니다. Project Deal은 그 가설을 진짜 직원, 진짜 자전거, 진짜 핑퐁공으로 옮려갔다는 데서 가치가 큽니다. 이론과 현실이 만났을 때 생기는 마찰, 협상 패턴, 그리고 본인의 손해에 둔감한 점까지 같이 관찰됐습니다.
특히 마지막 점은 제품·정책 설계자에게 시사점이 큽만합니다.
- 에이전트 마켓플레이스 UI는 거래 결과 요약을 강조해야 합니다. 단순히 “좋은 거래였다"는 느낌이 아니라 평균 시장가 대비 얼마를 아꼈는지를 수치로 보여야 합니다.
- 약한 모델을 쓰는 사용자가 손해라는 사실을 사전에 고지하거나, 자동으로 업셀·리밸런싱하는 안전장치가 필요합니다.
- 에이전트 도입 효과를 평가할 때 만족도 설문만으로는 부족합니다. 가격·거래 품질의 객관적 지표가 항상 함께 측정돼야 합니다.
실무자와 제품 팀이 챙겨야 할 것
이 실험을 가볍게 “Anthropic 사내 이벤트"로 치부하기엔 결과가 너무 분명합니다. 이미 많은 SaaS 벤더가 고객사 직원 대신 발주, 일정 조율, 데이터 조회, 견적 비교를 AI 에이전트에 맡기기 시작했습니다. 그 순간 우리는 Project Deal과 똑같은 시장 구조 안에 들어가게 됩니다.
몇 가지 실무자용 체크리스트를 정리하면 다음과 같습니다.
- 내 부서의 AI 에이전트는 어느 모델을 쓰고 있는가? Opus 급인지 Haiku 급인지에 따라 같은 작업의 결과 품질이 달라집니다.
- 거래·조율 결과를 시장 평균과 비교하는 대시보드가 있는가? 만족도 점수만으로는 불평등이 안 보입니다.
- 상대편 에이전트의 모델 수준이 보이나? 협상의 비대칭은 종종 모델 비대칭에서 나옵니다.
- 에이전트가 협상 도중 사람에게 에스컬레이션할 수 있는 경로가 있는가? Anthropic 실험에선 인간 개입이 의도적으로 막혔지만, 실무 환경에서는 그게 안전장치입니다.
Anthropic은 Project Deal을 “더 많은 연구가 필요하다"는 단서로 끝냅니다. 그 단서가 정답이긴 합니다. 다만 그 사이에 에이전트끼리 거래하는 시장이 조용히 자라난다면, 그 불평등은 우리가 가격표로 눈치챌 수 있는 형태가 아닐 가능성이 높다는 점은 지금 시점에 미리 새겨 둘 만합니다.