출처: Anthropic
문서유형: 번역·해설
#Anthropic #Claude #MultiAgent #AIAgent #Research
핵심 요약
Anthropic이 Claude Research를 만들며 얻은 결론은 분명합니다. 복잡한 리서치에서는 “하나의 똑똑한 에이전트”보다, 여러 하위 에이전트가 각자 다른 방향을 탐색하고 핵심만 압축해 올리는 구조가 더 강합니다. 다만 이 방식은 토큰과 조율 비용이 크기 때문에, 모든 작업이 아니라 넓은 정보 탐색이 필요한 고부가가치 작업에 맞습니다.

리서치는 결국 압축의 문제다
리서치가 어려운 이유는 정답으로 가는 길이 미리 정해져 있지 않기 때문입니다. 자료를 찾다 보면 새로운 단서가 나오고, 그 단서가 다시 검색 방향을 바꿉니다. 처음부터 고정된 순서로 “1번 검색, 2번 요약, 3번 결론”처럼 처리하기 어렵습니다.
Anthropic은 이 문제를 멀티 에이전트 구조로 풀었습니다. 리드 에이전트가 전체 질문을 보고 전략을 세운 뒤, 여러 하위 에이전트에게 서로 다른 조사 임무를 나눠 줍니다. 하위 에이전트들은 각자 독립된 컨텍스트 창에서 검색하고, 결과를 압축해 리드 에이전트에게 돌려줍니다.
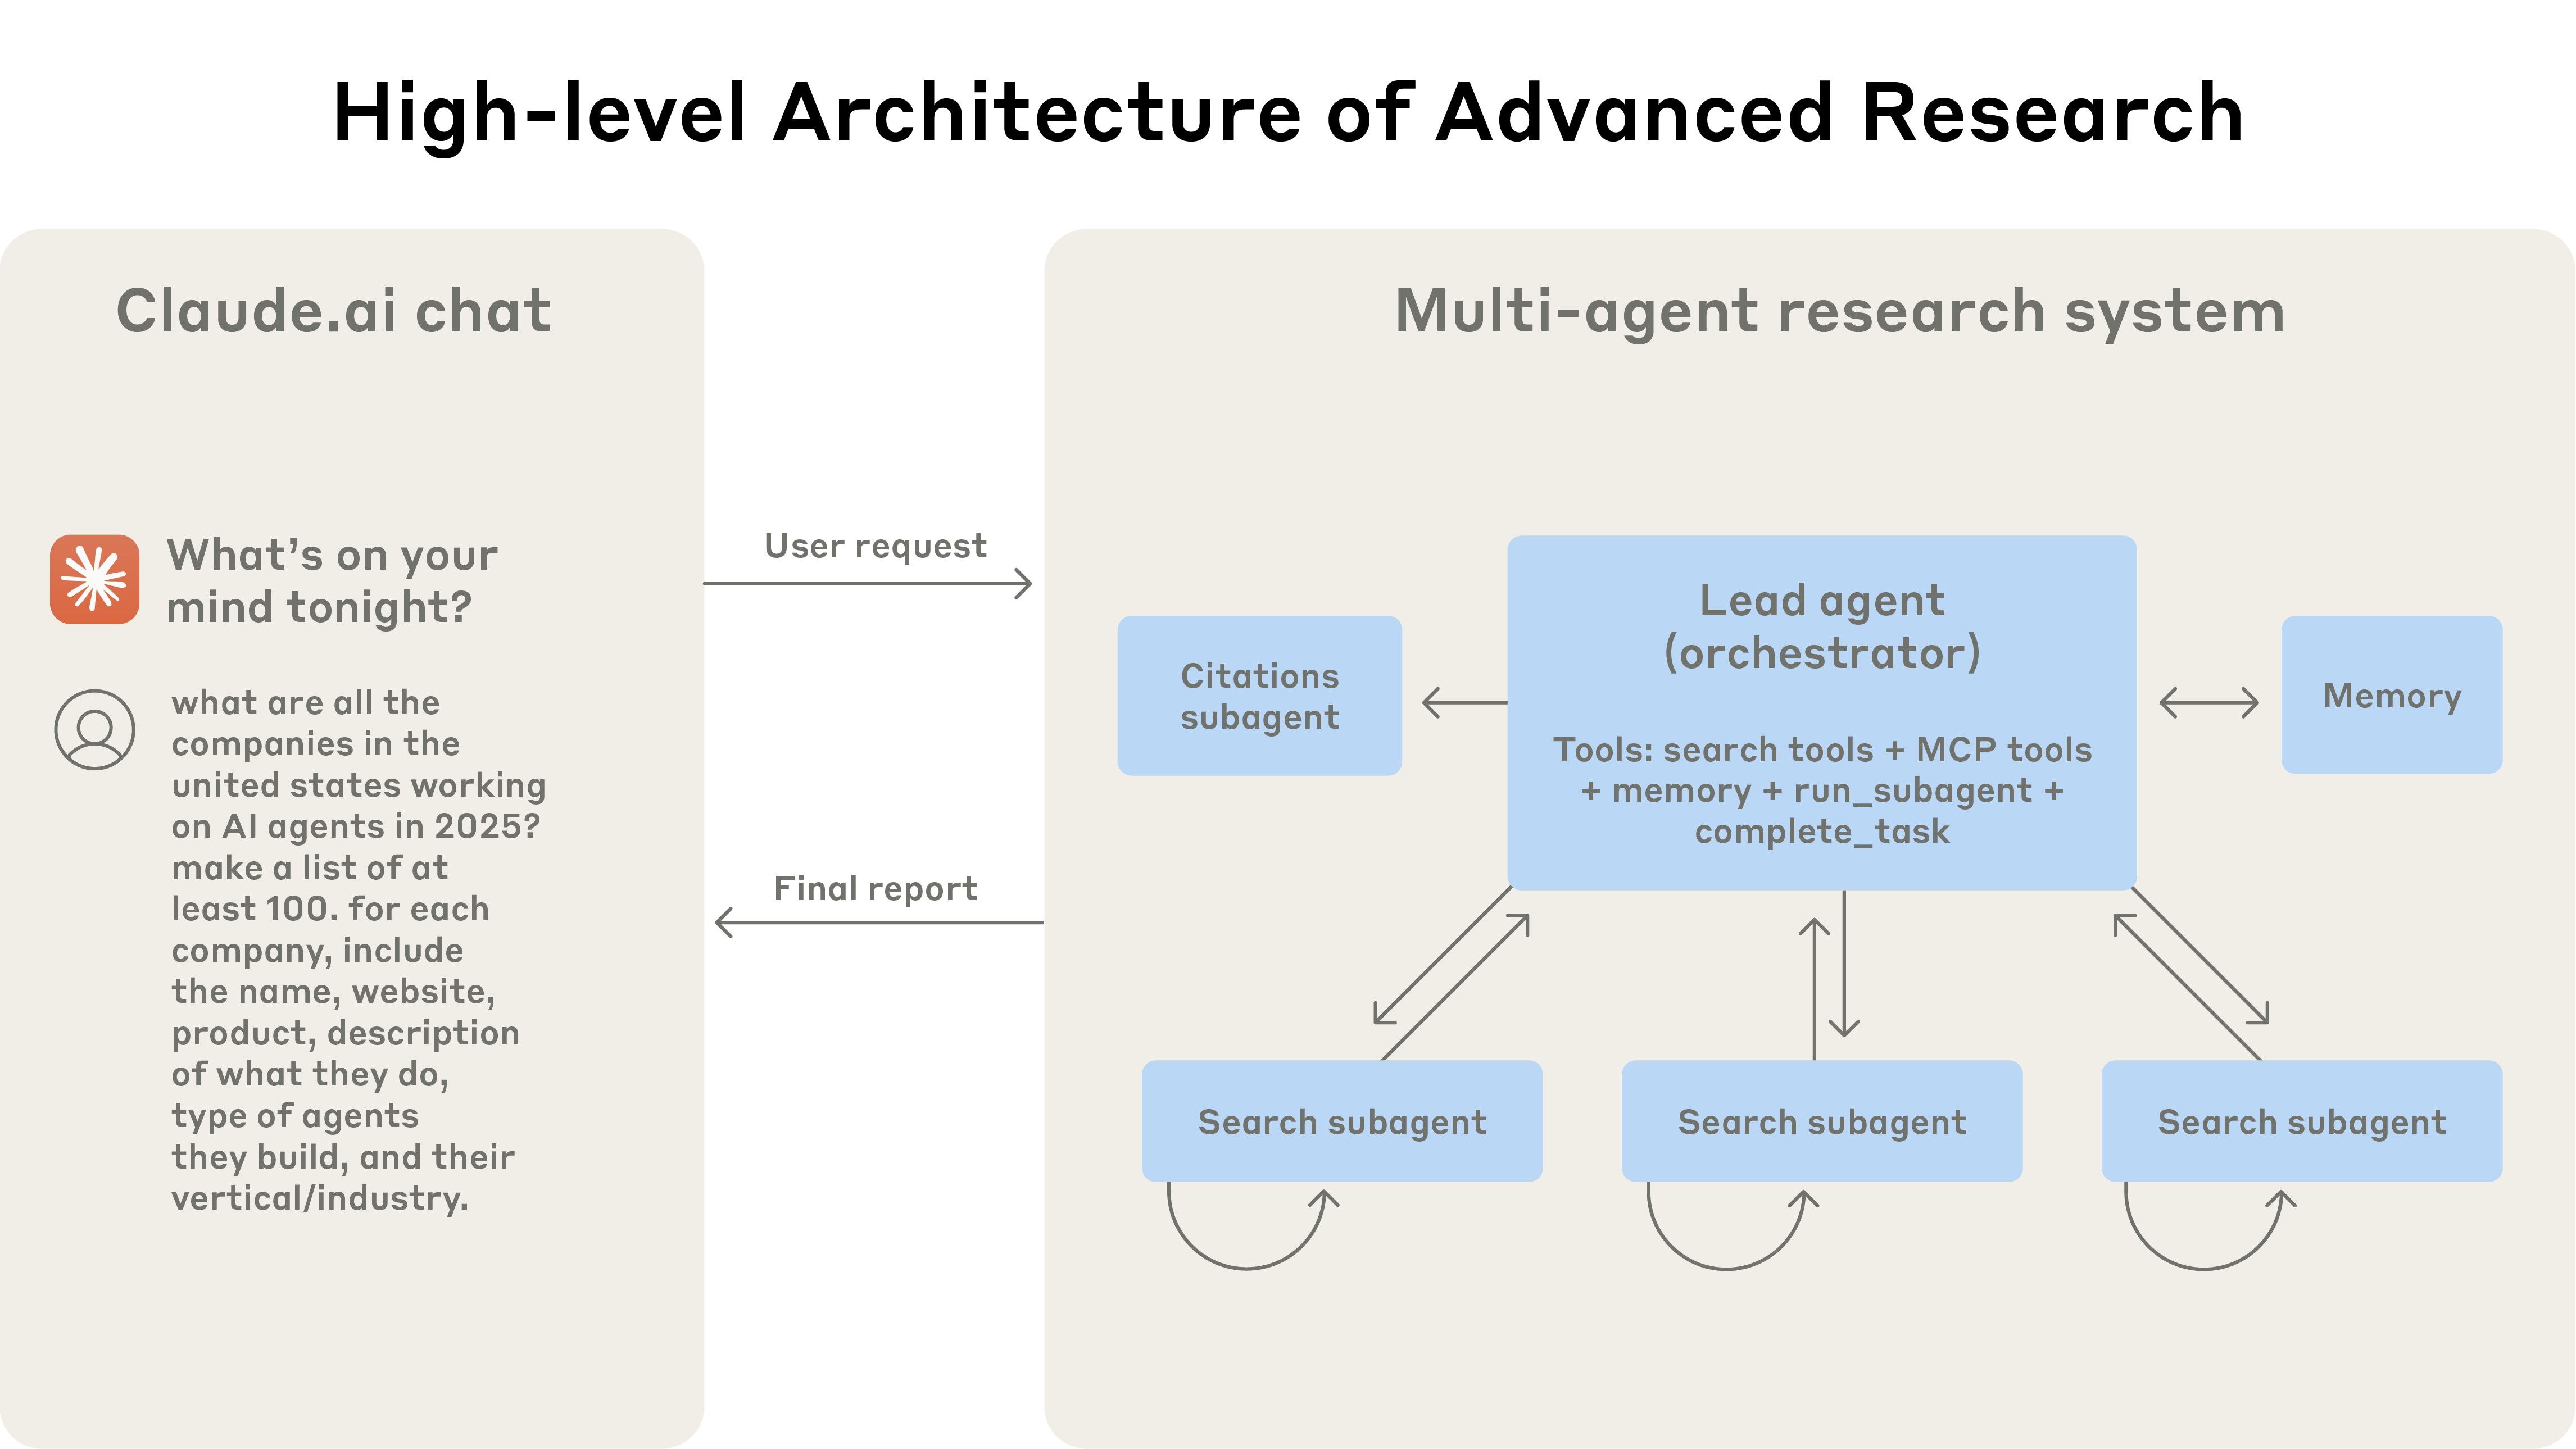
이 구조가 강한 이유는 단순히 “에이전트를 많이 쓴다”가 아닙니다. 각 에이전트가 서로 다른 길을 걸어가며 정보를 줄여 오기 때문입니다. 넓은 정보 공간을 한 사람이 순서대로 훑는 것보다, 여러 사람이 나눠 보고 핵심만 모으는 쪽이 빠르고 정확한 상황이 있습니다.
성능은 좋아지지만 비용도 같이 커진다
Anthropic 내부 평가에서는 Claude Opus 4 리드 에이전트와 Claude Sonnet 4 하위 에이전트 조합이 단일 Opus 4보다 연구 평가에서 90.2% 더 높은 성능을 보였다고 합니다. 특히 여러 방향을 동시에 확인해야 하는 breadth-first 리서치에서 효과가 컸습니다.
하지만 여기에는 현실적인 비용이 붙습니다. Anthropic에 따르면 일반 에이전트는 채팅보다 약 4배, 멀티 에이전트 시스템은 채팅보다 약 15배 많은 토큰을 사용합니다. 그래서 단순 사실 확인이나 짧은 요약에 이 구조를 쓰면 낭비가 됩니다.
좋은 멀티 에이전트 시스템은 에이전트를 많이 띄우는 시스템이 아닙니다. 병렬화할 가치가 있는 작업인지 먼저 판단하고, 필요한 만큼만 나누는 시스템입니다.
프롬프트는 명령문보다 협업 설계에 가깝다
흥미로운 부분은 실패 사례입니다. 초기 시스템은 단순 질문에도 50개 하위 에이전트를 만들거나, 존재하지 않는 출처를 끝없이 찾거나, 여러 에이전트가 같은 검색을 반복하는 문제가 있었다고 합니다.
Anthropic은 이를 프롬프트와 도구 설계로 줄였습니다. 질문 복잡도에 따라 에이전트 수와 도구 호출 예산을 정하고, 하위 에이전트마다 목표·출력 형식·검색 범위·중단 조건을 명확히 준 것입니다.
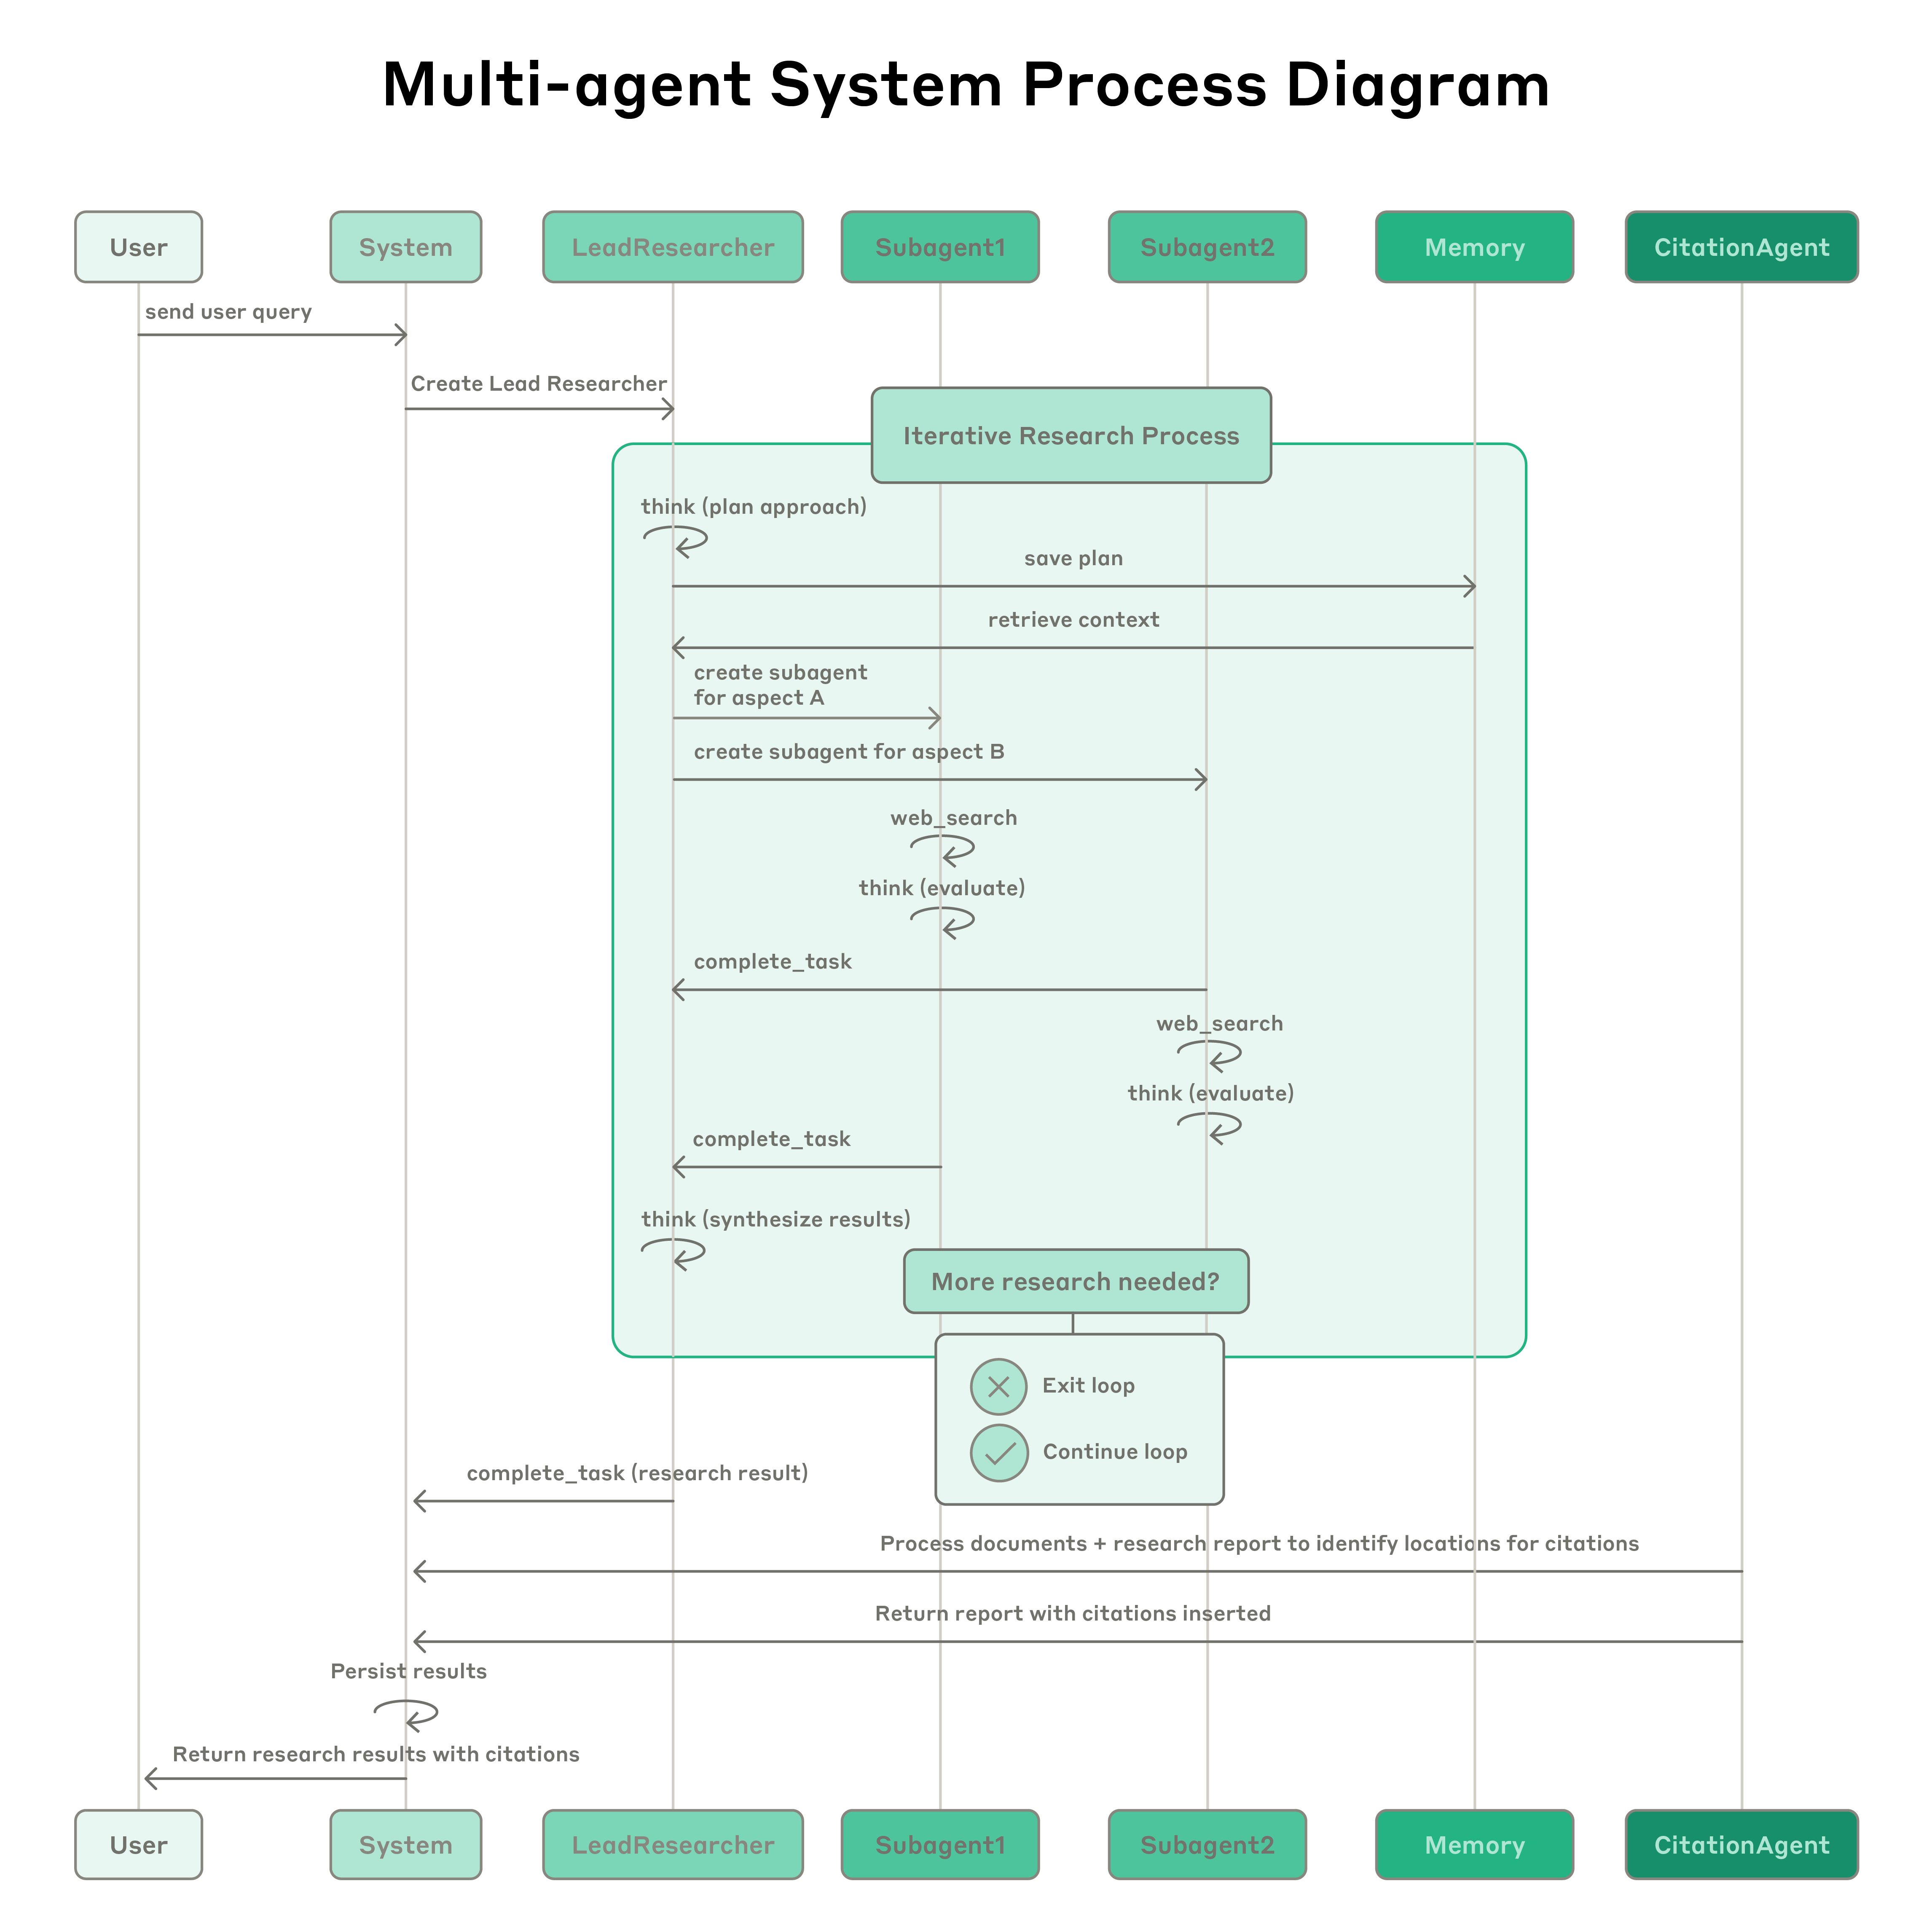
여기서 배울 점은 큽니다. 에이전트에게 “잘 조사해”라고 말하는 것과 “이 범위에서, 이 도구로, 이 형식으로, 충분하면 멈춰라”라고 말하는 것은 완전히 다릅니다. 멀티 에이전트의 품질은 모델 지능뿐 아니라 업무를 나누는 방식에서 결정됩니다.
우리 시스템에 적용하면 좋은 점
TechLLM/OpenClaw/Blogger에도 바로 연결됩니다. 복잡한 글쓰기나 리서치는 리드 플래너가 방향을 잡고, 수집 에이전트가 독립적으로 자료를 모으고, 리뷰어가 사실성·출처·문체를 확인하는 구조가 잘 맞습니다. 우리가 쓰는 랍스터식 Plan → Work → Review 흐름도 같은 철학입니다.
다만 모든 작업을 무조건 멀티 에이전트로 만들 필요는 없습니다. 짧은 SNS 문구, 단순 수정, 이미 출처가 명확한 요약은 단일 에이전트가 빠릅니다. 반대로 시장 조사, 기술 트렌드 분석, 여러 논문 비교, 복잡한 원문 기반 글쓰기는 멀티 에이전트가 빛납니다.
결론적으로 멀티 에이전트의 핵심은 “많이 시키기”가 아니라 “잘 나누기”입니다. 역할, 예산, 중단 조건, 검증 기준이 있을 때 여러 에이전트는 비용이 아니라 성능 확장 장치가 됩니다.