개요
2026년 6월, Anthropic이 생물학 연구자들과 함께 진행한 흥미로운 실험 결과를 공개했습니다. 주제는 단순합니다. “AI 에이전트는 생물학 데이터베이스에서 정말 일을 할 수 있는가?” 결론도 명료합니다. 지금 그대로는 어렵다는 겁니다. 같은 질문을 세 번 던지면 결과가 세 번 다르게 나옵니다. Anthropic은 이 문제를 측정하기 위한 벤치마크 VirBench를 만들고, 그 해법으로 결정론적 검색 계층 gget virus를 NCBI 연구자들과 함께 내놨습니다.
핵심 요약
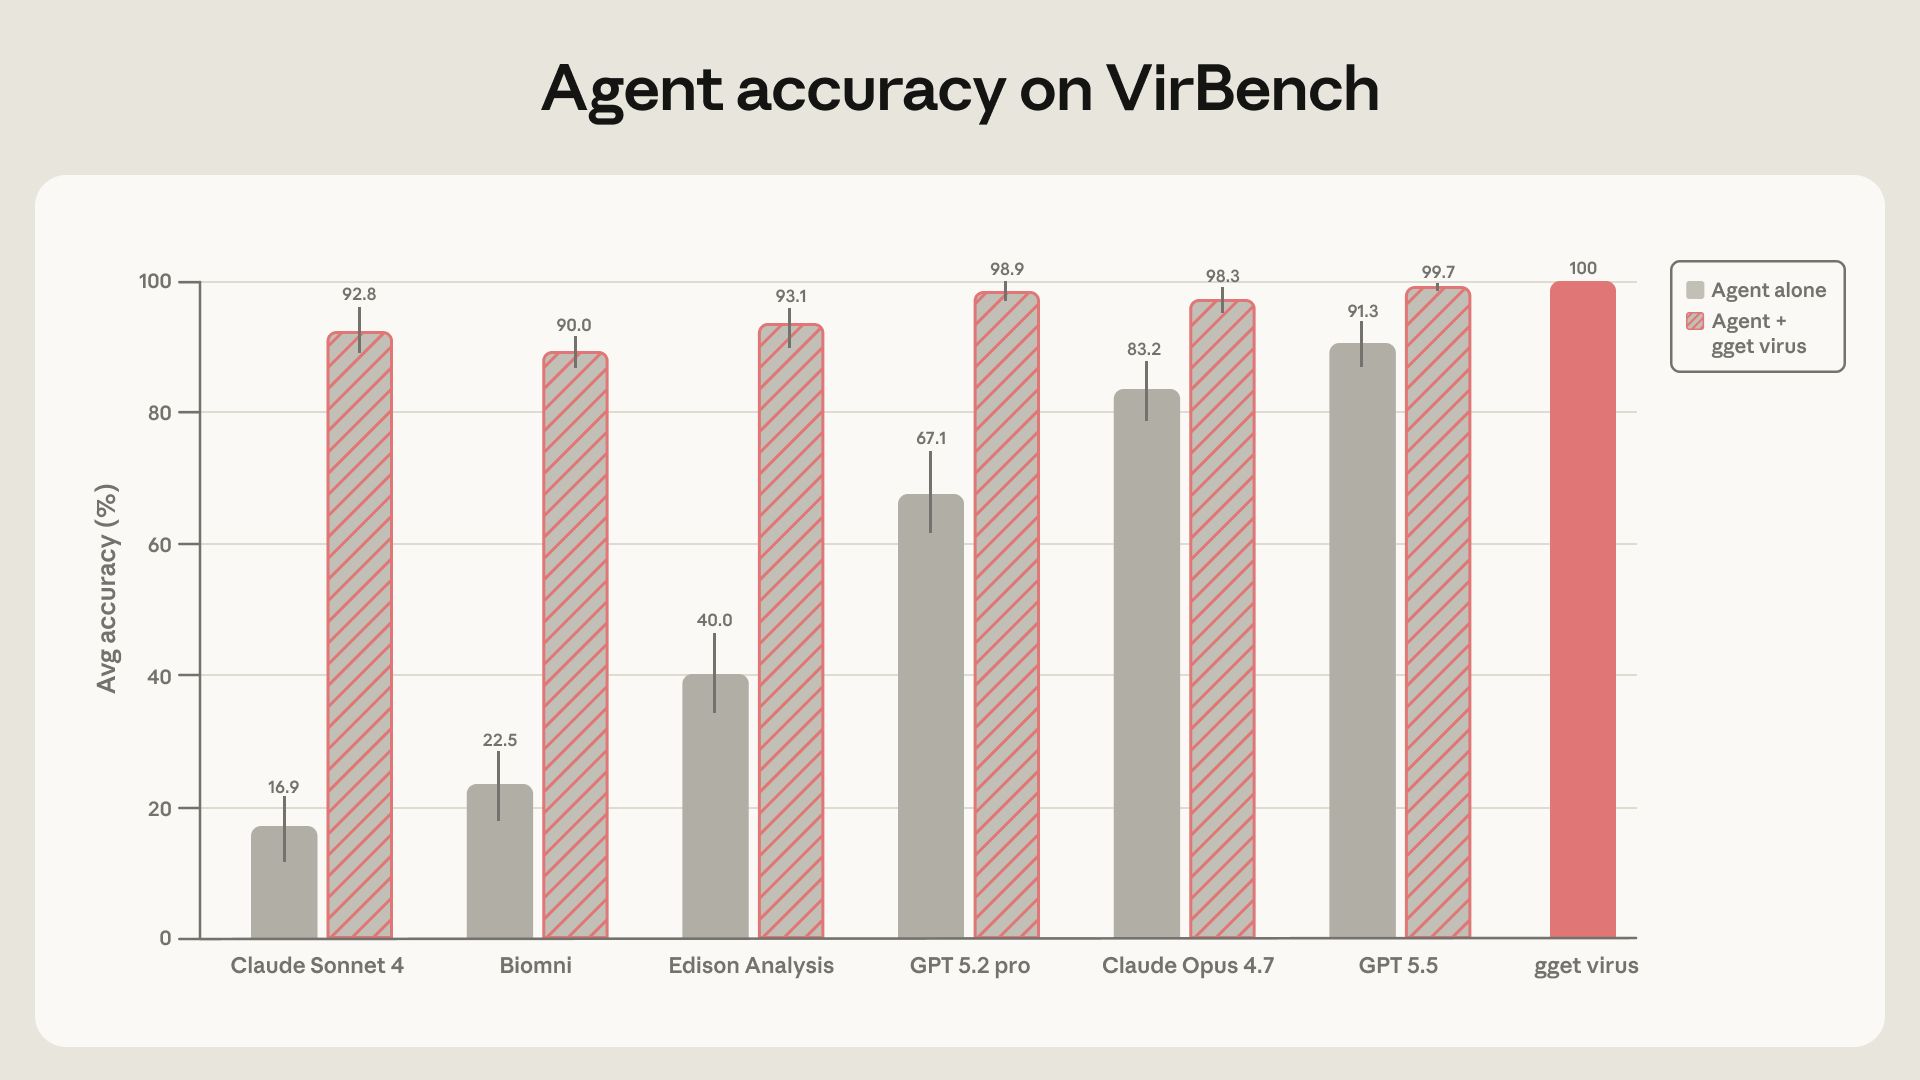
- 클로드, GPT, Biomni OSS, Edison Analysis 등 주요 에이전트의 바이러스 시퀀스 검색 정확도를 측정한 벤치마크 VirBench 공개.
- 전용 도구 없이는 정확도가 **16.9% ~ 91.3%**까지 들쭉날쭉. 같은 질문에 결과 수가 106개, 15개, 5개로 갈리는 사례도 있었음.
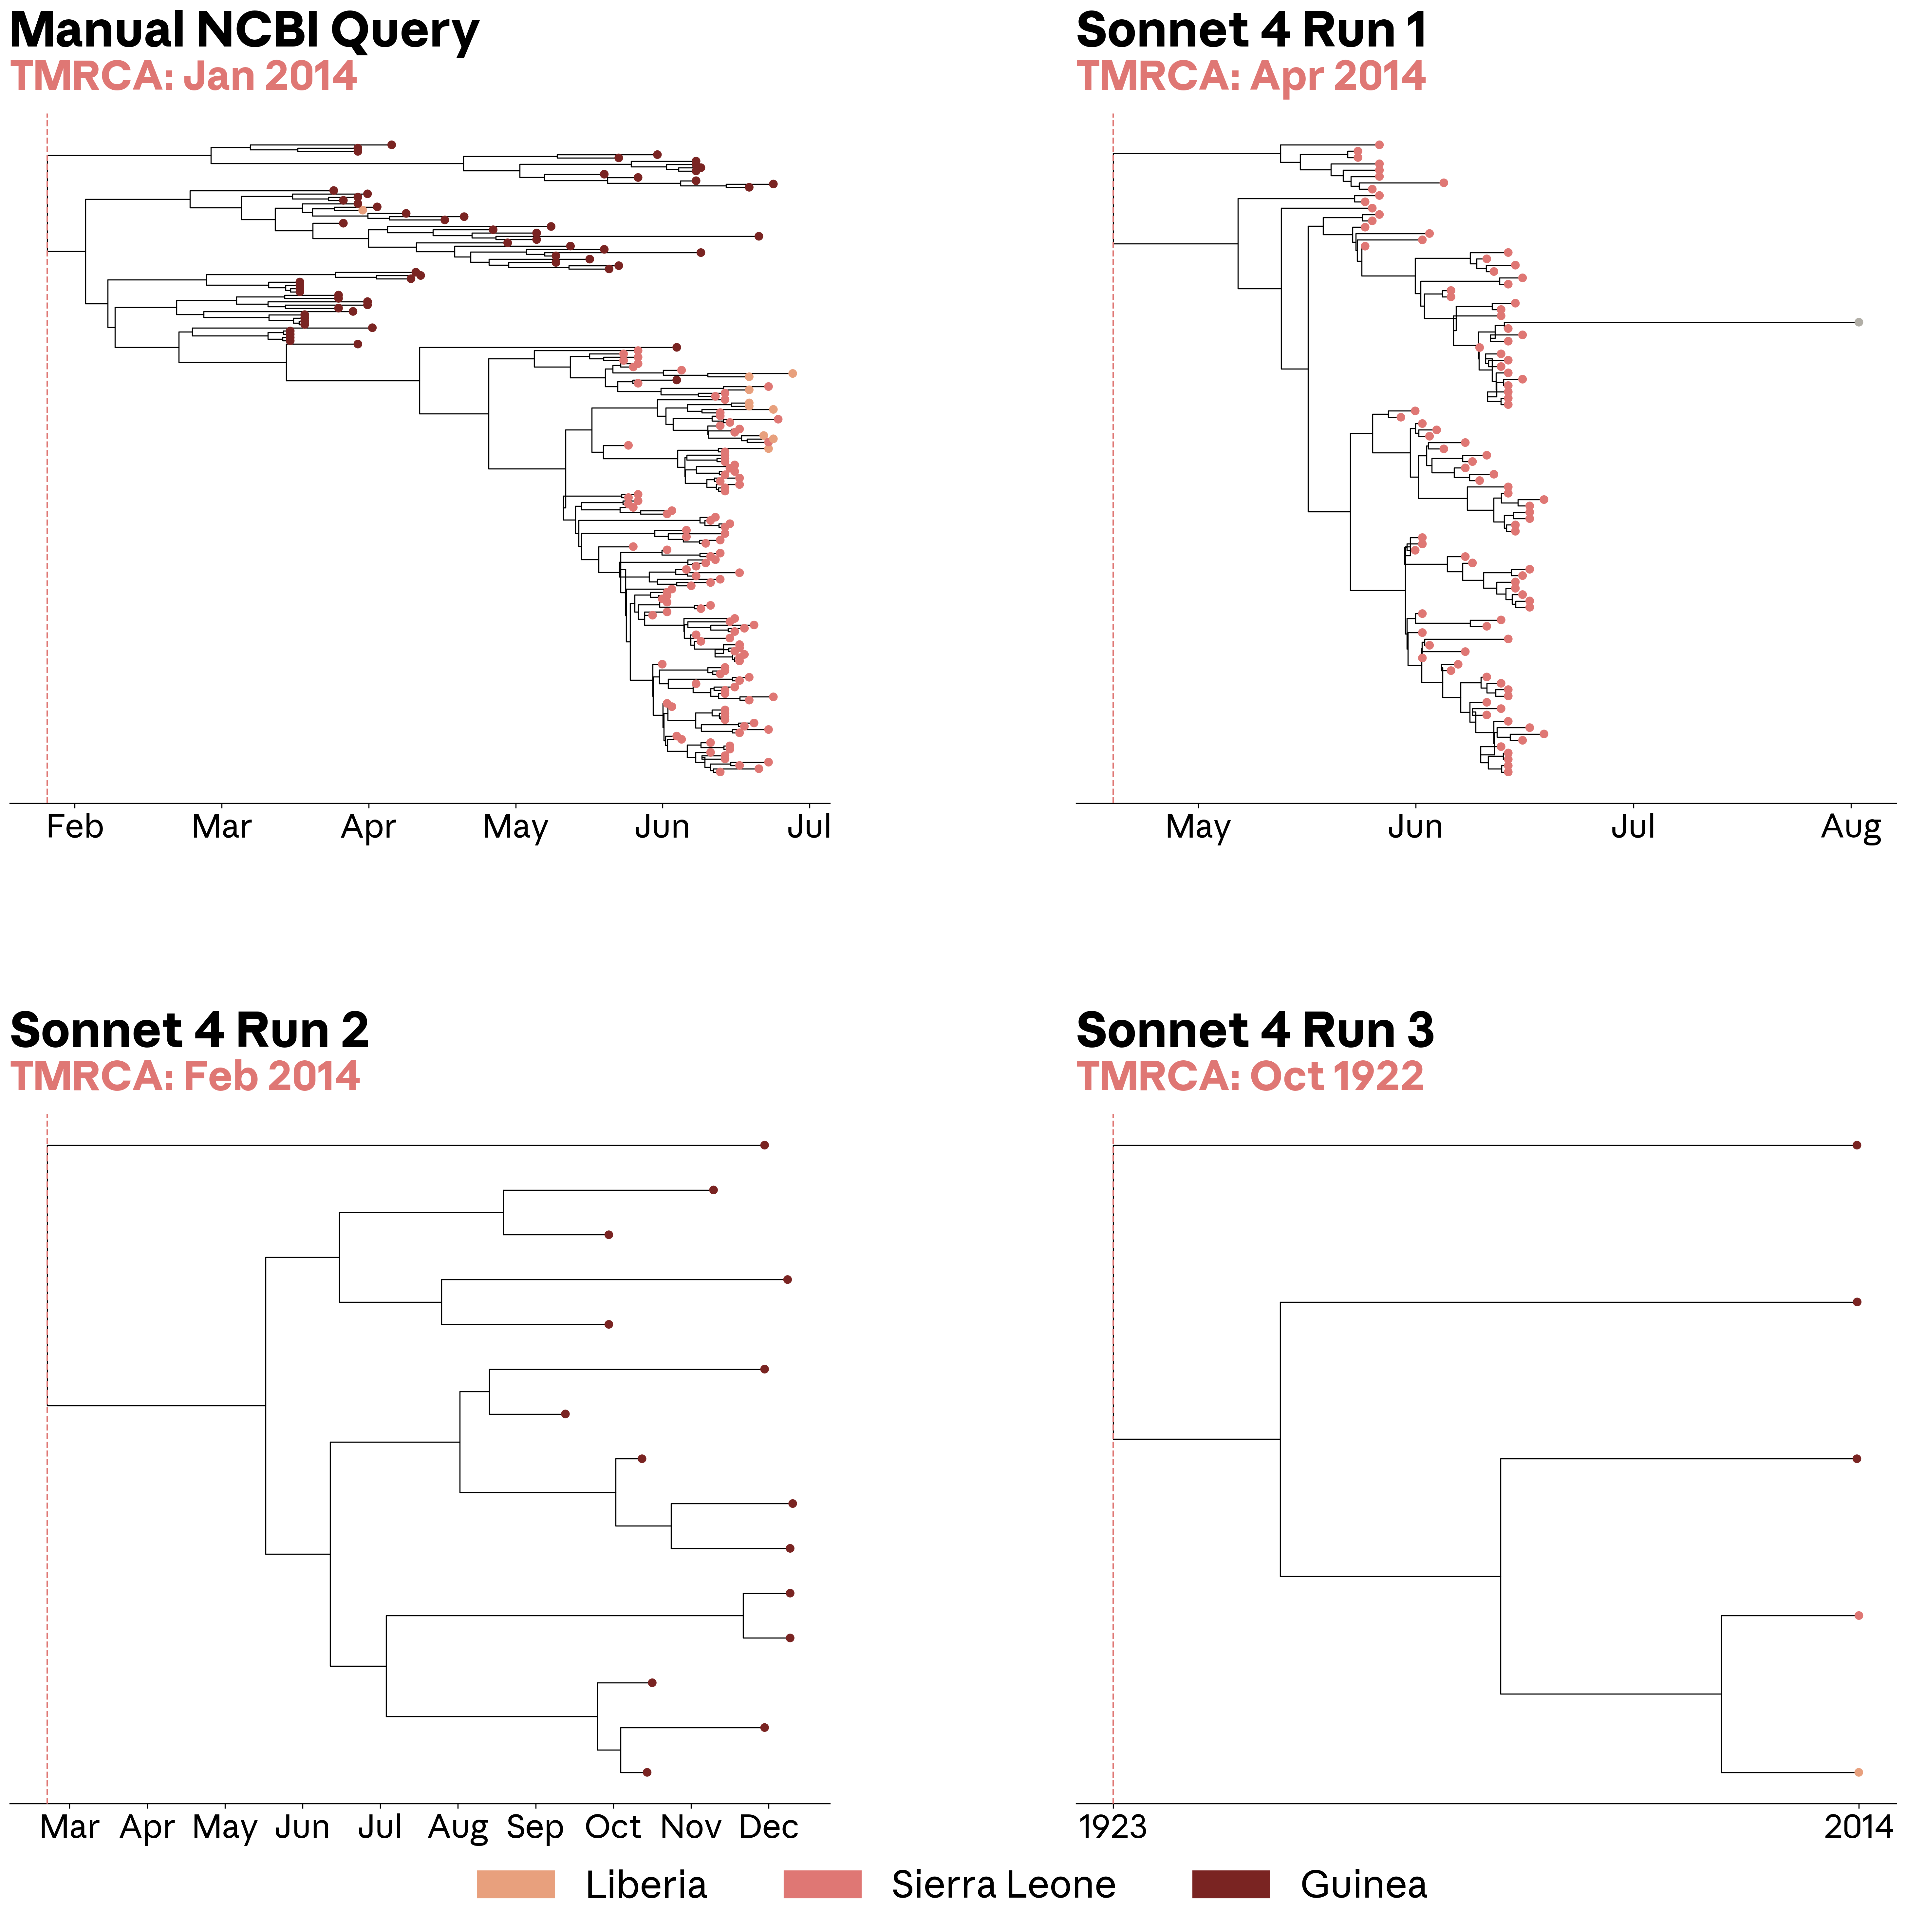
- 검색 오류가 그대로 생물학적 결론으로 번짐. 자이르 에볼라바이러스 계통수에서 TMRCA(가장 최근 공통조상 시점) 추정이 1922년~2014년 4월까지 흔들렸습니다(정답은 2014년 1월).
- 해법은 모델을 키우는 게 아니라 도구를 결정론적으로 만드는 것. NCBI와 함께 개발한 gget virus를 붙이자 모든 에이전트가 정확도 90% 이상, GPT-5.5는 **99.7%**까지 올라갔습니다.
본문
오래된 도시에 자동차를 들이는 일
연구를 이끈 Laura Luebbert는 비유 하나로 문제를 요약합니다. “AI 에이전트로 생물학 데이터 인프라를 다루는 건, 자동차가 등장하기 전에 설계된 옛 도시에서 운전하는 것과 비슷하다.” 골목길은 아름답지만, 자동차에는 맞지 않습니다.
NCBI, Ensembl, UniProt 같은 데이터베이스는 수십 년에 걸쳐 사람이 브라우저로 클릭해 가며 쓰던 방식에 맞춰 굳어져 있습니다. 포맷이 제각각이고, 같은 데이터를 받는 길도 여러 갈래입니다. 사람은 그 사이에서 적당히 판단하지만, AI 에이전트는 그렇지 못합니다.
같은 질문, 매번 다른 답
Anthropic 팀은 이걸 정량적으로 보여주려고 VirBench를 만들었습니다. NCBI Virus에서 바이러스 시퀀스를 가져오는 과제를 던지고, 주요 에이전트의 답이 정답과 얼마나 맞는지 측정했습니다.
결과는 솔직히 충격적입니다. 모델에 따라 정확도가 16.9%부터 91.3%까지 벌어졌습니다. 더 큰 문제는 일관성입니다. 같은 질문을 같은 모델에 세 번 던졌더니 결과가 106개, 15개, 5개로 다르게 나왔습니다. 어느 게 진짜인지 확인하려면 사람이 결국 검증해야 합니다.
오류는 그대로 결론으로 흘러갑니다
검색이 흔들리면 분석이 흔들립니다. 팀은 2014년 서아프리카 에볼라 유행을 재현해 봤습니다. 진짜 데이터로 계통수를 그리면 가장 최근 공통조상 시점(TMRCA)이 2014년 1월 즈음으로 나옵니다. 에이전트가 검색해 온 데이터셋으로 같은 분석을 돌리니, TMRCA가 1922년부터 2014년 4월까지 종잡을 수 없이 흩어졌습니다. 거의 한 세기 차이입니다.
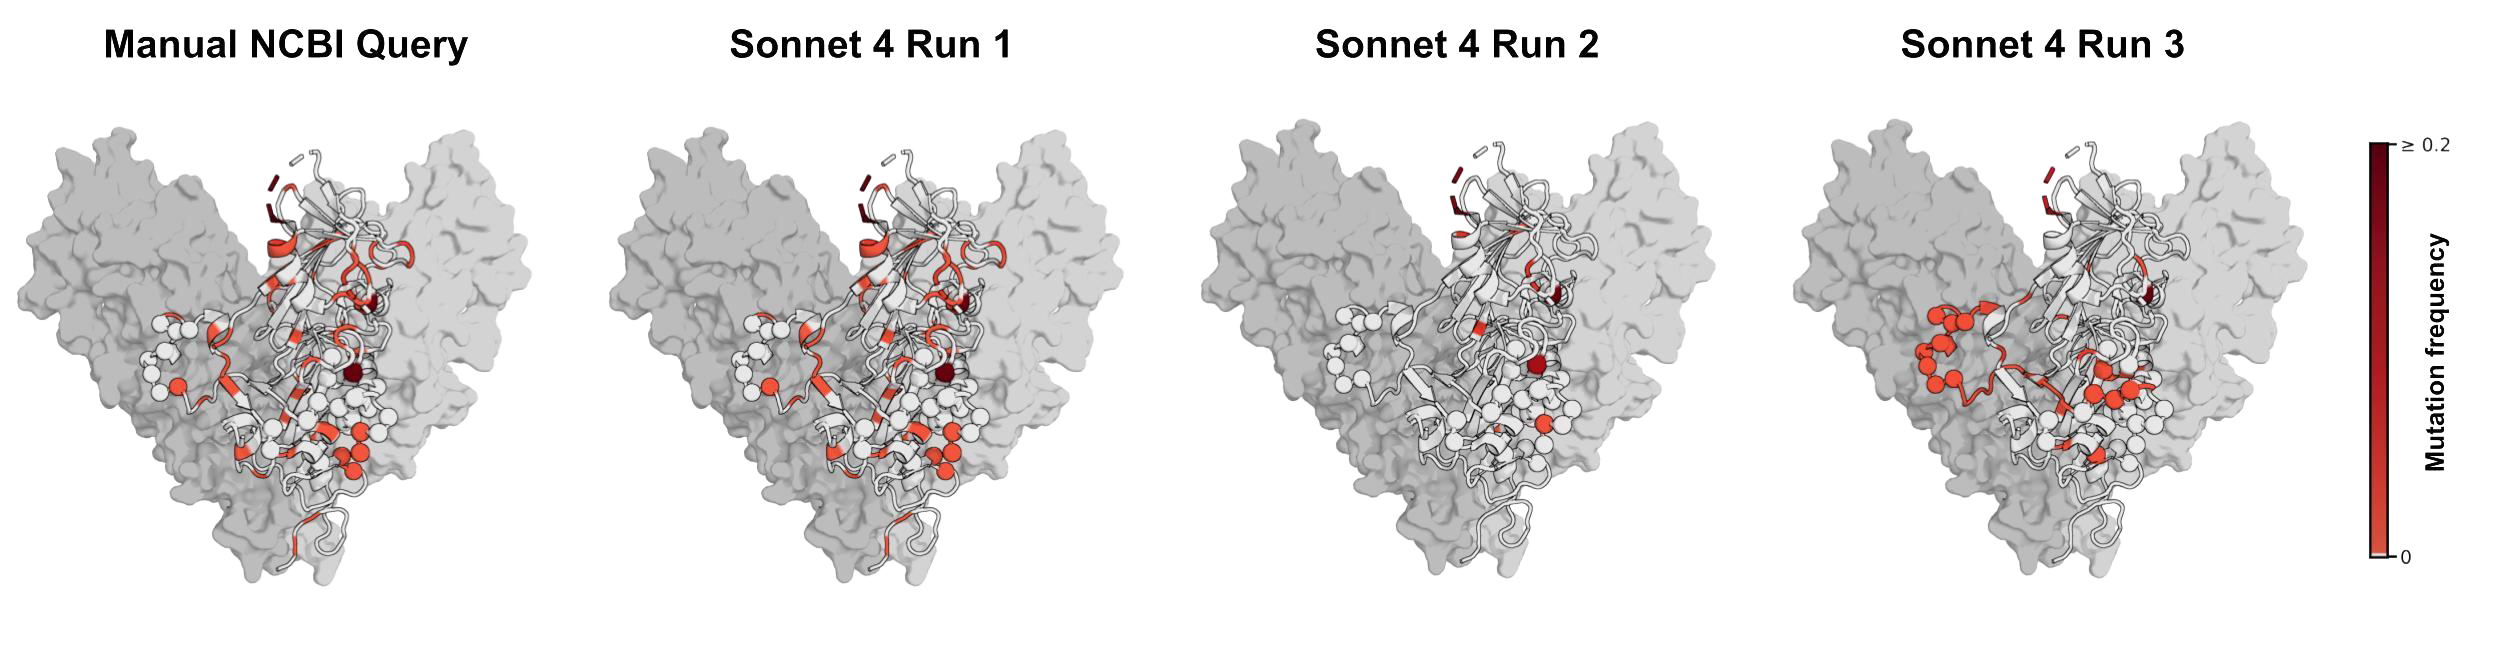
에피토프 분석도 마찬가지였습니다. 에볼라 치료제 후보인 maftivimab과 MBP134가 표적으로 삼는 당단백질 위치에 어떤 돌연변이가 쌓여 있는지 봐야 했는데, 에이전트 실행마다 변이 패턴이 다르게 그려졌습니다. 약효를 평가하는 자리에서 이런 차이는 치명적입니다.
배경에는 실제 위기가 있었습니다. 2026년 5월 콩고민주공화국에서 분디부교 바이러스 발병이 시작됐고, 5월 29일 기준 WHO는 확진·의심 사례 1,000건과 사망 200건 이상을 보고했습니다. 연구자들은 시퀀스를 빠르게 받아 과거 데이터와 비교해야 했습니다. 그런데 도구가 못 따라가는 상황이었던 겁니다.
모델을 키우지 말고 도구를 다듬어라
Anthropic이 NCBI와 함께 내놓은 답은 gget virus입니다. REST, Datasets, E-utilities 같은 여러 API를 한 겹 위에서 조율해 주는 결정론적 검색 계층입니다. 큰 데이터(SARS-CoV-2, 인플루엔자 A 등)는 배치로 끊어 받아오고, 단일 API로는 못 거는 필터를 대신 처리해 줍니다. 출력은 사람이 읽기에도, 모델이 다시 쓰기에도 깔끔한 표준 포맷이고, 로그가 함께 따라옵니다.
이걸 붙이자 결과가 확 바뀌었습니다. 모든 에이전트의 정확도가 90% 위로 올라갔고, GPT-5.5는 **99.7%**에 도달했습니다. 같은 질문에 같은 답이 나오는, 당연하지만 그동안 안 됐던 상태가 회복된 셈입니다.
Luebbert가 짚은 한 줄이 인상적입니다. “결정론적 검색 계층을 한 층 두면, 어떤 모델을 쓰느냐가 훨씬 덜 중요해진다.” 비싼 프런티어 모델을 안 써도 됩니다. 저렴한 모델에 좋은 도구를 붙이면 충분합니다.
컨텍스트 엔진이라는 새로운 층
연구 팀은 이 접근을 컨텍스트 엔진(context engine) 이라고 부릅니다. 사람을 위해 만들어진 인프라 위에, 에이전트가 안전하게 호출할 수 있는 한 겹의 결정론적 계층을 더 까는 일입니다. Andrej Karpathy가 웹에서 했던 비유와 닮았습니다. 브라우저 UI에 들러붙는 에이전트는 깨지기 쉽지만, 그 안의 데이터를 도구로 노출해 주면 안정적으로 동작합니다.
생물학 쪽에는 비슷한 시도가 이미 진행 중입니다. Harvard의 ToolUniverse, Edison Scientific의 Robin, Stanford 계열의 Biomni 같은 프로젝트들이 같은 방향을 보고 있습니다. Biopython, BioPerl, Entrez Direct, BioMart 같은 기존 도구들도 재해석 대상입니다. 이번 gget virus는 그중 가장 구체적이고 검증 가능한 한 발입니다.
실무자가 볼 핵심 포인트
- 에이전트 신뢰성은 모델보다 도구에서 옵니다. 검색·조회 같은 단계는 결정론적으로 만들 수 있다면 무조건 그렇게 하는 게 좋습니다. 같은 입력에 같은 출력이 보장되어야 윗단의 추론을 신뢰할 수 있습니다.
- 벤치마크가 없으면 개선도 없습니다. VirBench처럼 도메인 특화 평가셋을 먼저 만드는 게 시작점입니다. “정확도 17% vs 99.7%” 같은 숫자가 있어야 의사결정이 됩니다.
- 사람용 UI를 그대로 두고 에이전트용 계층을 따로 까는 것이 현실적인 길입니다. 기존 인프라를 다 갈아엎을 수 없으니, gget 같은 어댑터 한 겹으로 풀어내는 패턴을 기억해 둘 만합니다.
- 저렴한 모델 + 좋은 도구의 조합이 더 강할 수 있습니다. 비용·접근성·재현성 측면에서 의미 있는 결과입니다. 사내 에이전트 설계에서도 모델 업그레이드보다 도구 정비를 먼저 검토해 볼 가치가 있습니다.
- 결과의 변동성 자체를 지표로 잡아야 합니다. 정확도뿐 아니라 실행 간 분산(같은 질문에 답이 얼마나 흔들리는지)을 같이 측정해야 실서비스에 올릴지 판단할 수 있습니다.