핵심 요약
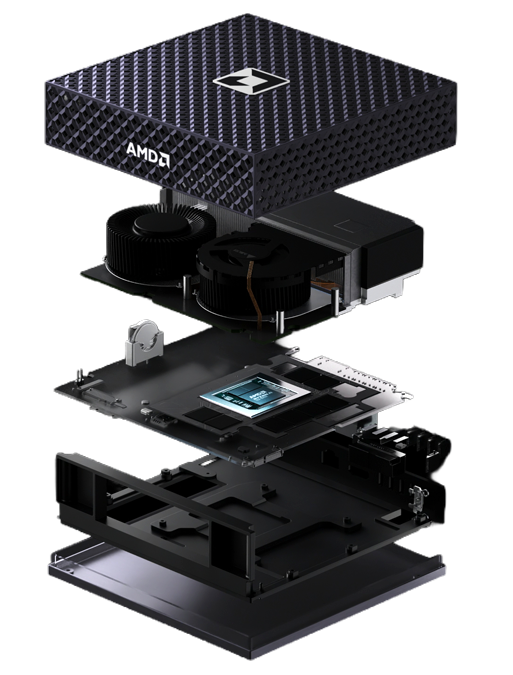
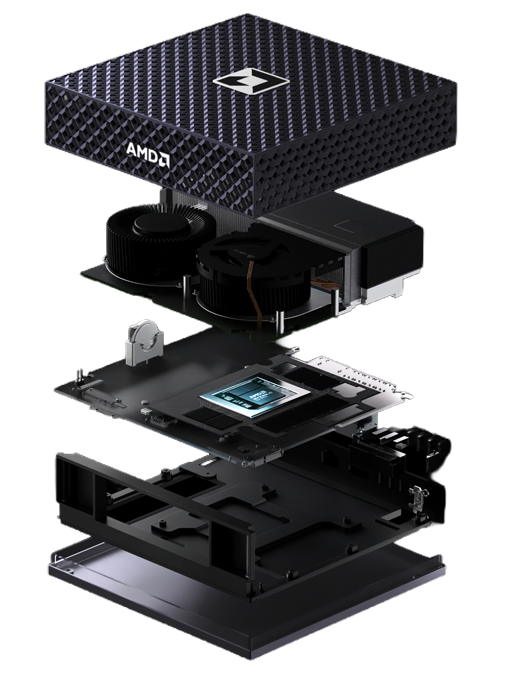
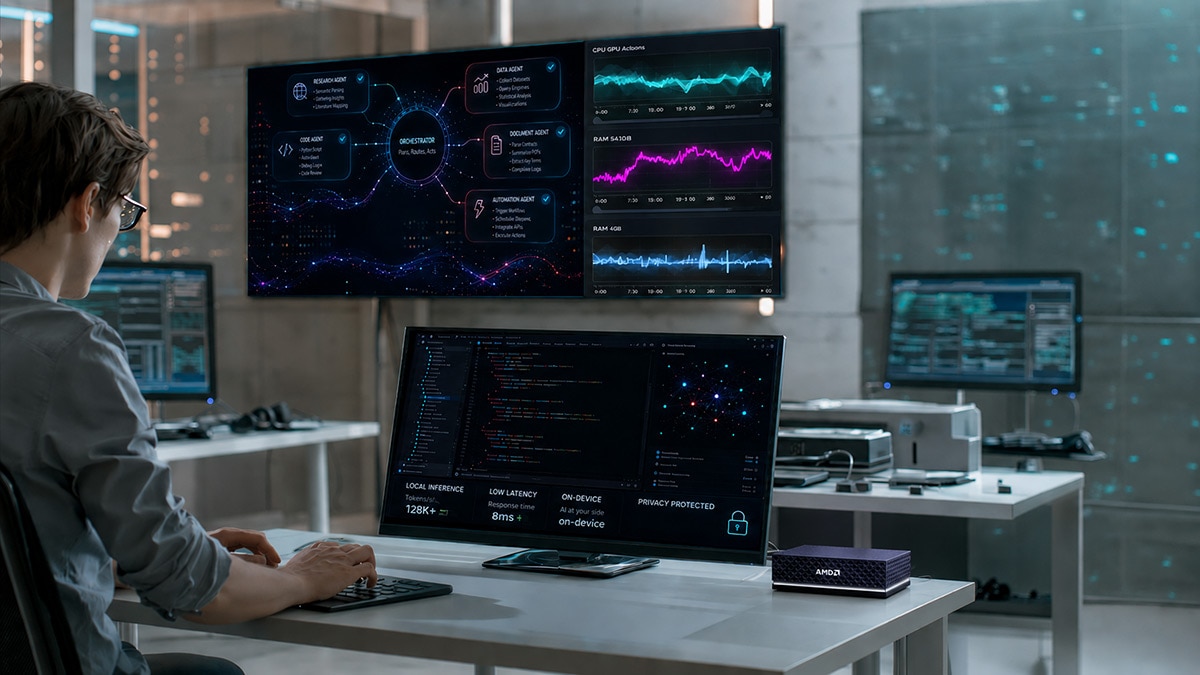
- AMD가 로컬 AI 개발 전용 박스 라이젠 AI Halo를 공개했다. 라이젠 AI Max+ 395 프로세서에 128GB LPDDR5x 통합 메모리, 50 TOPS NPU를 묶은 구성이다.
- 메모리 한 덩어리에 모델을 통째로 올릴 수 있어 최대 200B 파라미터 모델까지 로컬 추론이 가능하다고 AMD는 명시한다.
- 가격은 3,999달러. 4,699달러인 NVIDIA DGX Spark보다 700달러 싸고, 윈도우와 리눅스를 둘 다 지원한다.
- 자체 측정 기준 이미지 생성 워크로드에서 애플 M4 Pro 대비 3.3~7.3배 빠르고, DGX Spark 대비 LLM 토큰 처리량은 4~14% 우위라고 주장한다.
- AMD ROCm 소프트웨어와 Ollama·LM Studio·vLLM·PyTorch·LoRA/QLoRA 같은 오픈 생태계가 사전 설치돼 있다.
- 192GB 메모리를 탑재한 라이젠 AI Max+ PRO 495 상위 모델도 곧 출시 예정이다.
라이젠 AI Halo가 무엇인가
라이젠 AI Halo는 AMD가 “전원을 켜고 몇 분 안에 토큰을 뽑을 수 있다"는 것을 목표로 만든 로컬 AI 개발자 박스입니다. 칩 하나에 CPU, GPU, NPU가 통합돼 있고, 메모리는 한 덩어리로 묶인 128GB 통합 메모리입니다. 가장 큰 의미는 이 메모리 구조에 있습니다. GPU VRAM 24GB, 시스템 RAM 64GB 같은 분리 구조가 아니라 통합 메모리 한 풀로 동작하기 때문에, 거대한 모델을 굳이 잘게 쪼개거나 오프로딩 트릭을 쓸 필요 없이 그대로 올릴 수 있습니다.
AMD가 강조하는 숫자는 단순합니다. 128GB 통합 메모리, 60 FP16 TFLOPS GPU, 50 TOPS NPU, 최대 200B 파라미터 모델 지원. 개인 개발자가 책상 위에 두고 LLM 추론과 가벼운 파인튜닝을 함께 돌리기에 부족하지 않은 구성입니다.
가격과 경쟁 구도 — NVIDIA DGX Spark와의 정면승부
라이젠 AI Halo가 던진 진짜 메시지는 가격표에 있습니다.
| 항목 | AMD 라이젠 AI Halo | NVIDIA DGX Spark |
|---|---|---|
| 가격 | 3,999달러 | 4,699달러 |
| 통합 메모리 | 128GB LPDDR5x | 128GB LPDDR5x |
| OS 지원 | 윈도우 + 리눅스 | 리눅스 전용 |
| NPU | 50 TOPS | 없음 |
| 달러당 LLM 토큰 처리량 | 우위 | 열위 |
AMD가 5월 기준 자체 측정한 결과로는, GPT-OSS 120B에서 +7%, GLM 4.7 Flash-30B에서 +14%, Qwen 3.5-122B에서 +12% 만큼 DGX Spark보다 토큰 생성 속도가 빠릅니다. 차이 자체는 크지 않지만, “동급 또는 약간 빠른데 700달러 싸고 윈도우도 된다"는 조합이 핵심입니다. 일반 개발자에게 리눅스 전용 박스를 강요하지 않는다는 점이 특히 큽니다.
이미지 생성에서는 애플 M4 Pro와 격차가 크다
LLM 영역에서는 NVIDIA와 박빙이지만, 이미지·비디오 생성처럼 GPU 연산이 무거운 워크로드에서는 격차가 확 벌어집니다. AMD가 ComfyUI 0.8.36 기본 템플릿으로 측정한 결과는 다음과 같습니다.
- Ace Step 1.5 → 최대 3.3배 빠름
- Ace Step 1.5 XL → 최대 7.3배 빠름
- Flux Schnell → 최대 3.8배 빠름
- Flux 2. Klien → 최대 4.0배 빠름
- Hunyuan 3D 2.1 → 최대 4.9배 빠름
- Qwen Image → 최대 3.7배 빠름
- Qwen Image Edit → 최대 3.9배 빠름
- Stable Diffusion XL → 최대 4.5배 빠름
- Z Image Turbo → 최대 4.4배 빠름
비교 대상은 64GB 메모리를 단 애플 Mac mini M4 Pro입니다. 같은 책상용 박스끼리의 싸움이라고 보면 됩니다. 4~7배 격차는 라이젠 AI Halo가 통합 GPU를 단순 보조 수단이 아니라 본격적인 추론 엔진으로 설계했다는 신호입니다.
소프트웨어 — ROCm·Ollama·vLLM이 깔린 채로 도착한다
하드웨어 사양만큼이나 중요한 부분이 소프트웨어 사전 설치입니다. AMD는 라이젠 AI Halo에 다음을 미리 깔아둡니다.
- AMD ROCm — 라이젠 AI Halo의 기반 AI 소프트웨어 스택. 윈도우·리눅스 양쪽 지원.
- 라이젠 AI Halo 개발자 센터 앱 — 플레이북, 도구, 업데이트를 한 곳에서 관리.
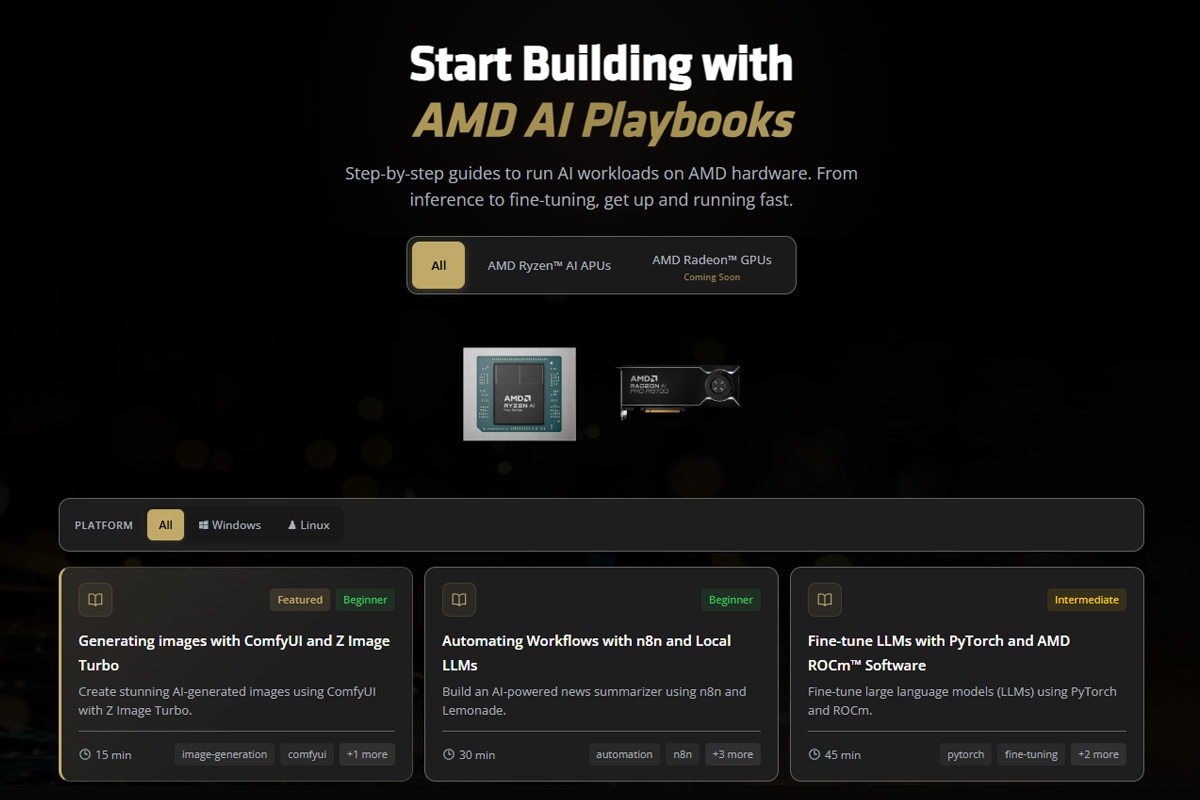
- AMD AI 플레이북 — 단계별 가이드. 초보부터 파인튜닝까지의 학습 경로.
- AMD Sync (출시 예정) — 다른 기기에서 라이젠 AI Halo를 모니터링·제어하고, 파일을 동기화하는 데스크톱 앱.
- 파트너 도구 패키지 — Ollama, LM Studio, vLLM, PyTorch, LoRA, QLoRA가 검증된 버전으로 동봉.
“환경 구성에 며칠을 쓰지 말고, 바로 모델을 돌려라"가 AMD의 마케팅 메시지입니다. 실제로 ROCm을 처음 설치해본 사람이라면 알겠지만, 드라이버·라이브러리·파이썬 환경을 직접 맞추는 일이 NVIDIA CUDA보다 손이 많이 갑니다. 이번에는 그 작업을 AMD가 공장에서 미리 해두고 출하한다는 뜻입니다.
클라우드 비용과 비교하면
3,999달러는 사실 무거운 금액이 아닙니다. 비교 대상은 클라우드 GPU 사용료입니다. H100 80GB 한 장을 시간당 2달러대로 빌린다고 가정하면, 매일 8시간씩 100일만 돌려도 1,600달러가 깨집니다. 추론 부하가 큰 사이드 프로젝트나 사내 도구라면 1년 안에 비용이 역전되는 시나리오가 충분히 나옵니다.
게다가 로컬 박스는 요청량이 늘어도 토큰당 추가 과금이 없다는 점이 큽니다. AMD가 마케팅 카피로 “예측 가능한 토큰당 비용"이라고 부르는 이유입니다. 클라우드는 사용량 폭증 시 청구서가 같이 폭증하지만, 라이젠 AI Halo는 전기료 정도가 변동비입니다.
물론 한계도 있습니다. 현재는 미국 내에서만 판매되며, 200B 파라미터까지 올라간다고는 해도 학습보다는 추론과 가벼운 파인튜닝에 더 적합한 구성입니다. 본격적인 사전학습은 여전히 데이터센터의 영역입니다.
Radeon 디스크리트 GPU와는 무엇이 다른가
AMD의 데스크톱 AI 카드라고 하면 보통 Radeon 디스크리트 GPU를 떠올리는데, 라이젠 AI Halo는 그것과는 결이 다른 제품입니다. Radeon은 게이밍과 그래픽 워크스테이션이 주된 시장이고, AI 추론은 별도 VRAM 안에 모델이 들어갈 때만 효과적입니다. 반면 라이젠 AI Halo는 처음부터 AI 개발자 전용 박스로 설계됐고, 통합 메모리 구조 덕분에 대형 모델을 통째로 메모리에 올릴 수 있습니다.
쉽게 말하면, Radeon RX는 게이머와 그래픽 프로의 카드이고, 라이젠 AI Halo는 모델을 직접 굴리는 AI 개발자의 박스입니다. 같은 회사 제품이지만 타깃이 분리돼 있습니다. AMD가 라이젠 AI Halo를 ROCm 우선 환경으로 출하한 것도 이 위치 분리를 의식한 결정으로 보입니다.
실무자가 볼 핵심 포인트
- 로컬 추론 박스를 진지하게 검토할 시점입니다. 4천 달러 미만으로 200B급 모델을 자기 책상에 두는 옵션이 생겼습니다. 사내 LLM POC, 사이드 프로젝트, 민감 데이터 처리에 첫 후보가 될 수 있습니다.
- 윈도우 지원이 의외로 큰 차이를 만듭니다. DGX Spark는 리눅스 전용입니다. WSL이나 듀얼 부팅 없이 윈도우 환경에서 바로 ROCm을 쓸 수 있다는 점은 일반 개발팀에 큰 매력입니다.
- ROCm 생태계가 사전 설치돼 출하됩니다. AMD GPU 설정에서 고생한 경험이 있다면, 이번에는 그 시간을 아낄 수 있습니다. Ollama·vLLM이 깔린 채로 도착합니다.
- 벤치마크는 AMD 자체 측정값이라는 점은 기억해두는 것이 좋습니다. 실측 리뷰가 나오면 다시 검증해야 합니다. 특히 NVIDIA DGX Spark 대비 4~14%라는 좁은 격차는 워크로드와 드라이버 버전에 따라 뒤집힐 여지가 있습니다.
- 현재 미국 내 판매입니다. 한국에서 바로 구매하려면 직구 또는 정식 유통 채널 발표를 기다려야 합니다. 192GB 메모리 PRO 495 모델 출시 일정과 한국 유통 일정을 같이 지켜볼 필요가 있습니다.
원문 출처
원문 보기 — AMD 공식 제품 페이지.