Allen Institute for AI(이하 Ai2)가 6월 12일 olmo-eval이라는 평가 워크벤치를 공개했습니다. 모델을 다 만든 다음 한 번 평가하는 도구가 아니라, 학습 중에 체크포인트가 쏟아질 때마다 같은 벤치마크를 빠르게 다시 돌리는 데 초점을 둔 도구입니다. 토대는 Ai2가 2024년에 내놓은 OLMES(Open Language Model Evaluation Standard)인데, 거기에 개발자가 매일 반복하는 평가 루프를 그대로 옮겨 담았습니다.
핵심 요약
- olmo-eval은 모델 개발 중간에 반복적으로 돌아가는 평가 루프를 위한 도구로, 2024년 OLMES 위에 얹은 워크벤치입니다.
- 태스크는 벤치마크 자체를 정의하고, 하니스는 실행 방식을 정의해 둘을 분리했습니다. 같은 태스크를 베이스라인으로도, 도구 사용 에이전트로도 같은 점수 체계로 비교할 수 있습니다.
- 가볍게 돌리는 것이 기본값이고, 코드 실행처럼 격리가 필요할 때만 컨테이너 샌드박스를 띄웁니다. Harbor와 가장 크게 갈리는 지점입니다.
- 실험 스키마와 결과 뷰어는 두 체크포인트의 문항을 한 줄씩 맞붙여 보여줍니다. 평균 점수의 작은 변화가 진짜 개선인지 노이즈인지 가려내기 위한 구조입니다.
- 코드는 GitHub
allenai/olmo-eval에서 공개됐고, 명령은olmo-eval run -m ... -t ... --harness ...한 줄로 끝납니다.
왜 또 다른 평가 도구가 필요했나
LLM을 개발해본 사람이면 평가가 한 번으로 끝나지 않는다는 걸 압니다. 데이터셋을 살짝 바꾸고, 하이퍼파라미터를 조정하고, 학습 길이를 늘립니다. 그때마다 벤치마크 구성도 따라 바꾸고, 새 체크포인트마다 다시 돌리고, 결과를 줄 세워 비교합니다. 이 과정을 매일 도는 팀에게는 평가 도구가 가볍고 빠르게 반복돼야 합니다.
Ai2는 이 지점을 그동안 OLMES로 채워왔습니다. 2024년에 공개된 OLMES는 모델 공개 사이의 점수 비교를 일관되게 하기 위한 표준이었고, Olmo와 Tulu 모델 평가에 그대로 쓰였습니다. olmo-eval은 OLMES의 점수 체계를 그대로 두고, 그 위에 평가 파이프라인을 다시 짠 결과물입니다.
Harbor와는 어떻게 다른가
비교 대상으로 자연스럽게 떠오르는 건 같은 Ai2의 Harbor입니다. Harbor는 모든 평가를 컨테이너로 봉인해 재현성을 끝까지 밀어붙입니다. 외부에 결과를 공개하는 벤치마크 운영에는 잘 맞지만, 매일 체크포인트를 돌리는 입장에서는 자원이 너무 무겁습니다.
olmo-eval은 반대 방향을 택했습니다. 기본은 가벼운 실행 모드입니다. 단순한 질의응답 같은 태스크는 컨테이너 없이 바로 돕니다. 코드 실행이나 격리된 환경이 필요한 벤치마크만 샌드박스를 띄웁니다. 둘 다 벤치마크와 실행 정책을 분리한다는 철학은 같지만, olmo-eval 쪽이 모듈 단위로 더 잘게 쪼개져 있습니다.
네 가지 구성 요소
올바른 그림을 갖기 위해서는 네 가지 구성 요소를 머릿속에 정렬해 두는 게 편합니다.
첫째, 태스크와 스위트, 하니스입니다. 태스크는 벤치마크 자체를 정의합니다. 스위트는 함께 돌릴 태스크 묶음입니다. 하니스는 각 태스크가 어떻게 실행될지를 결정합니다. 벤치마크 로직과 실행 정책을 떼어놓았기 때문에, 같은 태스크를 베이스라인으로 돌릴 수도 있고, 도구를 쥐여준 에이전트로 돌릴 수도 있습니다. 점수 채점은 그대로 둔 채 실행 환경만 바꿔 끼우는 식입니다.
둘째, 샌드박스와 역량 기반 라우팅 계층입니다. 비동기 샌드박스 플래너가 모델 응답이 도구 사용에 의존하는 평가를 책임집니다. 코드 실행이나 웹 브라우징 같은 진짜 도구를 굴리고, 그 결과를 다시 모델에 넘겨 다음 응답을 받습니다. 평가가 도구 사용을 모사가 아니라 실제로 측정한다는 뜻입니다.
셋째, 정규화된 실험 스키마입니다. 모든 실행과 설정, 결과를 일정한 형식으로 기록합니다. 관련 실험을 묶고, 체크포인트별 비교를 시간 축으로 늘어놓을 수 있어 장기 프로젝트에서 결과가 어긋나는 일을 줄입니다.
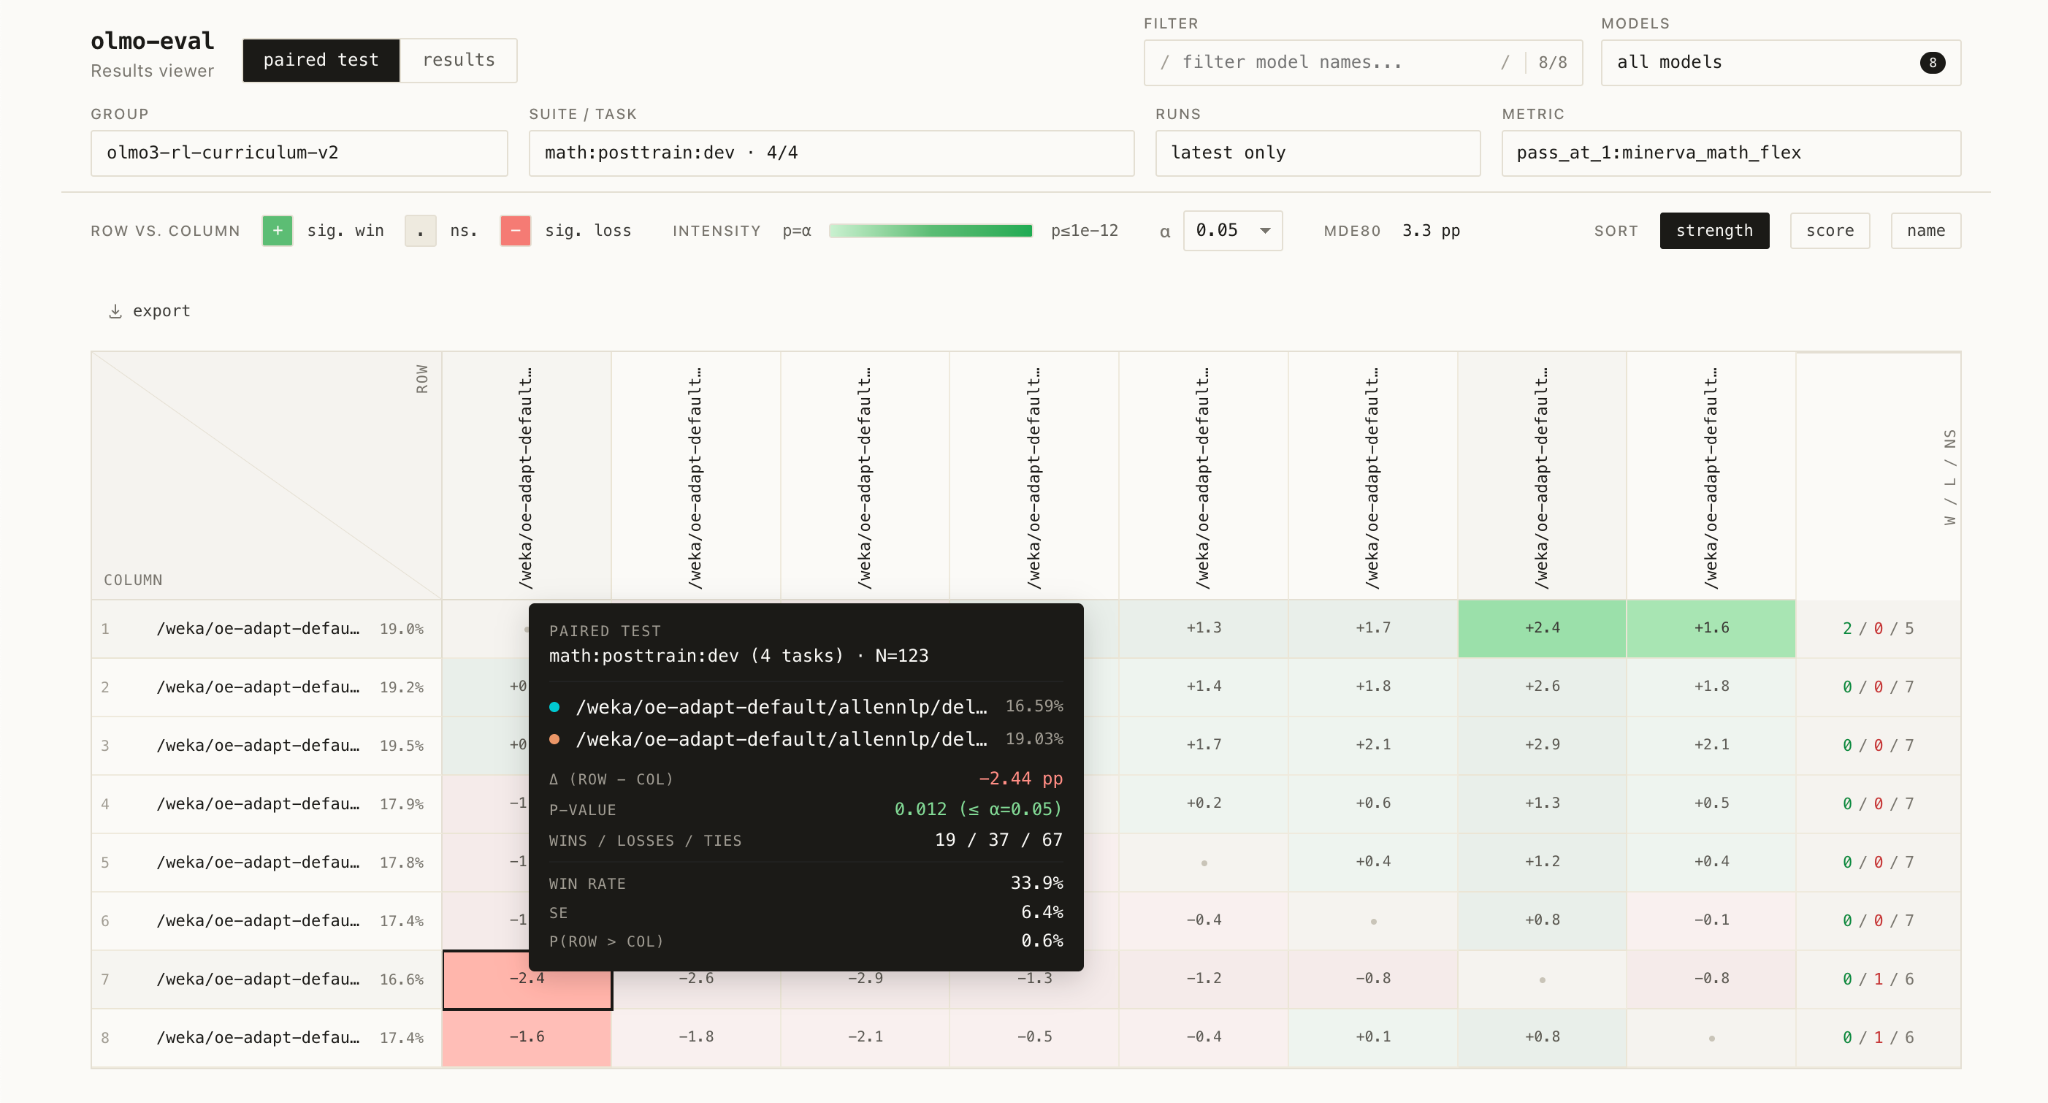
넷째, 문항 단위 비교 뷰어입니다. 두 체크포인트의 같은 문항을 옆에 두고 한 줄씩 맞춰 보여줍니다. 평균 점수만 보면 별 차이가 없어 보이는데, 문항별로 들여다보면 어디서 좋아지고 어디서 나빠졌는지가 한눈에 드러납니다.
코드로 보는 사용감
태스크 등록은 데코레이터 한 줄로 끝납니다. 데이터 소스, 포매터, 샘플링 파라미터, 메트릭을 클래스 속성으로 적어두는 구조입니다.
from olmo_eval.evals.tasks.common import Task, register

@register("internal_freshqa")
class InternalFreshQA(Task):
    data_source = DataSource(path="s3://evals/internal/freshqa.jsonl", split="test")
    formatter = ChatFormatter()
    sampling_params = SamplingParams(temperature=0.0)
    metrics = (AccuracyMetric(scorer=ExactMatchScorer),)
같은 태스크에 변형을 붙이고 싶을 때는 register_variant로 few-shot 수만 바꾸면 됩니다.
register_variant("internal_freshqa", "3shot", num_fewshot=3, fewshot_seed=1234)
register_variant("internal_freshqa", "zero", num_fewshot=0)
스위트는 태스크 이름 묶음입니다. sciq:mc:3shot처럼 변형 이름까지 같이 적습니다.
register(Suite(
    name="base_qa_few_shot",
    tasks=("sciq:mc:3shot", "arc_challenge:mc:3shot", "internal_freshqa:mc:3shot"),
))
실행은 한 줄입니다. 같은 태스크에 하니스만 갈아 끼우면 베이스라인과 검색 도구를 쓰는 에이전트를 동일한 점수표 위에서 비교할 수 있습니다.
olmo-eval run -m my-instruct-checkpoint -t internal_freshqa:zero
olmo-eval run -m my-instruct-checkpoint -t internal_freshqa:zero --harness search_agent
결과 비교가 정직해진다
평가 도구의 진짜 가치는 보고서 화면에서 드러납니다. olmo-eval은 각 점수에 표준 오차(standard error)와 최소 감지 가능 효과(minimum detectable effect)를 함께 표시합니다. 점수가 0.3 올랐다고 다 같은 0.3이 아니라는 사실을, 평가 도구가 먼저 말해 주는 셈입니다.
여기에 두 체크포인트의 같은 문항을 줄 맞춰 보여주는 뷰가 붙습니다. 평균은 거의 같은데 이전에 풀던 문제를 못 풀게 됐다면, 그건 노이즈가 아니라 회귀입니다. 평균만 봐서는 절대 잡히지 않을 신호를 문항 단위 대조로 잡아냅니다.
실무자가 볼 핵심 포인트
- 평가 도구 선택 기준이 단순해집니다. 매일 체크포인트를 비교한다면 olmo-eval, 외부에 결과를 공개하는 벤치마크라면 Harbor 쪽입니다.
- 벤치마크 통합 비용이 낮습니다. 새 벤치마크를 추가할 때 별도 프로젝트 수준의 통합 작업이 아니라 태스크 정의 한 덩어리로 끝납니다.
- 도구 사용 에이전트 평가를 같은 점수표로 비교하고 싶다면
--harness플래그가 답입니다. 점수 체계는 그대로 두고 실행 환경만 바꿔 끼울 수 있습니다. - 작은 점수 변화에 흔들리지 않으려면 표준 오차와 문항 단위 대조 뷰를 항상 켜고 봐야 합니다. 평균만 보고 모델을 채택했다가 회귀를 놓치는 사고가 가장 흔합니다.
- 코드 실행이 필요한 벤치마크가 아니라면 컨테이너를 띄우지 마세요. 기본값인 가벼운 모드만으로도 대부분의 Q&A 류 평가는 충분히 돌아갑니다.
원문 출처
olmo-eval: An evaluation workbench for the model development loop — Tyler Murray, Kyle Wiggers (Ai2, 2026-06-12)