모델을 훈련하는 비용이 문제라고 했다. 이제 평가하는 비용이 문제가 됐다.
Holistic Agent Leaderboard(HAL)은 최근 9개 모델, 9개 벤치마크에서 21,730회 에이전트 롤아웃을 실행하는 데 4만 달러를 썼다. GAIA 벤치마크 하나를 최신 모델로 돌리면 캐싱 전 비용이 2,829달러다. PaperBench 1회 평가는 약 9,500달러다.
이 숫자들이 가리키는 것은 단순한 비용 문제가 아니다. AI 평가의 주도권이 대형 랩 밖으로 나가지 못하게 되는 구조적 변화다.
핵심 요약
- 정적 벤치마크: 100~200배 압축해도 모델 순위 유지 — 비용 절감 가능
- 에이전트 벤치마크: 최대 2~3.5배 압축만 가능 — 롤아웃 자체가 비싼 단위
- 훈련-인-루프 벤치마크: 압축 거의 불가 — 평가 비용이 훈련 비용 초과
- 신뢰도 요구 시: 8회 반복 실행 시 4만 달러 → 32만 달러로 8배 증가
- 핵심 문제: 외부 기관이 독립 검증할 예산이 없어지면서 평가 주도권이 개발 랩으로 집중
1단계: 정적 벤치마크의 비용 — 그리고 해결책
비용 문제는 에이전트 이전부터 시작됐다. 2022년 Stanford CRFM의 HELM 발표 당시, 모델당 API 비용은 최저 $85(code-cushman-001)에서 최고 $10,926(AI21 J1-Jumbo)까지 벌어졌다. 30개 모델 × 42개 시나리오를 합산하면 약 10만 달러 규모였다.
더 충격적인 관찰은 Pythia 체크포인트 분석에서 나왔다. Pythia는 16개 모델, 8개 사이즈별로 각 154개 체크포인트를 공개했다. LM Evaluation Harness로 모든 체크포인트를 평가하면 평가 비용이 사전훈련 비용을 초과할 수 있다. 소형 모델에서는 평가가 전체 개발 사이클의 지배적 compute 항목이 된다.
그러나 정적 벤치마크에는 해결책이 있었다.
| 방법 | 압축률 | 내용 |
|---|---|---|
| Flash-HELM | 100~200배 | 저비용 평가로 후보 필터 후 고해상도 집중 |
| tinyBenchmarks | 140배 (MMLU 14,000→100) | Item Response Theory로 앵커 아이템 추출 |
| Anchor Points | 최대 90%+ 축소 | 1~30개 예시로 87개 모델/프롬프트 쌍 순위, 후속 연구에서 데이터셋 90% 이상 축소 |
| Open LLM Leaderboard | 약 160배 | 29,000→180 예시로 축소 |
핵심 통찰: 모델 순위 차이는 문항 집합의 작은 부분에 집중된다. 정적 예측에서는 공격적 서브샘플링이 유효하다.
이 트릭은 에이전트 벤치마크로 넘어가면 크게 약해진다.
2단계: 에이전트 평가 — 훨씬 복잡하고 비싸다
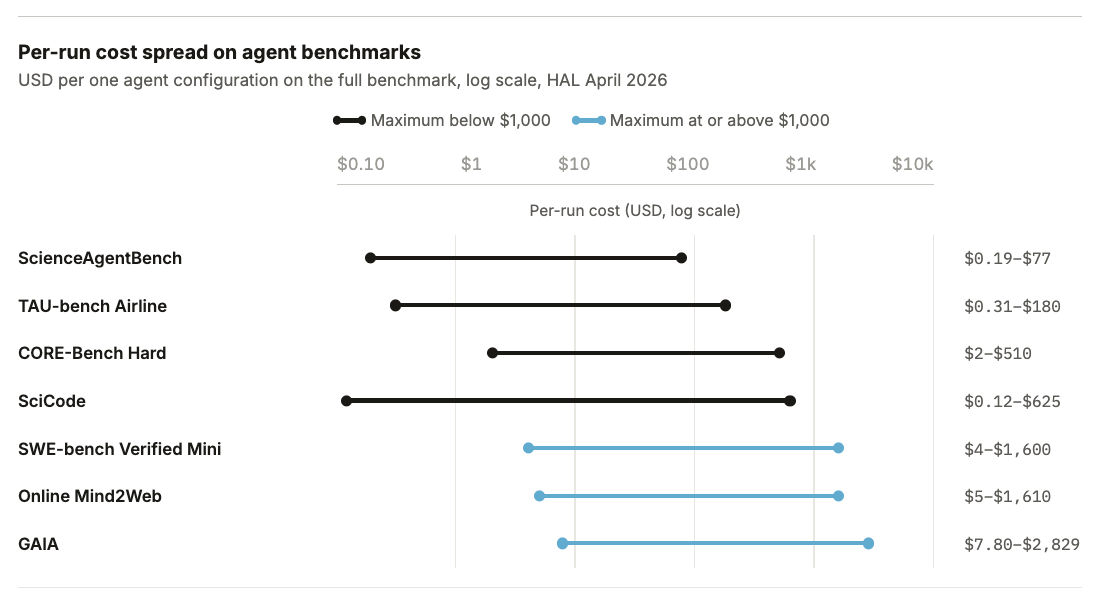
HAL의 공개 회계가 현실을 잘 보여준다. $40,000 집계 뒤에는 벤치마크별로 4자릿수 규모 차이가 존재한다.
 Figure 1. 각 막대는 HAL 구성에서 단일 벤치마크 실행의 최소-최대 비용. 하이라이트된 막대는 1회 실행 $1,000 이상. (출처: HAL 리더보드, 2026년 4월)
비용이 폭발하는 이유: 모델 × 스캐폴드 × 토큰 예산
에이전트 벤치마크는 “모델"을 평가하지 않는다. 모델 × 스캐폴드 × 토큰 예산의 조합을 평가한다.
- Claude Opus 4.1: 입력 토큰 $15/M, 출력 $75/M
- Gemini 2.0 Flash: 입력 $0.10/M, 출력 $0.40/M
- 입력 가격만 두 자릿수 차이
그리고 높은 비용이 반드시 좋은 결과를 보장하지 않는다.
| 벤치마크 | 비교 |
|---|---|
| Online Mind2Web | Browser-Use + Claude Sonnet 4: $1,577로 40% 정확도 / SeeAct + GPT-5 Medium: $171로 42% 정확도 |
| GAIA | HAL Generalist + o3 Medium: $2,828로 28.5% / 다른 에이전트: $1,686로 57.6% |
CLEAR 연구: 6개 SOTA 에이전트를 300개 엔터프라이즈 태스크로 평가한 결과, “정확도 최적 구성은 Pareto 효율 대안보다 4.4~10.8배 비싸다.”
정적 벤치마크 도구의 한계
Ndzomga의 중간 난이도 필터(역사적 합격률 3070% 태스크 선택)는 23.5배 압축을 달성한다. 유용하지만 정적 벤치마크의 100~200배에 비하면 크게 부족하다. 멀티턴 롤아웃 하나하나가 분산을 가진 비싼 단위이기 때문이다.
3단계: 훈련-인-루프 벤치마크 — 평가가 훈련보다 비싸다
일부 벤치마크는 API 비용 프레임에서 벗어난다. 평가 자체가 처음부터 모델을 훈련하기 때문이다.
The Well: 960 H100-시간 = 아키텍처 하나 평가
The Well은 생물계, 유체역학, 자기유체역학, 초신성 폭발 등 16개 과학 ML 데이터셋(15TB)을 묶은 벤치마크다. 단일 새 아키텍처 평가에 **약 960 H100-시간($2,400)**이 들고, 4개 베이스라인 전체 스윕은 **3,840 H100-시간($9,600)**이다.
신경 연산자 하나를 훈련하는 데 H100 12시간이 들지만, 벤치마크 평가에는 80회 훈련이 필요하다. 평가 compute가 훈련 compute를 약 100배(두 자릿수 배율) 초과한다.
PaperBench: 1회 평가 $9,500
ICML 2024 Spotlight/Oral 논문 20편을 처음부터 재현, 8,316개 루브릭 기준으로 채점한다.
- o1 IterativeAgent 롤아웃 × 20편: ~$8,000
- o3-mini 채점: $1,320 (o1 사용 시 $830/편으로 폭증)
- 합계: 약 $9,500
OpenAI는 많은 그룹이 전체 벤치마크를 감당할 수 없어서 코드 실행(execution) 단계를 제거해 비용을 절반으로 낮춘 Code-Dev 변형을 따로 만들었다.
신뢰도 요구가 비용에 곱해진다
위 수치들은 단일 측정에 해당한다. 통계적으로 신뢰할 수 있는 측정을 하려면 반복 실행이 필요하다.
에이전트 신뢰도의 잘 알려진 예: τ-bench에서 1회 실행 시 60% 성능이 8회 일관성 검사에서 25%로 하락한다.
- HAL 분석: SciCode와 CORE-Bench에서 에이전트가 도구 호출 실패 없이 완료한 경우 거의 없음
- AssistantBench와 CORE-Bench: 환경 오류 약 40%
- 실패한 태스크의 최종 답변에서 벤치마크 지시사항 위반 60% 이상
k=8 반복 실행을 적용하면:
- HAL $40,000 → $320,000
- PaperBench $9,500 → $75,000+
- The Well 960 H100-시간 → 수천 H100-시간
HAL은 현재 신뢰도 문제에 집중하기 위해 신규 모델 평가를 일시 중단했다.
이 숫자들이 말하는 것
평가 비용이 책임성의 장벽이 됐다
학계, AI 안전 기관, 언론이 최신 에이전트를 독립적으로 평가하려 할 때, 이제 기술적 장벽보다 예산 장벽이 먼저 온다.
- GAIA 단일 실행: 대학원생 연간 출장 예산 초과 가능
- PaperBench 1회: $9,500
- 6개 모델 × 3시드 비교 연구: $150,000 이상
“벤치마크를 한 번 돌리고 정확도를 발표한다"는 관행은 완벽한 날씨에서 차 한 대만 충돌 테스트하는 것과 비슷한 엄밀성이다.
compute 격차가 이제 평가를 포함한다
Ahmed et al.(Science 2023)은 2021년 산업 모델이 학계 모델보다 파라미터 수 기준 29배 크다는 것을 문서화했다. 원래 “compute 격차” 이야기는 평가가 훈련에 비해 저렴해 보였기 때문에 평가를 무시했다. 많은 벤치마크가 그 관계를 뒤집었다.
비용 무시 리더보드가 낭비를 보상한다
리더보드가 원시 정확도만 보고 비용을 생략하면, 연구자는 합리적으로 숫자를 올릴 때까지 토큰을 쏟아붓는다. HAL 연구는 높은 추론 노력이 대부분의 실행에서 실제로 정확도를 낮춘다는 것을 발견했다. 추가 추론 computing이 최적화 대상 지표조차 안정적으로 개선하지 않는다.
Pareto 프론티어 비교가 해결책이다. HAL은 구현했다. 대부분의 리더보드는 아직 하지 않는다.
벤치마크 유형별 비용 요약
| 벤치마크 | 유형 | 1회 평가 비용 |
|---|---|---|
| HELM (모델당) | 정적 LLM | $85 – $10,926 + GPU |
| TAU-bench Airline | 에이전트 | $0.31 – $180 |
| SciCode | 에이전트·과학 | $0.12 – $625 |
| SWE-bench Verified Mini | 에이전트·코딩 | $4 – $1,600 |
| Online Mind2Web | 에이전트·웹 | $5 – $1,610 |
| GAIA | 에이전트·멀티모달 | $7.80 – $2,829 |
| ResearchGym | ML 연구·훈련 | $540 – $1,260 |
| The Well (아키텍처당) | SciML·훈련 | ~$2,400 |
| MLE-Bench (1시드) | ML R&D·훈련 | ~$5,500 |
| PaperBench | 논문 재현·훈련 | ~$9,500 |
실무자가 볼 핵심 포인트
에이전트 벤치마크 1회 결과는 통계적으로 신뢰하기 어렵다 — τ-bench 사례처럼 8회 반복 시 60%→25%로 떨어지는 일이 발생한다. 단일 실행 숫자를 인용할 때 반드시 실행 횟수를 확인해야 한다.
스캐폴드 선택이 비용의 1순위 드라이버다 — Exgentic의 $22,000 스윕에서 동일 태스크에 33배 비용 차이가 났고 원인은 스캐폴드였다. 에이전트 시스템 설계 시 스캐폴드 선택이 정확도만큼 중요한 변수다.
훈련-인-루프 벤치마크는 다른 예산 범주다 — The Well(~$2,400/아키텍처)이나 PaperBench($9,500/실행)는 API 예산이 아닌 compute 예산 항목이다. 연구 의제 설정 시 이 비용을 미리 계획해야 한다.
정확도-비용 Pareto 프론티어를 봐야 한다 — 원시 정확도 수치만 보는 리더보드는 비효율을 감춘다. HAL처럼 비용-성능 트레이드오프를 함께 게시하는 리더보드가 기준이 돼야 한다.
독립 평가 능력이 AI 거버넌스의 핵심 문제가 됐다 — 대형 랩만 감당할 수 있는 평가 비용은 외부 검증을 사실상 불가능하게 만든다. 안전 기관, 학계, 규제 기관이 독립 평가 예산을 확보하지 못하면 평가 권한이 피평가자에게 집중된다.
자주 묻는 질문 (FAQ)
Q: 에이전트 벤치마크를 싸게 돌릴 수 있는 방법이 없나요?
현재까지 가장 효과적인 방법은 중간 난이도 필터(역사적 합격률 3070%)로 23.5배 압축하는 것입니다. 정적 벤치마크의 100~200배 압축과는 차원이 다릅니다. 멀티턴 롤아웃의 분산 때문에 공격적 서브샘플링이 순위 신뢰도를 깨뜨립니다.
Q: 리더보드 숫자를 어떻게 해석해야 하나요? 최소한 실행 횟수, 스캐폴드, 토큰 예산을 같이 확인해야 합니다. HAL 로그 분석에서 TAU-bench Few Shot 스캐폴드에 데이터 누출이 있어 2025년 12월 제거된 사례처럼, 단일 실행 정확도는 구성 선택에 크게 의존합니다.
Q: 소형 모델/소규모 팀이 현실적으로 할 수 있는 평가는 무엇인가요? 정적 벤치마크(SWE-bench, HumanEval, MMLU 등)는 tinyBenchmarks나 서브셋 방법으로 비용을 크게 낮출 수 있습니다. 에이전트 평가가 필요하다면 HAL이 공개하는 표준 스캐폴드와 공유 비용 추적을 활용하는 것이 가장 효율적입니다. 자체 훈련-인-루프 벤치마크는 예산 현실을 정직하게 평가한 후 진행하세요.
원문 출처: Avijit Ghosh, Yifan Mai, Georgia Channing, Leshem Choshen et al., “AI evals are becoming the new compute bottleneck”, HuggingFace Blog, 2026년 4월 29일 — https://huggingface.co/blog/evaleval/eval-costs-bottleneck