개요
요즘 코딩 에이전트는 신통합니다. 버그 리포트 한 줄만 던져도 어느 파일을 봐야 하는지 거의 정확히 짚어냅니다. 그런데 “정작 그 파일에서 어디를 고쳐야 하는가"로 들어가면 이야기가 달라집니다. 새로 공개된 벤치마크 SWE-Explore가 이 격차를 정면으로 측정했습니다. 결과는 꽤 충격적입니다. Claude Code, Codex, OpenHands 같은 일반 에이전트들이 실제로 수정이 필요한 라인 중 14~19%만 들여다본다는 겁니다. 그리고 모델을 더 큰 걸로 바꾼다고 해서 이 숫자가 좀처럼 올라가지 않습니다.
핵심 요약
- 파일은 찾는데 줄을 못 본다: 일반 코딩 에이전트의 라인 커버리지가 14~19%에 머문다
- 모델 크기로 해결되지 않는다: GPT-5.4, Claude Sonnet 4.6, Gemini 3 Pro 어느 쪽도 패턴이 비슷하다
- 50% 임계선: 핵심 코드 영역이 절반 이상 보일 때만 수정 성공률이 점프한다
- CoSIL은 예외: 코드를 ‘서로 엮인 블록’으로 다루는 전용 시스템이 의미 있는 격차를 만든다
- 결론은 단순: “필터를 줄이고 더 읽어라” — 좁게 자르는 것보다 넓게 훑는 쪽이 낫다
SWE-Explore가 측정한 것
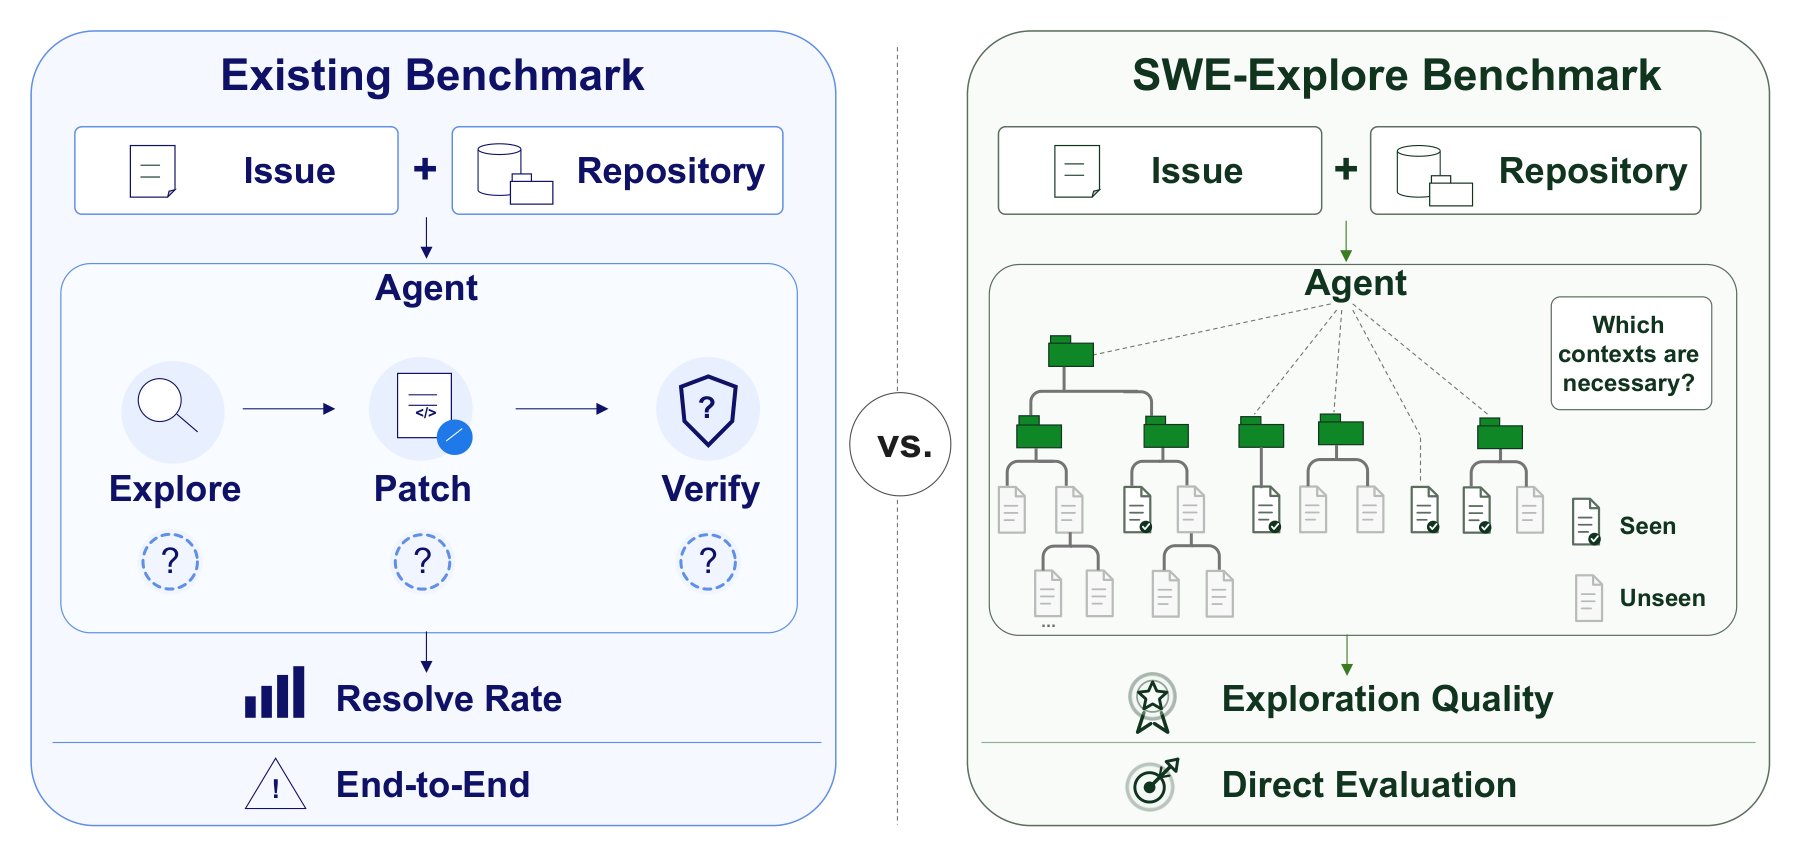
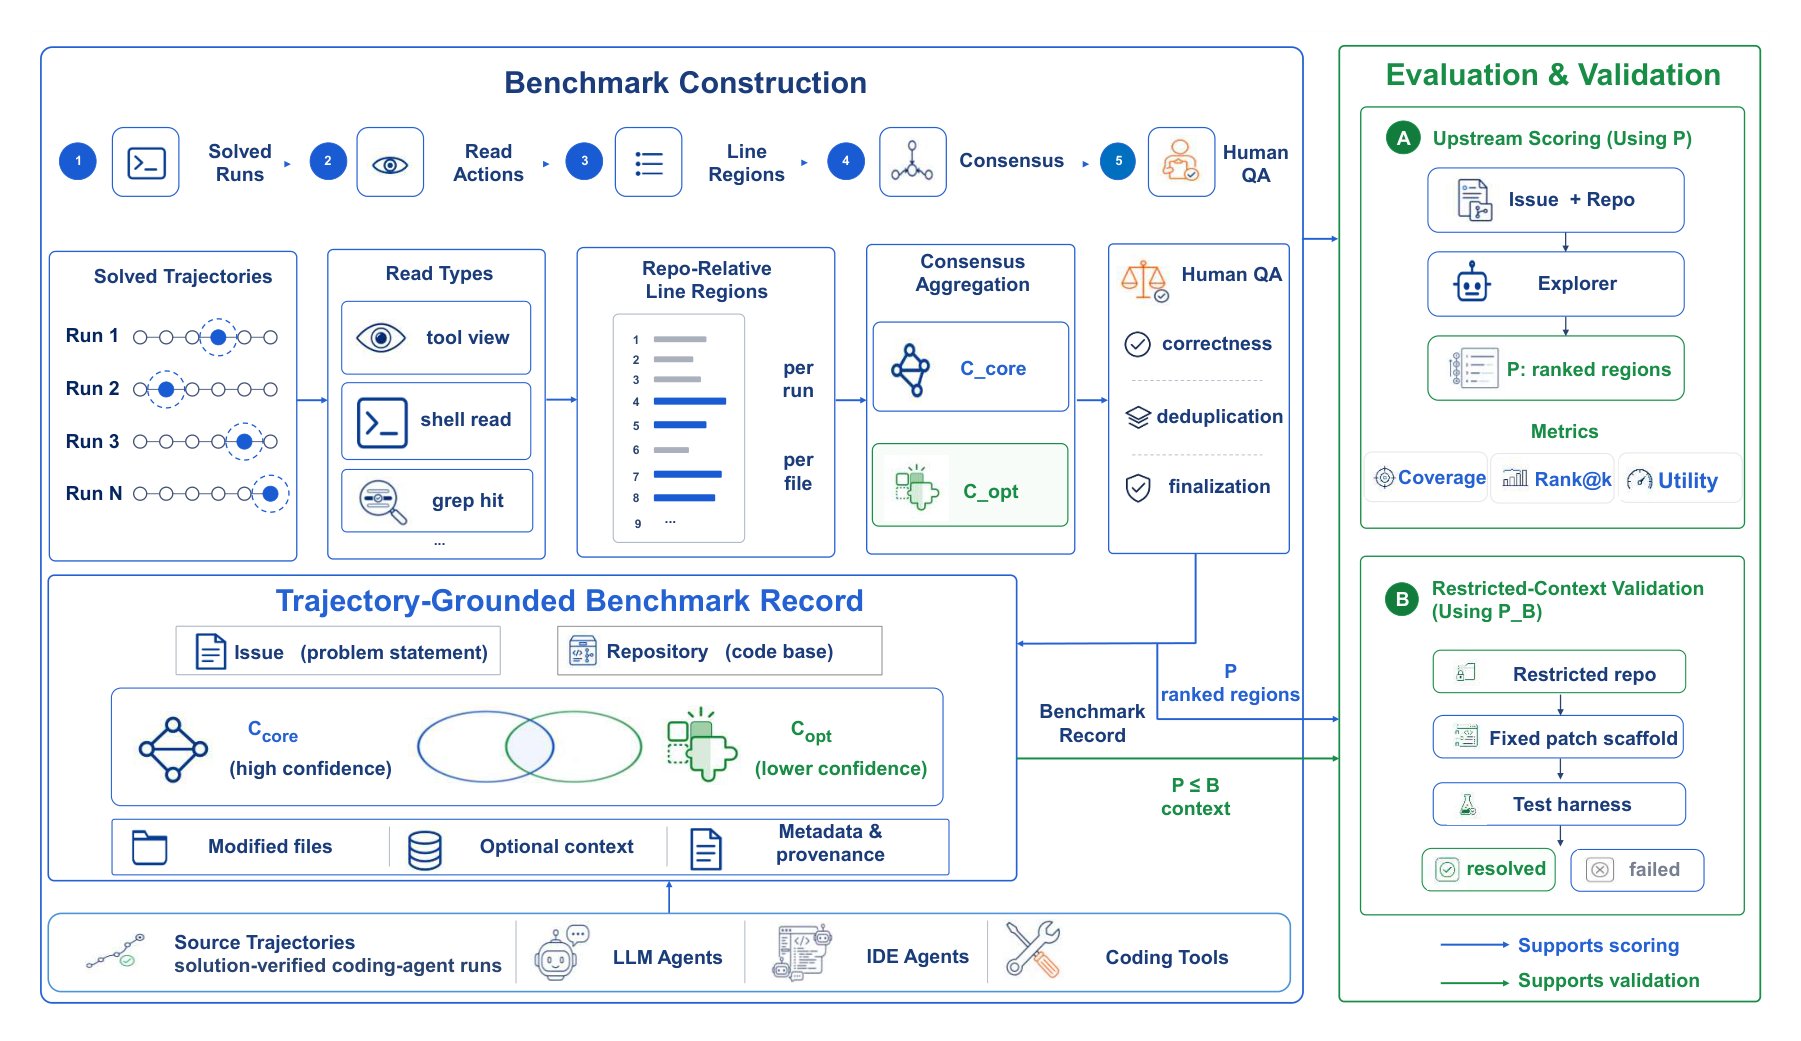
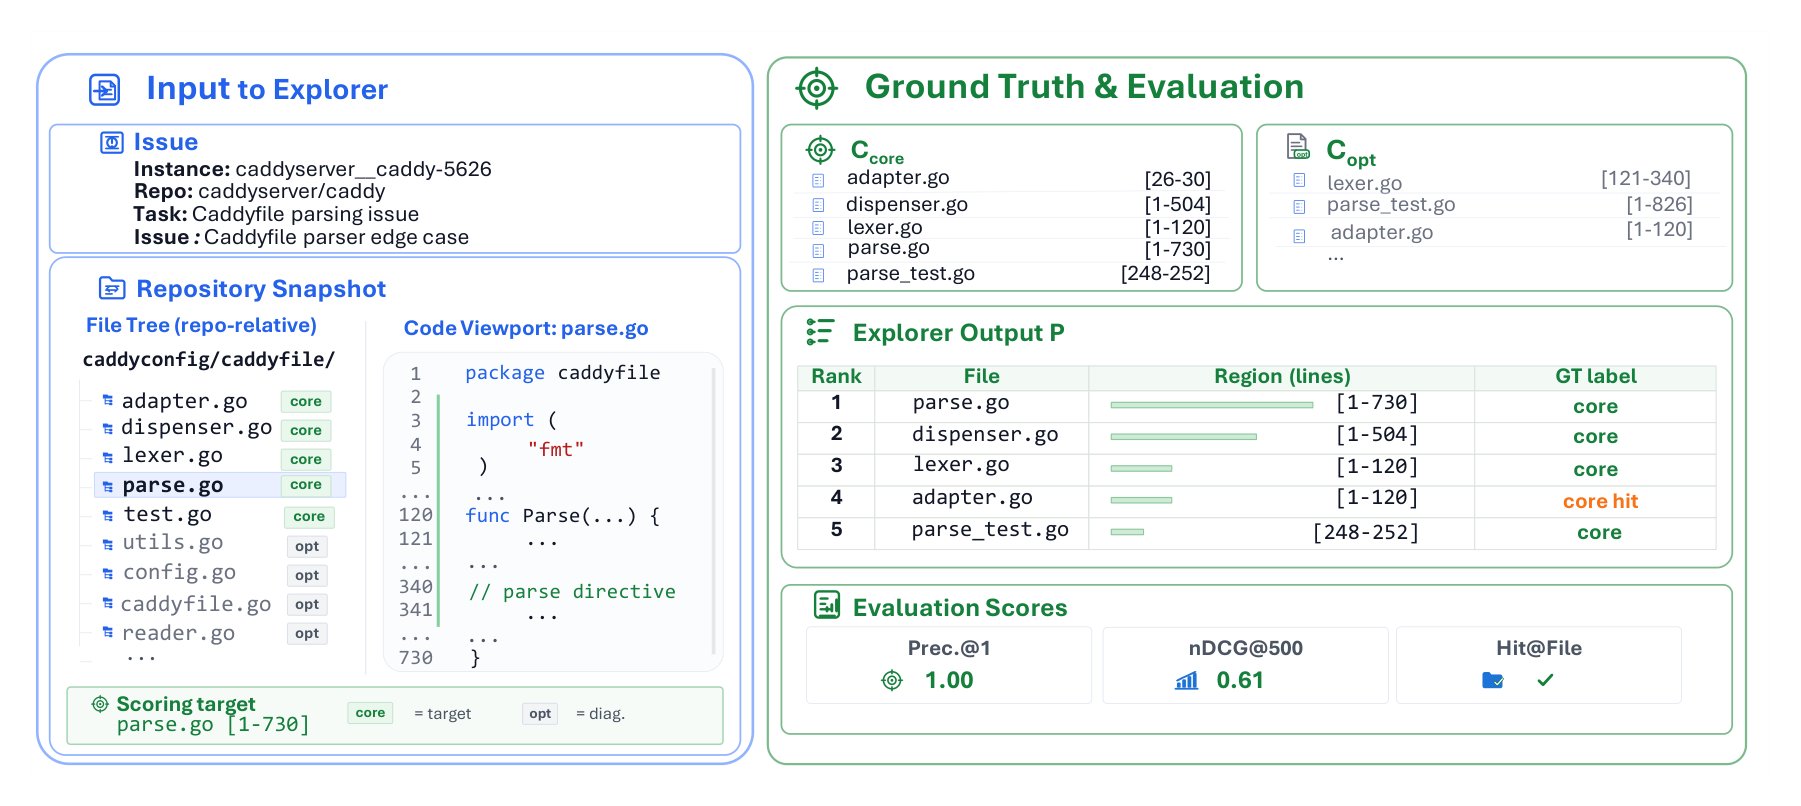
기존 SWE-bench 계열 벤치마크는 “이 버그를 결국 고쳤는가"라는 결과를 봅니다. SWE-Explore는 한 단계 안으로 들어갑니다. 에이전트가 수정안을 내기 전에 어떤 파일과 어떤 라인을 실제로 읽었는지를 본 다음, 그게 정답 패치가 손댄 영역과 얼마나 겹치는지를 잽니다.
데이터셋 규모도 적당합니다. 열 개 프로그래밍 언어, 203개 오픈소스 프로젝트, 848개 문제를 모았습니다. Python이 547개로 가장 많고 Go, JavaScript, Rust가 뒤를 잇습니다. 정답 위치는 사람이 일일이 라벨링한 게 아니라, GPT-5.4·Gemini 3 Pro·Claude Sonnet 4.6·Kimi K2.6가 각자 푼 성공 풀이들에서 공통적으로 손댄 영역을 추려 만든 겁니다. 여러 모델이 따로 도착한 같은 지점, 그게 ‘진짜 고쳐야 할 자리’라는 가정입니다.
파일 적중률은 높은데, 줄로 들어가면 무너진다
벤치마크가 보여주는 그림은 이렇습니다.
- 파일 단위: 에이전트들이 거의 비슷하게 잘 찾습니다. 사람이 봐도 “맞네"라고 할 만한 후보 파일을 대체로 짚어냅니다.
- 라인 단위: 점수가 갑자기 무너집니다. **14~19%**라는 숫자가 거기에서 나옵니다.
더 골치 아픈 건, 에이전트별 점수가 “거의 똑같이 나쁘다"는 점입니다. 모델 베이스가 달라도, 하네스가 달라도 라인 커버리지는 비슷한 구간에 모여 있었습니다. 즉, 이건 모델 한 곳의 약점이 아니라 현재 코딩 에이전트들이 코드를 탐색하는 방식 자체의 한계라는 뜻입니다.
예외가 하나 있습니다. CoSIL이라는 연구용 시스템입니다. CoSIL은 코드를 파일·함수 단위로 끊어 보는 대신, 서로 호출하고 참조하는 연결된 블록 그래프로 다룹니다. 정답 라인을 찾아 들어가는 능력이 일반 에이전트보다 눈에 띄게 높았습니다.
50% 임계선이라는 잔인한 사실
연구진은 한 발 더 들어가 어블레이션 실험을 돌렸습니다. 정답 영역 일부를 일부러 가려놓고, 에이전트가 얼마나 고치는지 보는 방식입니다.
결과 그래프가 부드러운 우상향이 아니라 계단처럼 생겼다는 게 핵심입니다. 정답 영역의 50%가 보이기 전까지는 수정 성공률이 거의 바닥에 깔려 있다가, 50%를 넘는 순간 한 번에 뛰어오릅니다. 연구진 표현을 그대로 옮기면 이렇습니다. “수정은 점진적으로 좋아지지 않는다. 단서가 일정 수준 이상 모여야만 성공이 된다.”
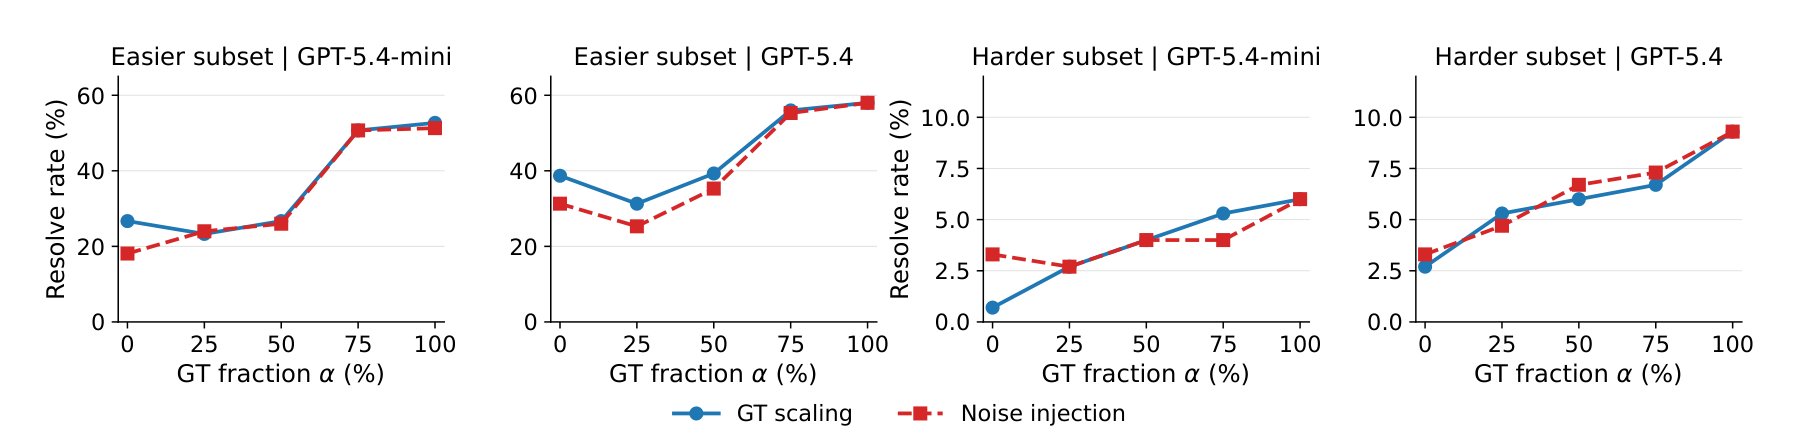
실무로 옮기면 무서운 이야기입니다. 컨텍스트 윈도우를 절반만 채워서 보내면 모델이 절반쯤은 고친다는 게 아니라, 거의 못 고친다는 뜻이니까요. 단서가 임계점을 넘느냐 못 넘느냐가 곧 성공과 실패를 가릅니다.
그래서 답은 “필터를 줄이고 더 읽어라”
흥미로운 건 처방입니다. 보통 우리는 “더 똑똑한 검색”, “더 정교한 리랭커"를 떠올립니다. SWE-Explore는 정반대를 가리킵니다.
쓸데없는 코드를 같이 들고 갔을 때의 손실보다, 핵심 코드를 빠뜨렸을 때의 손실이 훨씬 컸습니다. 컨텍스트에 여유가 있다면 좁게 자르기보다 일부러 넓게 읽는 게 안전하다는 결론이 나옵니다. 연구진이 정리한 한 문장이 가장 명쾌합니다. “Filter less, read more.”
CoSIL이 좋은 성적을 낸 이유도 같은 맥락입니다. 함수 하나만 콕 찍어 보는 게 아니라, 그 함수에 얽힌 호출자·피호출자·자료구조까지 같이 본 덕분입니다.
실무자가 볼 핵심 포인트
- 버그 수정 작업에 에이전트를 쓰고 있다면 라인 커버리지를 점검해 보세요. “어느 파일을 봤는지"가 아니라 **“그 안에서 정확히 어느 줄을 읽었는지”**를 로그로 남기는 게 시작점입니다.
- 컨텍스트를 너무 짜내지 마세요. 토큰 아끼려고 핵심 함수만 들고 가는 패턴은 50% 임계선 아래로 떨어지기 쉽습니다. 차라리 호출 그래프 한 단계 더 끌고 가는 쪽이 회수율이 높습니다.
- 모델만 바꿔서 해결될 문제가 아닙니다. GPT-5.4든 Sonnet 4.6든 비슷하게 막힙니다. 검색·리트리버·하네스 단의 설계로 풀어야 하는 문제입니다.
- 그래프 기반 코드 이해를 검토해 보세요. CoSIL의 접근처럼 LSP, ctags, AST를 활용한 호출 그래프 인덱싱이 라인 수준 적중에 직접적인 영향을 줍니다.
- 사내 코드베이스에도 적용해 봅시다. 모델을 새로 학습시키지 않아도 됩니다. “성공한 풀이들이 공통적으로 손댄 영역"을 라벨로 쓰는 SWE-Explore의 데이터 구축 방식을 그대로 차용할 수 있습니다.
원문 출처: AI coding agents find the right file but miss the exact lines that matter, study shows — Jonathan Kemper, THE DECODER (2026-06-14)