핵심 요약
AI 에이전트를 만들 때 가장 먼저 떠올리는 질문은 보통 “어떤 모델을 쓸까?”입니다. 물론 모델 선택은 중요합니다. 하지만 최근 에이전트 연구와 실무 사례를 보면, 성능 차이는 모델 자체보다 모델을 감싸는 실행 구조, 즉 하네스(harness) 에서 더 크게 벌어지고 있습니다.
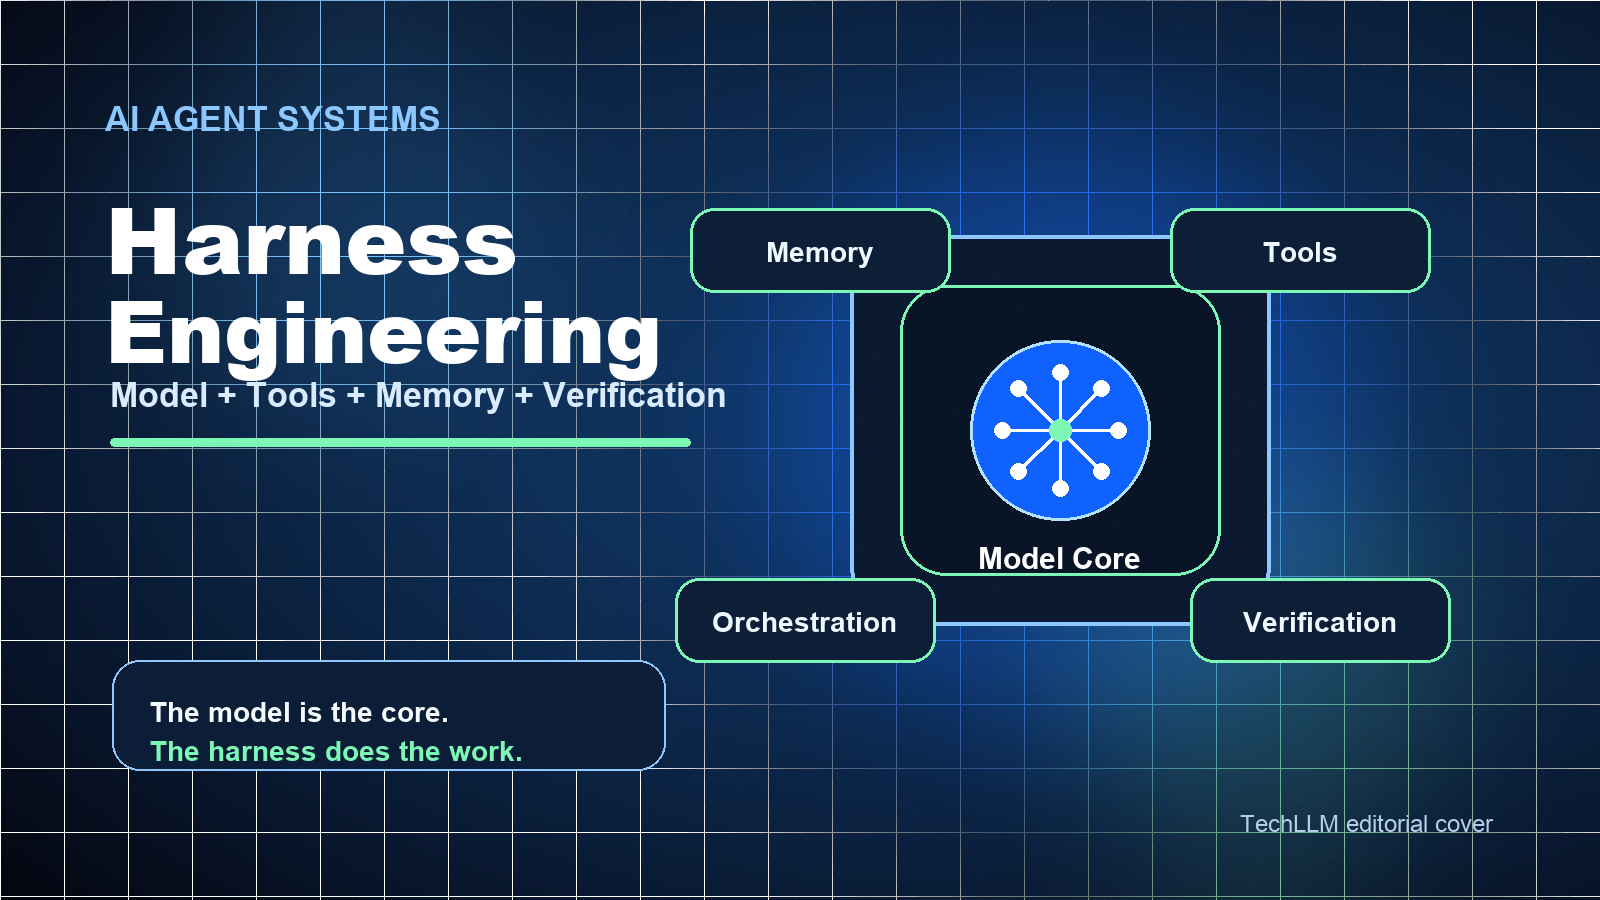
하네스는 모델 가중치를 제외한 운영 구조 전체를 뜻합니다. 시스템 프롬프트, 도구 정의, 작업 분해 방식, 메모리 관리, 검증 루프, 실패 복구, 안전 가드레일까지 모두 여기에 들어갑니다. 영상에서는 LLM을 CPU에, 하네스를 운영체제에 비유합니다. CPU가 강력해도 운영체제가 없으면 실제 일을 안정적으로 처리하기 어렵다는 뜻입니다.
왜 하네스가 중요해졌을까
영상은 같은 모델과 같은 벤치마크에서도 하네스 설계에 따라 성능이 크게 달라진다는 사례를 소개합니다. LangChain은 모델 자체가 아니라 하네스 인프라를 바꾸는 것만으로 코딩 에이전트 성능이 Terminal Bench 2에서 크게 뛰었다고 설명합니다. 여기서 중요한 포인트는 “더 큰 모델”이 아니라, 모델을 호출하고 검증하고 다시 시도하게 만드는 주변 구조입니다.
이유는 단순합니다. 모델은 답을 생성할 수 있지만, 무엇을 언제 보고, 어떤 도구를 쓰며, 어디서 멈춰야 하는지는 늘 안정적으로 결정하지 못합니다.
좋은 하네스는 일을 작게 나누고, 필요한 정보를 외부 상태로 보관하며, 실패했을 때 다시 시도할 기준을 제공합니다. 반대로 나쁜 하네스는 도구를 너무 많이 열어두거나, 검증 없이 완료를 선언하거나, 같은 문제를 비싼 방식으로 반복하게 만듭니다.
더 복잡한 구조가 항상 답은 아니다
흥미로운 점은 “하네스를 많이 붙이면 좋아진다”가 결론이 아니라는 것입니다. 영상에서 소개한 연구들은 일부 검증기나 다중 후보 탐색이 오히려 성능을 떨어뜨릴 수 있다고 말합니다. 많은 토큰과 도구 호출을 쓰는 구조가 항상 더 나은 결과를 내지는 않습니다.
성과를 낸 구조는 대체로 단순했습니다. 처음부터 넓게 탐색하기보다 좁은 시도를 먼저 하고, 실패 신호가 분명할 때만 범위를 넓히는 방식입니다. 특히 실행 실패 기록을 요약본으로 바꾸기보다 원본 trace에 가깝게 남겼을 때 개선 신호가 더 강하다는 점도 눈에 띕니다.
좋은 에이전트 설계는 기능을 계속 추가하는 일이 아니라, 불필요한 구조를 걷어내는 일에 가깝습니다.
실무자가 볼 포인트
첫째, 완료 조건을 명확히 해야 합니다. “답변을 생성했다”가 아니라 “요구 조건을 충족했고, 필요한 검증을 통과했다”가 완료 기준이 되어야 합니다.
둘째, 실행 기록을 남겨야 합니다. 실패한 프롬프트, 도구 호출, 중간 판단은 다음 개선의 핵심 재료입니다. 정리된 요약보다 실제 실행 trace가 더 강한 신호가 될 수 있습니다.
셋째, 도구는 많을수록 좋은 것이 아닙니다. 모델이 선택해야 할 도구가 많아질수록 판단 비용과 오류 가능성도 함께 커집니다. 실무에서는 “무엇을 추가할까”보다 “무엇을 제거할까”가 더 중요한 질문이 됩니다.
팀에서 검토할 질문
- 에이전트는 언제 작업을 완료했다고 판단하는가?
- 실패했을 때 무작정 재시도하는가, 실패 신호에 따라 전략을 바꾸는가?
- 도구와 검증 루프가 실제 성능을 올리고 있는지 측정하고 있는가?
- 모델을 바꾸기 전에 실행 구조를 먼저 개선해본 적이 있는가?
- 불필요한 프롬프트, 도구, 상태 관리가 남아 있지는 않은가?
모델 경쟁 이후의 경쟁력
프롬프트 엔지니어링과 컨텍스트 엔지니어링을 지나, 이제는 하네스 엔지니어링이 중요해지고 있습니다. 모델을 잘 쓰는 능력은 단일 프롬프트 작성 능력에 머물지 않습니다. 핵심은 모델이 실제 환경에서 안정적으로 일하도록 만드는 구조입니다.
겅허게 말하면, 앞으로 AI 에이전트를 만드는 팀의 경쟁력은 “가장 최신 모델을 쓰는가”보다 실패를 기록하고, 구조를 줄이고, 실행 루프를 개선할 수 있는가에서 갈릴 가능성이 큽니다.
원문 영상: Rethinking AI Agents: The Rise of Harness Engineering