개요
요즘 AI 에이전트 발표를 따라가다 보면 한 가지가 눈에 들어옵니다. 어느 회사도 더 이상 “우리 모델이 코드를 더 잘 짭니다"만으로는 발표를 끝내지 않는다는 점입니다. 그 다음에 반드시 따라오는 문장이 있습니다. 그리고 그 결과가 맞는지 직접 확인합니다. 6월에 쏟아진 발표들 — xAI Grok Build의 /goal, 시스코의 FAPO, 랭체인의 휴먼 인 더 루프 패턴, 그리고 그 사이에서 조용히 자리를 굳히는 OpenAI Codex CLI — 가 모두 같은 방향을 가리키고 있습니다. 에이전트 경쟁의 무게중심이 모델 성능에서 검증 루프 설계로 이동하는 중입니다.
핵심 요약
- 6월에 발표된 xAI
/goal, 시스코 FAPO, 랭체인 HITL, Codex CLI는 모두 “코드를 쓰는 능력"이 아니라 “결과를 확인하고 다시 고치는 루프"를 제품으로 만들었습니다. - xAI
/goal은 계획 → 체크리스트 → 실행 → 검증을 한 세션 안에 묶고, 검증을 코드 리뷰·웹페이지 확인·스크립트 실행 세 방식으로 자체 수행합니다. - 시스코 FAPO는 실패를 **프롬프트 가능(format·reasoning)**과 **구조 가능(retrieval·cascading)**으로 분류해서, 단계별로 어디서 깨졌는지 자동으로 짚어냅니다.
- 랭체인은 LangGraph의 인터럽트·체크포인트 위에 휴먼 인 더 루프를 얹어, 위험한 동작 직전에 사람이 멈추고 승인할 수 있는 지속 가능한 일시중지를 만들었습니다.
- 같은 폐쇄 루프 구조는 코딩뿐 아니라 문서 추출, 법률 검증, 보안 분석에도 그대로 옮겨 갈 수 있습니다. 그래서 지금 만들어 둘 가치가 있는 것은 단일 기능이 아니라 루프 스택의 지도입니다.
왜 지금 ‘검증’이 경쟁축이 되었는가
지난 2년 동안 코딩 에이전트의 공식 발표 자료는 거의 똑같았습니다. SWE-Bench 점수, HumanEval 점수, 더 큰 컨텍스트 길이. 그러나 현장에 들어가 보면 이 숫자들이 실제 작업 시간을 줄여 주지 못한다는 사실이 빠르게 드러났습니다. 이유는 단순합니다. 에이전트가 코드를 한 번에 완벽히 짜는 일이 거의 없기 때문입니다. 실패를 어떻게 감지하고, 그 원인을 어떻게 추적하고, 어디서부터 다시 고칠지를 결정하는 단계에서 사람이 모든 시간을 씁니다.
OpenAI Codex 팀이 2026년 베스트 프랙티스에서 강조한 핵심도 정확히 같습니다. 모델이 자기 작업을 자기가 평가하면 신뢰도가 떨어진다. 그래서 권장 패턴이 “테스트를 먼저 작성하고, 모든 테스트가 실패하는 것을 확인한 다음, 에이전트가 테스트를 건드리지 않고 통과시키게 한다"입니다. 즉, 에이전트의 자율성을 늘리는 게 아니라 외부 검증 신호를 먼저 박아 두는 방향으로 베스트 프랙티스가 정착되고 있습니다.
xAI /goal: 검증까지 한 세션에 넣어 버렸다
xAI가 6월 22일 Grok Build에 추가한 /goal 모드는 이 흐름을 가장 노골적으로 보여줍니다. 사용자가 목표를 던지면 에이전트가 접근 방식을 계획하고, 진행 체크리스트로 분해한 뒤, 항목을 하나씩 실행합니다. 여기까지는 익숙합니다. 진짜 차별점은 그 다음입니다.
xAI는 검증을 세 가지 방식으로 명시했습니다.
- 에이전트가 자기가 작성한 코드를 다시 리뷰합니다.
- 동작을 확인해야 할 때는 실제 웹페이지를 열어 봅니다.
- 결과를 확인해야 할 때는 스크립트를 직접 실행합니다.
또 한 가지 흥미로운 설계는 단일 모델을 쓰지 않는다는 점입니다. /goal은 Composer 2.5와 Grok Build 0.1을 함께 호출합니다. 계획에 한 모델, 구현에 다른 모델, 검증에 또 다른 모델을 쓰는 식입니다. 한 모델이 자기 결과를 자기 채점하는 구조의 한계를 인정한 셈입니다.
장기 실행 에이전트에서 이 차이는 큽니다. 사람이 한 시간씩 지켜보지 않아도 끝까지 돌릴 수 있는 이유가 “모델이 똑똑해서"가 아니라 “중간중간 자체 검증이 박혀 있어서"가 되는 것이 핵심입니다.
시스코 FAPO: 실패를 진단 가능한 카테고리로 쪼갠다
비슷한 시기에 시스코 AI가 공개한 FAPO(Fully Autonomous Prompt Optimization)는 검증 루프를 한 단계 더 밀어붙입니다. FAPO는 다단계 LLM 파이프라인의 프롬프트를 자동으로 튜닝하는 도구인데, 이 시스템이 특별한 이유는 실패를 그냥 “실패"로 두지 않는다는 점입니다.
FAPO는 단계별 실패를 네 가지 카테고리로 분류합니다.
- 프롬프트 가능한 실패
- format: 출력 형식이 어긋났다
- reasoning: 추론 단계에서 막혔다
- 구조적 실패
- retrieval: 필요한 정보를 못 가져왔다
- cascading: 앞 단계 오류가 뒤로 번졌다
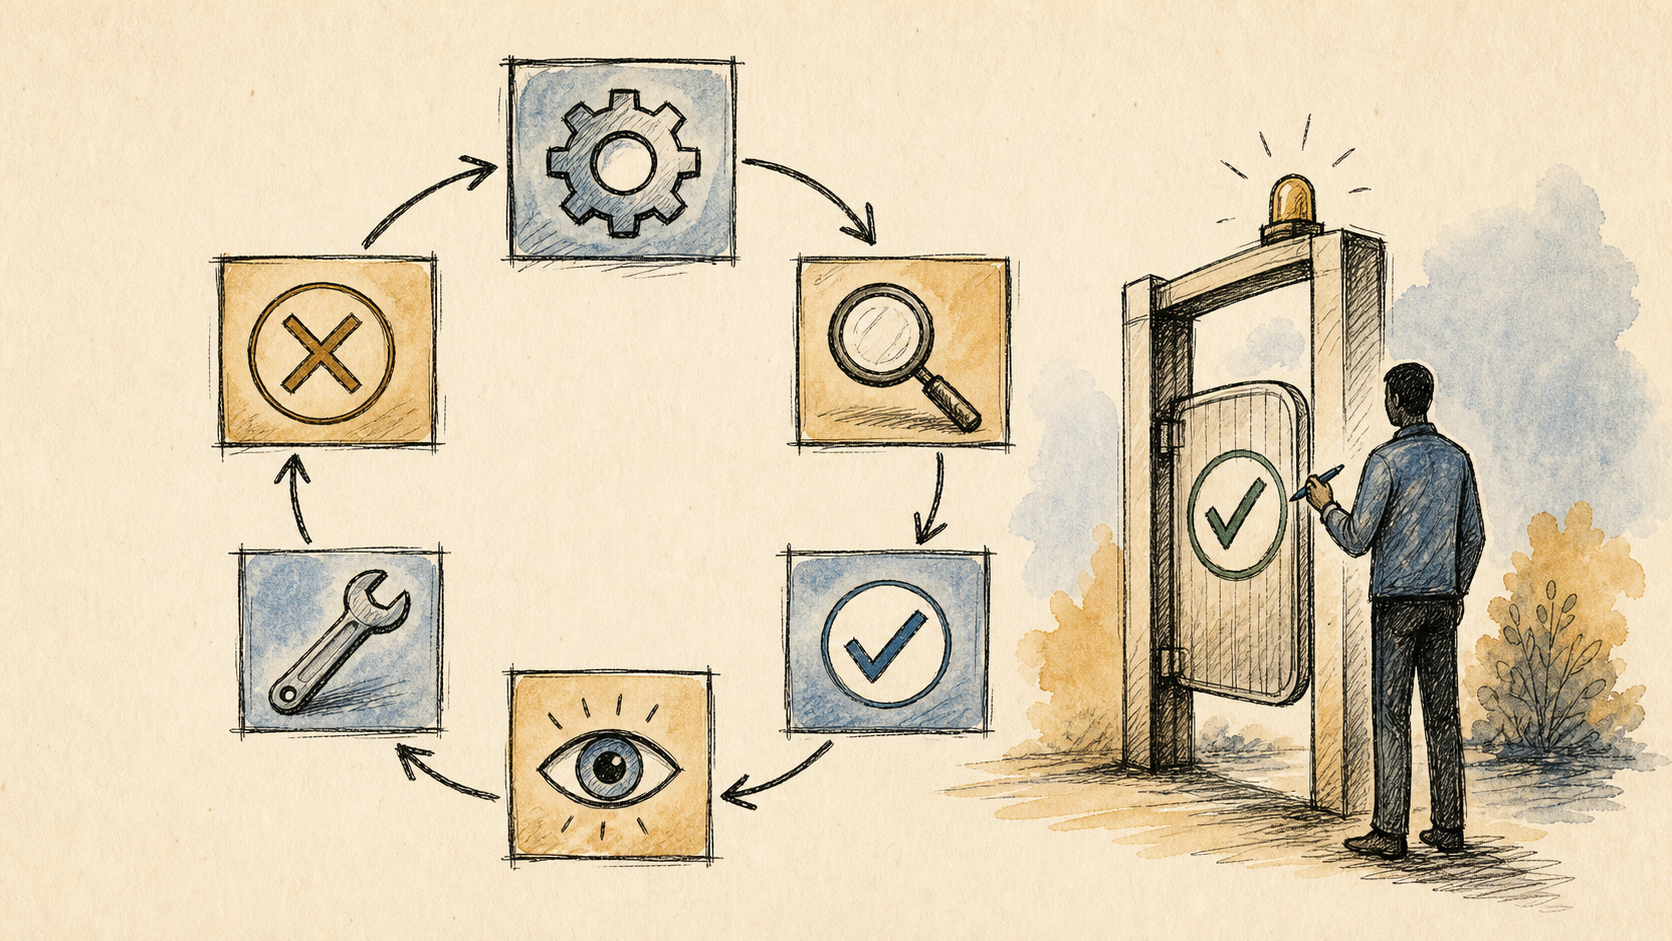
이 분류가 중요한 이유는 처방이 달라지기 때문입니다. format/reasoning은 프롬프트 수정으로 풀 수 있지만, retrieval/cascading은 프롬프트를 아무리 고쳐도 해결되지 않습니다. FAPO는 이 차이를 인식해서 6단계 폐쇄 루프 — Evaluate → Attribute → Propose → Review → Compare → Iterate — 를 돌리고, 처방을 세 단계로 단계적으로 강화합니다. 먼저 프롬프트만 손대고, 안 되면 파라미터를 조정하고, 그래도 안 되면 구조 자체를 바꾸는 식입니다.
오케스트레이션은 Claude Code 에이전트가 맡고, 상태 그래프는 LangGraph로 정의됩니다. 즉, 검증 루프 그 자체가 다른 에이전트 위에 얹힌 메타 에이전트입니다. Apache 2.0으로 공개돼 있어서 누구나 자기 파이프라인에 붙일 수 있다는 점도 큽니다.
이 분류 체계가 정말 강력한 이유는 코딩 에이전트에만 묶이지 않기 때문입니다. 문서 추출, 법률 문서 검증, 보안 로그 분석 — 모두 “여러 단계의 LLM 파이프라인 중 어디서 깨졌는가"를 알아야 하는 영역입니다. format/reasoning/retrieval/cascading 네 칸은 이 모든 도메인에 그대로 옮겨 붙습니다.
랭체인 HITL: 사람의 판단을 어디에 박을 것인가
자동화된 검증만으로는 부족한 영역이 분명히 있습니다. 이메일 발송, 데이터베이스 쓰기, 외부 API 호출, 금융 거래처럼 한 번 누르면 되돌리기 어려운 행동들이 그렇습니다. 랭체인이 LangGraph 1.0에 휴먼 인 더 루프를 1급 시민으로 끌어올린 이유가 여기 있습니다.
랭체인의 HITL은 단순한 “확인하시겠습니까?” 팝업이 아닙니다. LangGraph의 인터럽트와 체크포인트 위에서 동작하기 때문에, 에이전트가 며칠 뒤에 다시 깨어나서 같은 자리에서 이어가도 상태가 깨지지 않습니다. 지속 가능한 일시중지인 셈입니다. 이 구조 덕분에 다음과 같은 패턴이 자연스럽게 자리잡습니다.
- 위험한 동작 직전에 멈춘다
- 사람에게 어떤 동작을 어떤 근거로 하려는지 보여 준다
- 승인이 떨어지면 같은 컨텍스트에서 다시 실행한다
같은 회사가 동시에 강조하는 것이 평가 패턴입니다. 랭체인은 프로덕션의 깊은 에이전트를 다섯 가지 방식으로 평가하라고 권합니다. 데이터포인트별 커스텀 검증, 단일 스텝 평가, 전체 턴 평가, 다중 턴 시뮬레이션, 그리고 재현 가능한 테스트 환경 구성. 이 다섯 가지를 모두 갖춘 팀은 거의 없지만, 방향성은 분명합니다. 모델을 신뢰하는 게 아니라 평가 신호를 신뢰하는 쪽입니다.
같은 그림: 에이전트 루프 스택
지금까지 본 네 가지 흐름을 한 장에 놓으면 같은 그림이 떠오릅니다.
| 단계 | 무엇을 하는가 | 대표 도구·기술 |
|---|---|---|
| 계획 | 목표를 받아 단계로 쪼갠다 | Grok Build /goal 체크리스트, LangGraph 상태 그래프 |
| 실행 | 분해된 단계를 실제로 수행한다 | Codex CLI, Grok Build 0.1, Claude Code |
| 관찰 | 실행 결과를 수집한다 | 터미널 로그, 테스트 출력, 웹페이지 스냅샷 |
| 평가 | 결과가 맞는지 판단한다 | FAPO Evaluate, Codex의 테스트 실행, /goal 자체 리뷰 |
| 분류 | 실패 원인을 카테고리로 나눈다 | FAPO Attribute (format/reasoning/retrieval/cascading) |
| 수정 | 원인에 맞는 처방을 적용한다 | FAPO 3단계 escalation (prompt → param → structure) |
| 승인 | 위험·되돌리기 어려운 행동에 사람을 둔다 | LangGraph 인터럽트 + 체크포인트 |
이게 에이전트 루프 스택입니다. 한 회사가 이 모든 칸을 잘 채우는 게 아닙니다. 각 회사가 자기가 가장 잘하는 한두 칸을 깊게 파고 있고, 시간이 갈수록 이 칸들이 서로 표준화된 인터페이스로 연결될 것입니다. 멀티에이전트 시대의 진짜 핵심은 모델 카드가 아니라 이 표 위의 연결 지도가 될 가능성이 높습니다.
실무자가 볼 핵심 포인트
- 새 에이전트 제품을 평가할 때 “어떤 모델을 쓰는가"보다 **“어떻게 자기 결과를 확인하는가”**를 먼저 보세요. 검증 방식이 명확하지 않은 제품은 데모에서만 좋아 보입니다.
- 자기 파이프라인을 만들 때는 모델을 통일하지 마세요. xAI
/goal이 그러듯이 계획·실행·검증을 다른 모델에 맡기는 것만으로도 자기 채점의 함정을 상당 부분 피할 수 있습니다. - 실패 로그를 그냥 모으지 말고 카테고리로 나눠 저장하세요. format / reasoning / retrieval / cascading 네 칸만 도입해도, 어느 처방을 먼저 적용해야 할지 자동으로 정해집니다.
- 휴먼 인 더 루프는 모든 단계에 박지 않습니다. 되돌리기 어려운 외부 동작 직전 한 곳에만 정확하게 박는 게 효과적입니다.
- 블로그·문서·내부 위키에 새 도구를 소개할 때, 이 글의 표처럼 루프 스택의 어느 칸을 채우는 도구인지를 함께 적어 두면 시간이 갈수록 누적 지식 지도가 됩니다.
참고자료
- xAI Launches /goal in Grok Build, Adding Long-Running Autonomous Execution With Built-In Verification for Multi-Step Coding Tasks — MarkTechPost
- Introducing /goal — xAI
- Cisco AI Introduces FAPO: Pipeline-Aware Prompt Optimization With Step-Level Failure Attribution and Claude Code Orchestration — MarkTechPost
- FAPO: Fully Autonomous Prompt Optimization of Multi-Step LLM Pipelines (arXiv)
- Human-in-the-Loop — LangChain Docs
- Evaluation Patterns for Deep Agents in Production — ZenML LLMOps Database
- Best Practices — OpenAI Codex
원문 출처
이 글은 자체 분석 인사이트입니다: 원문 보기
원문 출처: xAI Introducing /goal