출처: Asif Razzaq / Marktechpost
문서유형: 번역·해설
#AIAgent #AgentMemory #LLM #RAG #VectorDB
개요
LLM은 본래 기억이 없습니다. API 호출 한 번이 끝나면 직전 메시지를 모두 잊어버리죠. 단일 질문에는 문제가 없지만, 에이전트를 만드는 순간 이 한계가 곧바로 드러납니다. 에이전트는 여러 단계에 걸쳐 계획을 세우고 도구를 호출하면서 일을 끝내야 하니까요. 그 차이를 메우는 것이 메모리 시스템입니다. Marktechpost의 Asif Razzaq는 에이전트 메모리를 시간축(단기·장기) 과 형태(파라메트릭·비파라메트릭) 두 축으로 나누고, 실제 구현에서 자주 쓰이는 일곱 가지 유형을 정리했습니다.
핵심 요약
- LLM 자체는 stateless 입니다. 메모리는 상태가 없는 모델을 “경험을 축적하는 시스템”으로 바꿔주는 인프라입니다.
- 메모리는 형태(가중치에 새겨진 파라메트릭 vs 외부 텍스트인 비파라메트릭)와 시간(단기 vs 장기) 두 축으로 분류합니다.
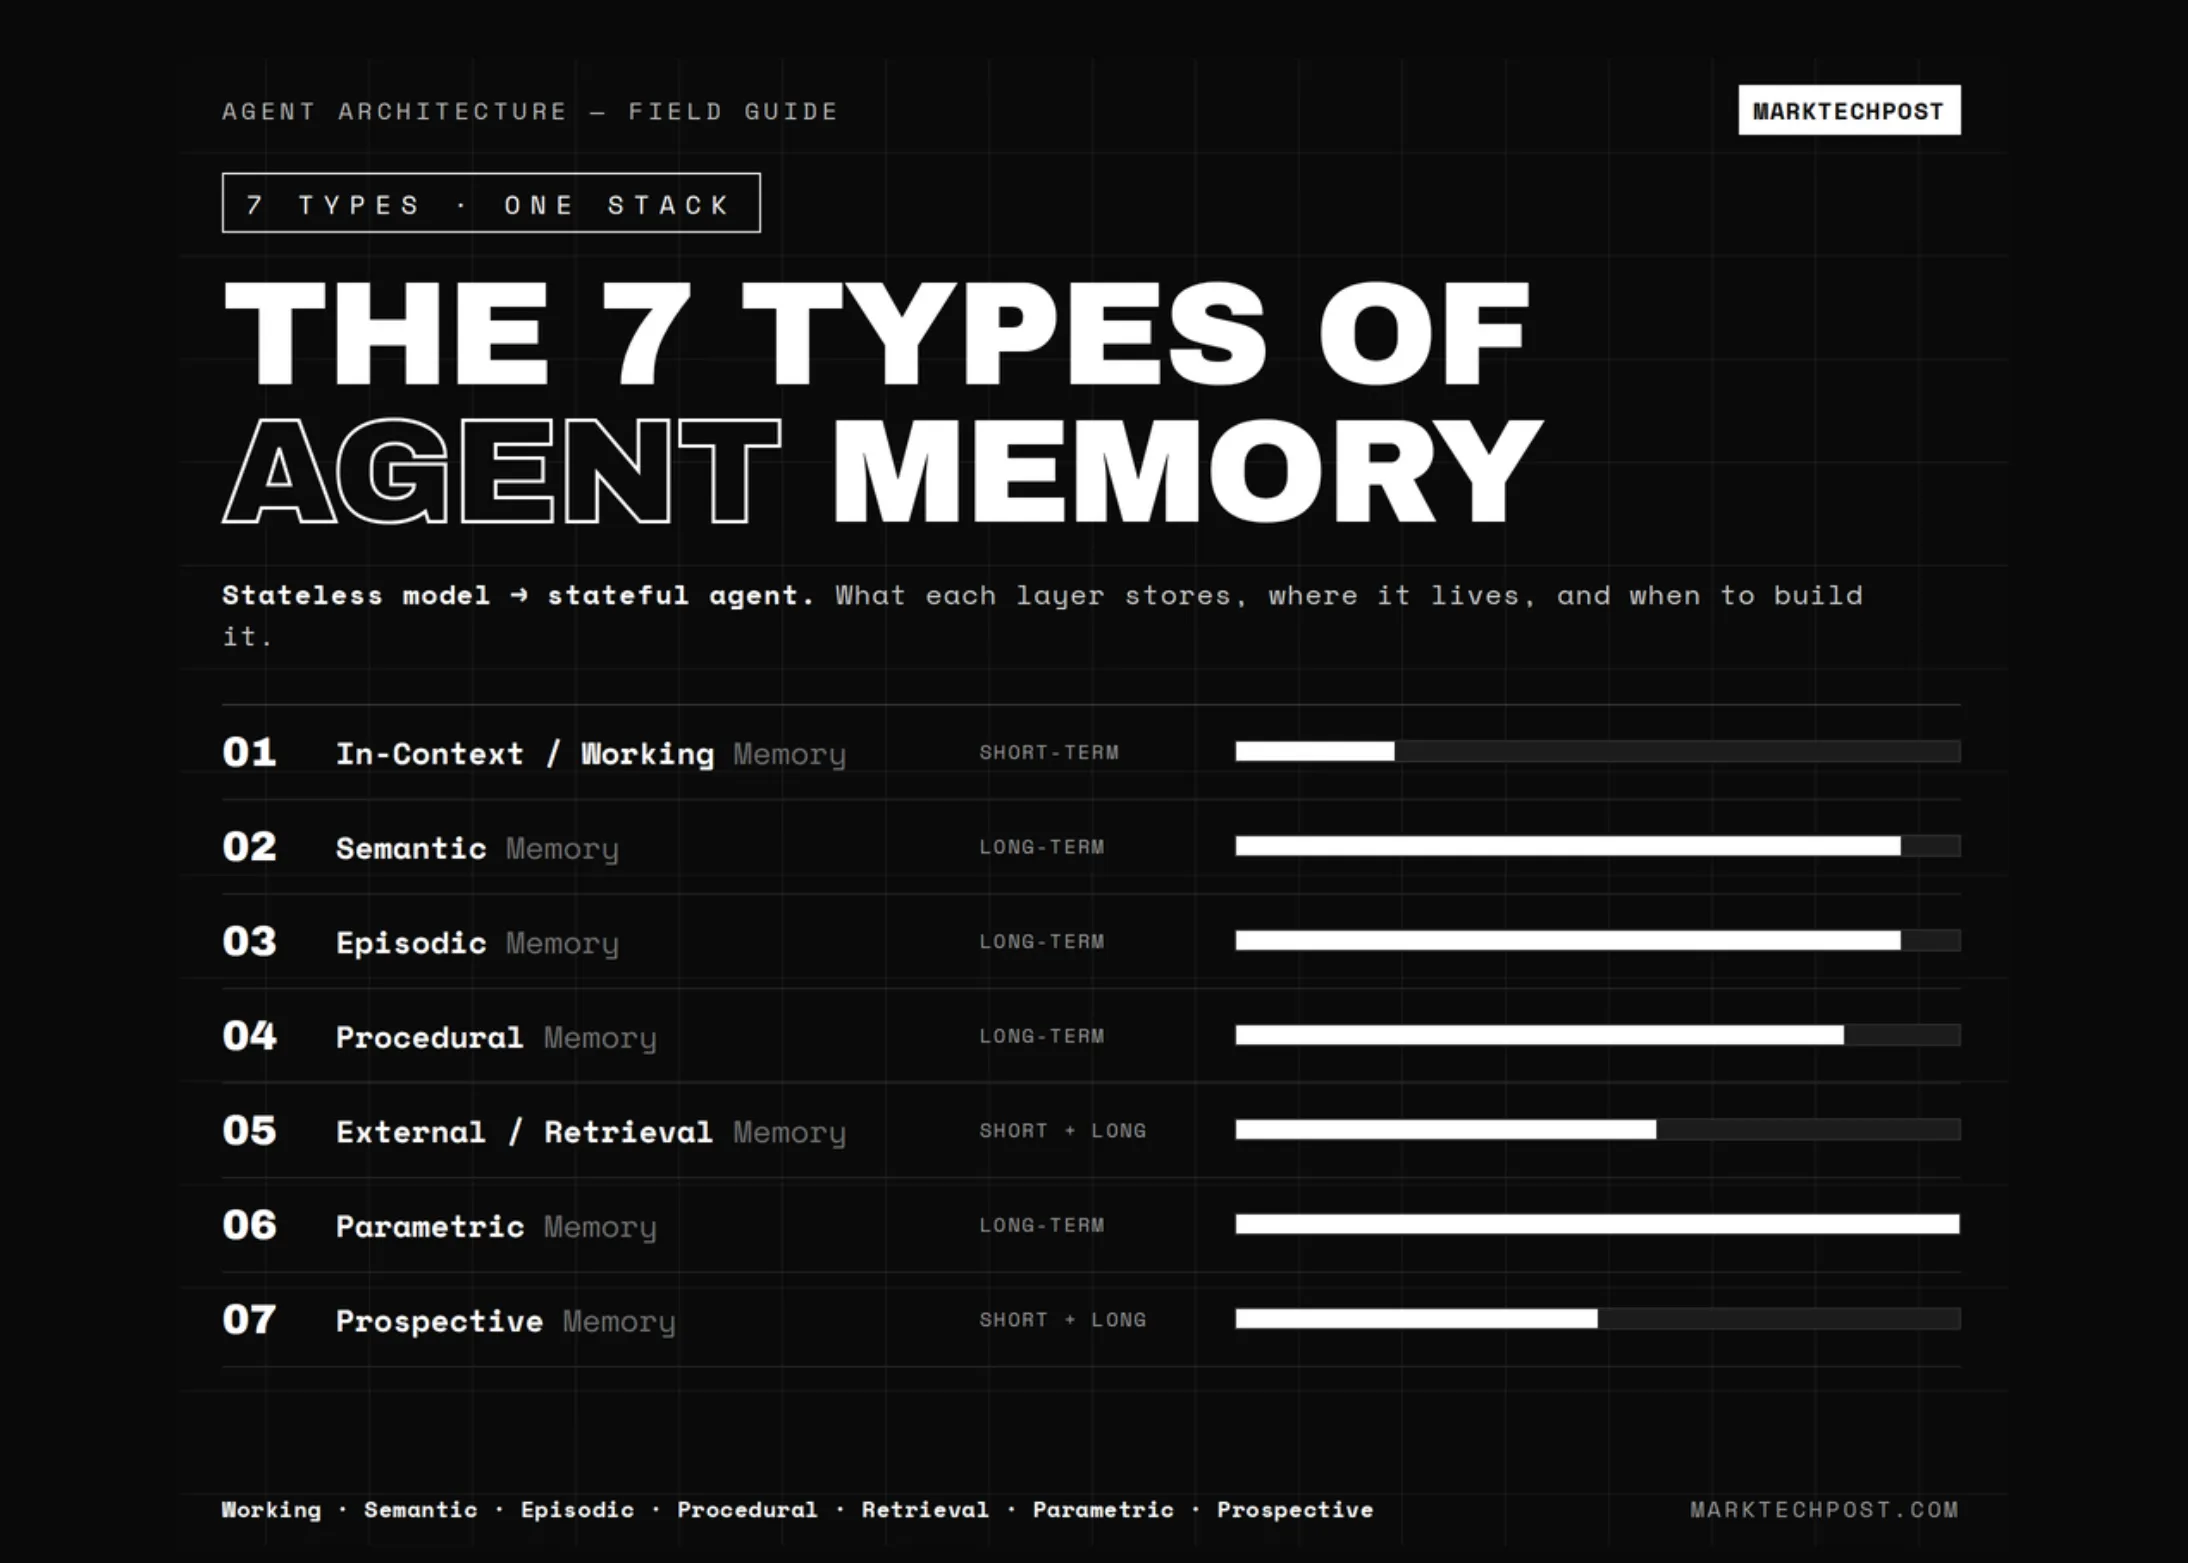
- 일곱 가지 유형은 작업 메모리, 의미 기억, 일화 기억, 절차 기억, 외부·검색 기억, 파라메트릭 기억, 전망 기억입니다.
- 실전에서는 일곱 가지를 한꺼번에 깔지 않습니다. 필요할 때마다 한 층씩 얹는 게 정석입니다.
- 한 에이전트에서 일곱 종류가 동시에 작동하는 예시를 통해, 어느 한 층이라도 빠지면 에이전트가 약해지는 이유를 확인할 수 있습니다.
에이전트 메모리란?
메모리는 모델의 추론 과정 사이에서 정보를 옮겨주는 모든 메커니즘을 말합니다. 일부는 컨텍스트 윈도우 안에서 살고, 일부는 외부 데이터베이스나 모델 가중치에 저장됩니다. 각 유형은 저장하는 정보의 종류와 보존 기간이 다릅니다.
기준은 두 가지입니다. 형태는 모델 가중치에 새겨진 파라메트릭 메모리인지, 텍스트로 외부에 저장되는 비파라메트릭 메모리인지를 가릅니다. 시간은 짧은 한 차례 대화에서만 유효한지(단기), 세션이 끝나도 살아남는지(장기)를 구분합니다. 아래 일곱 유형은 모두 이 두 축 위에 자리 잡습니다.
일곱 가지 메모리 유형
1. In-Context / Working Memory (단기)
모델이 지금 이 순간 컨텍스트 윈도우 안에서 보고 있는 모든 것입니다. 시스템 프롬프트, 최근 메시지, 도구 호출 결과, 추론 단계가 여기 들어갑니다. RAM이라고 생각하면 됩니다. 빠르고 필수이지만 휘발성이며 용량이 한정돼 있어서, 다른 모든 메모리 유형이 결국 이 공간을 두고 경쟁합니다.
2. Semantic Memory (장기)
사용자나 도메인에 관한 사실, 선호, 지식을 영구적으로 저장하는 층입니다. “이 사용자는 Python을 JavaScript보다 선호한다” 같은 항목이 들어가죠. 언제 학습됐는지와는 분리된, 잘 정돈된 에이전트의 백과사전이라고 보면 됩니다.
3. Episodic Memory (장기)
과거에 실제로 벌어진 사건을 기록합니다. 전체 대화, 작업 실행 로그, 무엇이 통했고 무엇이 실패했는지 같은 결과가 함께 남습니다. Reflexion이나 ExpeL 같은 시스템은 이걸로 사후 평가문을 만들어 다음 실행에 활용합니다.
4. Procedural Memory (장기)
에이전트가 “어떻게” 일을 처리하는지에 대한 지식입니다. 도구 사용 패턴, 워크플로, 행동 규칙이 포함됩니다. 백 번째 비밀번호 초기화를 처리하는 고객지원 에이전트는 매번 처음부터 추론하지 않습니다. 이미 학습된 절차를 그대로 실행합니다.
5. External / Retrieval Memory (단기 + 장기)
벡터 데이터베이스 같은 외부 저장소에 두었다가, 추론 시점에 유사도 검색으로 컨텍스트에 끌어오는 지식입니다. RAG가 정확히 이 층에 해당합니다. 검색 품질이 곧 답변 품질의 병목이 된다는 점이 가장 큰 특징입니다.
6. Parametric Memory (장기)
학습 단계에서 모델 가중치에 직접 새겨진 지식입니다. 언어 능력, 추론 패턴, 일반 상식이 모두 여기 들어 있습니다. 모델이 굳이 어디서 찾아오지 않고 가중치 안의 연관만으로 답을 만들어내죠. 단, 학습이 끝난 시점에 얼어붙는다는 한계가 있습니다.
7. Prospective Memory (단기 + 장기)
앞으로 해야 할 일을 기억하는 능력입니다. 에이전트가 계획만 세워두고 아직 실행하지 않은 작업을 추적합니다. 장기 호흡으로 굴러가는 멀티스텝 에이전트라면 이 층이 빠질 수 없습니다. 없으면 자기가 내건 약속을 잊어버립니다.
한눈에 비교하기
| 유형 | 시간 | 위치 | 저장 내용 | 대표 구현 |
|---|---|---|---|---|
| Working / In-context | 단기 | 컨텍스트 윈도우 | 프롬프트, 메시지, 도구 결과 | LLM 기본 |
| Semantic | 장기 | 외부 저장소 | 사실, 선호 | 벡터 DB / 프로파일 |
| Episodic | 장기 | 외부 저장소 | 과거 이벤트, 실행 로그 | 벡터 DB + 이벤트 로그 |
| Procedural | 장기 | 프롬프트 / 가중치 | 스킬, 워크플로 | 시스템 프롬프트 / 파인튜닝 |
| Retrieval / External | 양쪽 | 벡터 DB | 문서, 대화 청크 | RAG 파이프라인 |
| Parametric | 장기 | 모델 가중치 | 세계 지식, 언어 | 사전학습 / 파인튜닝 |
| Prospective | 양쪽 | 상태 저장소 | 미래 의도, 예약 작업 | 태스크 큐 / 스케줄러 |
한 에이전트에서 일곱 가지가 동시에 작동하는 예시
자율적인 시장 분석 에이전트를 상상해봅시다. 한 번의 작업에서 일곱 가지 메모리가 동시에 움직입니다.
- Parametric 이 기본 추론 능력과 언어를 깔아줍니다.
- Retrieval 이 벡터 저장소에서 현재 시장 데이터를 끌어옵니다.
- Semantic 이 사용자가 선호하는 보고서 포맷을 기억해 둡니다.
- Episodic 이 과거에 신뢰할 수 있었던 소스를 떠올립니다.
- Procedural 이 “시장 규모 → 경쟁 환경 → 리스크” 같은 섹션 순서를 굴립니다.
- Prospective 가 다음 주에 후속 초안을 작성하도록 일정을 잡습니다.
- Working 이 이 모든 걸 모아 실제 추론 컨텍스트로 조립합니다.
어느 한 층이라도 빠지면 에이전트는 곧바로 약해집니다. 일곱 가지가 서로 다른 일을 맡고 있기 때문입니다.
최소 메모리 스택 한 컷
Python으로 가장 단순한 스케치를 그려보면 이렇습니다. 작업·의미·일화·절차 메모리를 각각 별도의 저장소로 둔 모습입니다.
from datetime import datetime

# 의미 기억: 사용자에 대한 영구 사실
semantic_memory = {"diet": "vegetarian", "language_pref": "Python"}

# 일화 기억: 과거 이벤트와 결과 로그
episodic_memory = [
    {"timestamp": datetime.now(),
     "event": "recipe_request",
     "result": "user liked a 20-minute meal"},
]

# 절차 기억: 에이전트가 실행할 수 있는 스킬
def suggest_recipe(diet):
    return f"a quick {diet} recipe"

procedural_memory = {"suggest_recipe": suggest_recipe}

# 작업 기억: 매 추론마다 새로 조립
def build_context(query):
    diet = semantic_memory["diet"]
    last = episodic_memory[-1]["result"]
    skill = procedural_memory["suggest_recipe"]
    return (
        f"Query: {query}\n"
        f"Semantic: user is {diet}\n"
        f"Episodic: last time, {last}\n"
        f"Procedural: returning {skill(diet)}"
    )

print(build_context("suggest dinner"))
운영 환경에서는 장기 저장소가 벡터 데이터베이스로 옮겨갑니다. 패턴은 그대로입니다. 장기 메모리에 쓰고, 추론 시점에 작업 메모리로 끌어와 그 위에서 추론합니다.
실전 빌드 순서
처음부터 일곱 가지를 다 만들지 마세요. 실제 필요가 생길 때만 한 층씩 얹어야 복잡도가 통제됩니다.
- Working memory 부터. 모델에 기본 탑재돼 있습니다. 단순한 에이전트는 이걸로 끝납니다.
- Semantic memory 추가. 세션을 넘어 사용자를 기억해야 할 때 처음으로 붙이는 장기 메모리입니다.
- Episodic / Procedural / Prospective 는 그다음입니다. 미리 계획해야 하거나, 실패에서 배워야 하거나, 시간이 지남에 따라 적응해야 할 때만 추가합니다.
- Parametric / Retrieval 은 사실상 이미 있습니다. Parametric은 베이스 모델 자체이고, Retrieval은 RAG를 붙이는 순간 같이 따라옵니다.
실무자가 볼 핵심 포인트
- 에이전트 메모리 = 인프라입니다. 모델만 바꿔서 풀리는 문제가 아닙니다.
- 어떤 메모리를 붙일지는 “이 제품이 사용자에게 어떤 약속을 하는가”에서 거꾸로 결정합니다. 세션을 넘어 사용자를 기억해야 한다면 Semantic, 실패에서 배워야 한다면 Episodic, 다음 주를 약속한다면 Prospective입니다.
- Retrieval 메모리는 강력하지만 검색 품질이 곧 답변 품질의 천장입니다. RAG 도입 전에 임베딩·랭킹·평가 체계를 함께 설계해야 합니다.
- Procedural 메모리는 시스템 프롬프트로 시작해, 안정화된 워크플로는 파인튜닝으로 굳히는 경로가 자연스럽습니다.
- 일곱 가지를 한꺼번에 깔면 복잡도가 폭발합니다. 필요가 증명될 때마다 한 층씩 얹는 보수적인 접근이 가장 빠른 길입니다.
원문 출처
원문 보기 — Asif Razzaq, Marktechpost (2026-06-21)