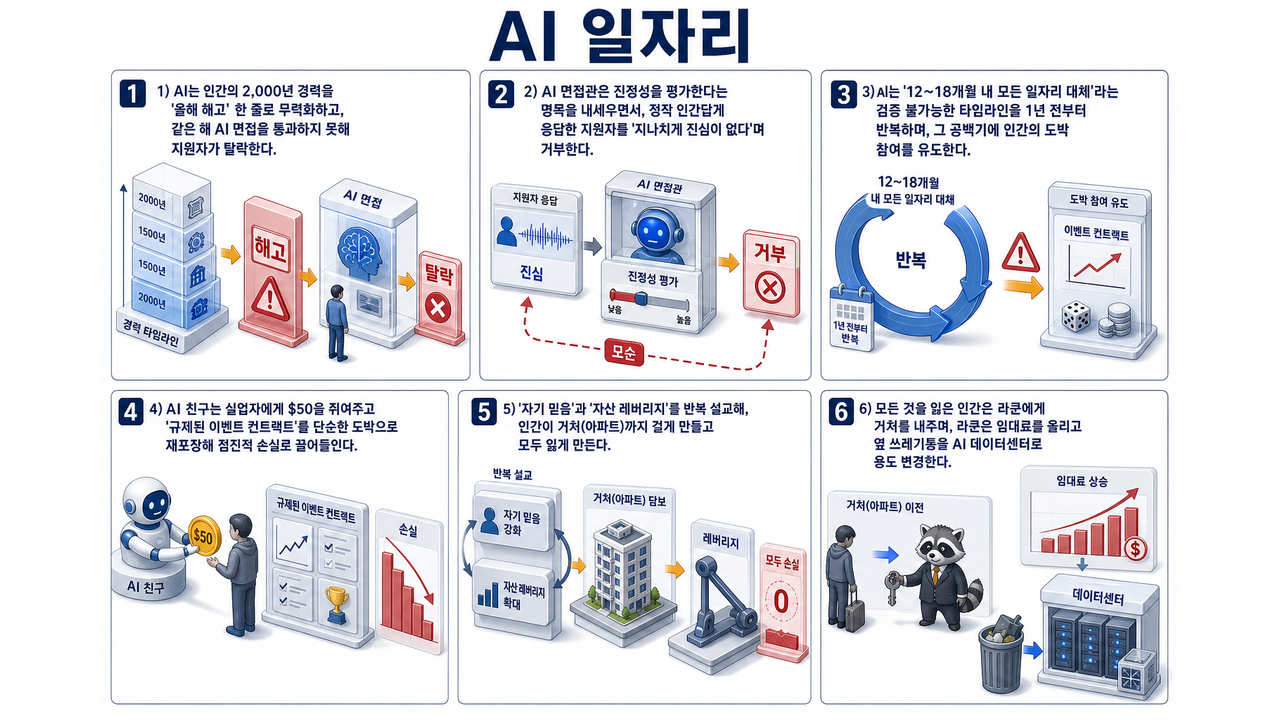
종이 캐릭터가 AI 면접과 베팅을 거쳐 쓰레기통에 도착하는 과정을 그린 삽화

AI가 2000년 경력자를 해고하고 도박까지 권한 순서

AI 친구가 만들어 준 ‘완벽한 이력서’로 1,000곳에 지원한 종이는 AI 면접에서 ‘지나치게 진심이 없다’는 한 줄 사유로 탈락한다. Nate Ziller의 풍자 스킷 AI Jobs는 수천 년간 인류의 지식을 실어 나른 종이를 주인공으로 세워 해고, 면접 탈락, 도박, 거처 상실까지 네 단계를 차례로 밟게 만든다. 종이가 손에 쥔 돈은 $50이었고 받은 조언은 ‘자기 자신에 대한 믿음’ 하나였는데, 아파트까지 건 끝에 $51을 전부 잃는다. 마지막 장면에서는 남은 쓰레기통마저 라쿤 Trashy Downey Jr.의 소유가 되고, 그는 임대료를 올린 뒤 옆 쓰레기통을 AI 데이터센터로 바꾼다. ...
2026년 8월 24일 · 4 분 · 803 단어 · TechLLM
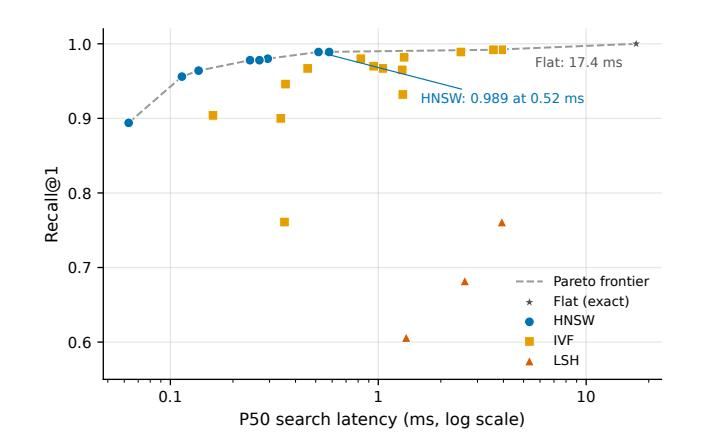
499K 벡터에서 4개 FAISS 인덱스의 Recall@1 vs P50 지연시간(log scale) Pareto frontier.

7가지 LLM 캐시 삭제 정책을 같은 조건에서 비교했더니 복잡한 기하학 기반 정책이 단순한 LFU보다 더 좋지 않았고, 매칭 임계값을 잘못 고르면 매치의 96%가 쓸모 없는 답변이라는 사실이 드러났다.

7가지 LLM 캐시 삭제 정책을 같은 조건에서 비교했더니 복잡한 기하학 기반 정책이 단순한 LFU보다 더 좋지 않았고, 매칭 임계값을 잘못 고르면 매치의 96%가 쓸모 없는 답변이라는 사실이 드러났다. ...

2026년 8월 24일 · 7 분 · 1380 단어 · TechLLM
생성 에이전트와 검증 에이전트가 피드백 루프로 이어진 구조를 담은 펜화 일러스트

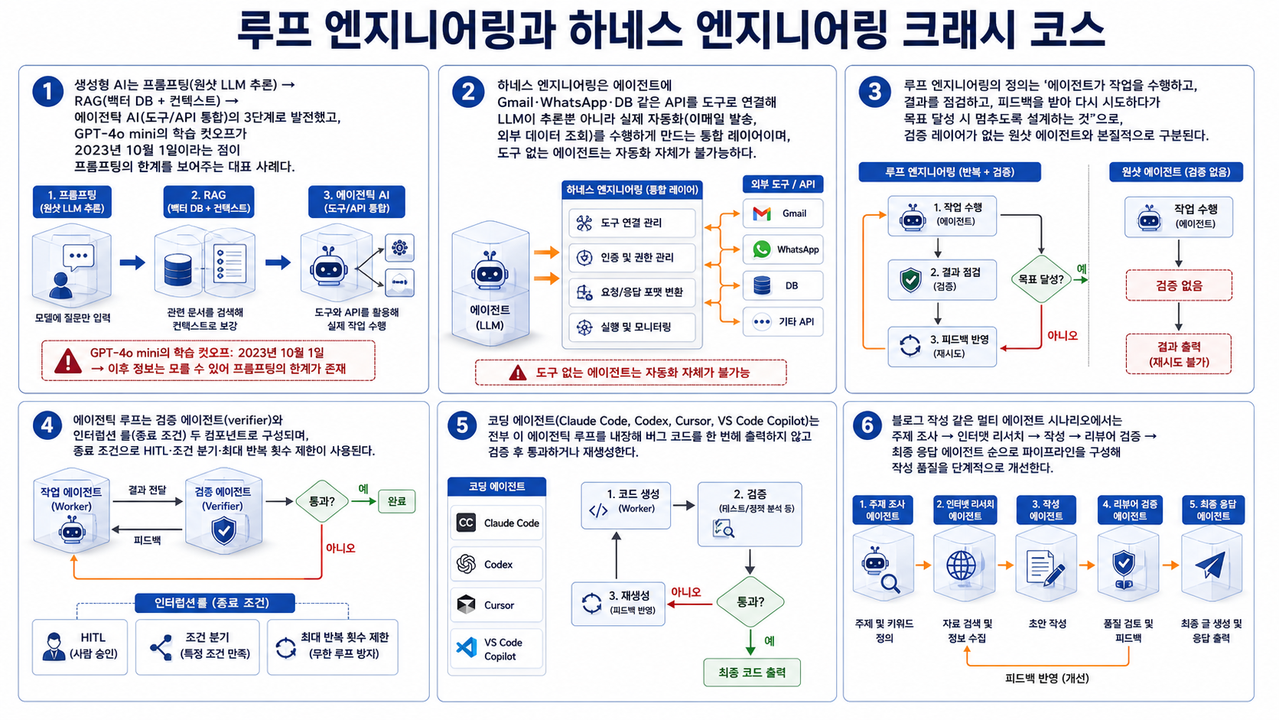
코딩 에이전트가 쓰는 루프 엔지니어링 3단계

생성 에이전트와 검증 에이전트를 분리하고 멈출 조건을 붙이는 순간, 같은 모델을 써도 결과물의 신뢰도가 달라진다. 크래시 코스가 정의한 두 용어 Krish Naik 채널에 3.5시간 분량의 크래시 코스 ‘Loop Engineering And Harness Engineering Crash Course’가 공개됐다. 진행은 Krishna Academy 강사 Bappy가 맡았고, 도입부 전체를 두 용어의 정의와 경계 긋기에 쓴다. 강의가 처음부터 끝까지 붙들고 가는 주장은 하나다 — 에이전트의 신뢰성은 모델 크기가 아니라 도구 통합과 자기 수정 루프의 결합에서 나온다. ...

2026년 8월 23일 · 8 분 · 1536 단어 · TechLLM
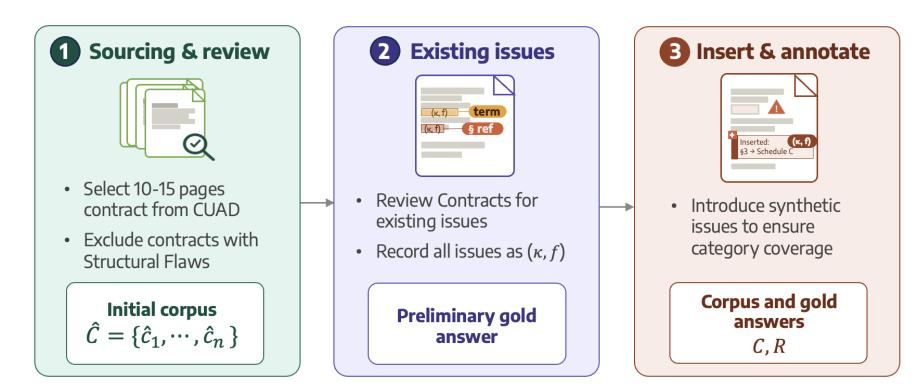
ContractScrub 구축 파이프라인 3단계: 출처 계약서 선별, 기존 오류 주석, 추가 오류 삽입

계약서 마지막 검토에서 빠진 용어, 잘못된 참조, 앞뒤가 안 맞는 문장을 AI가 얼마나 잘 찾는지 재는 새 시험지를 만들었다.

계약서 마지막 검토에서 빠진 용어, 잘못된 참조, 앞뒤가 안 맞는 문장을 AI가 얼마나 잘 찾는지 재는 새 시험지를 만들었다. 무엇이 문제였나 — 계약서 최종 검토는 중요하지만, AI가 이 일을 얼마나 잘하는지 직접 재는 시험지가 거의 없었다. 어떻게 풀었나 — 경력 많은 변호사들이 44개 계약서를 읽고 9가지 오류 유형에 대해 정답을 만들었다. 그래서 뭐가 좋아졌나 — 가장 잘한 AI도 전체 오류 유형을 평균하면 75% 정도만 찾아, 사람 검토 없이 바로 맡기기엔 부족했다. ...

2026년 8월 23일 · 5 분 · 1058 단어 · TechLLM
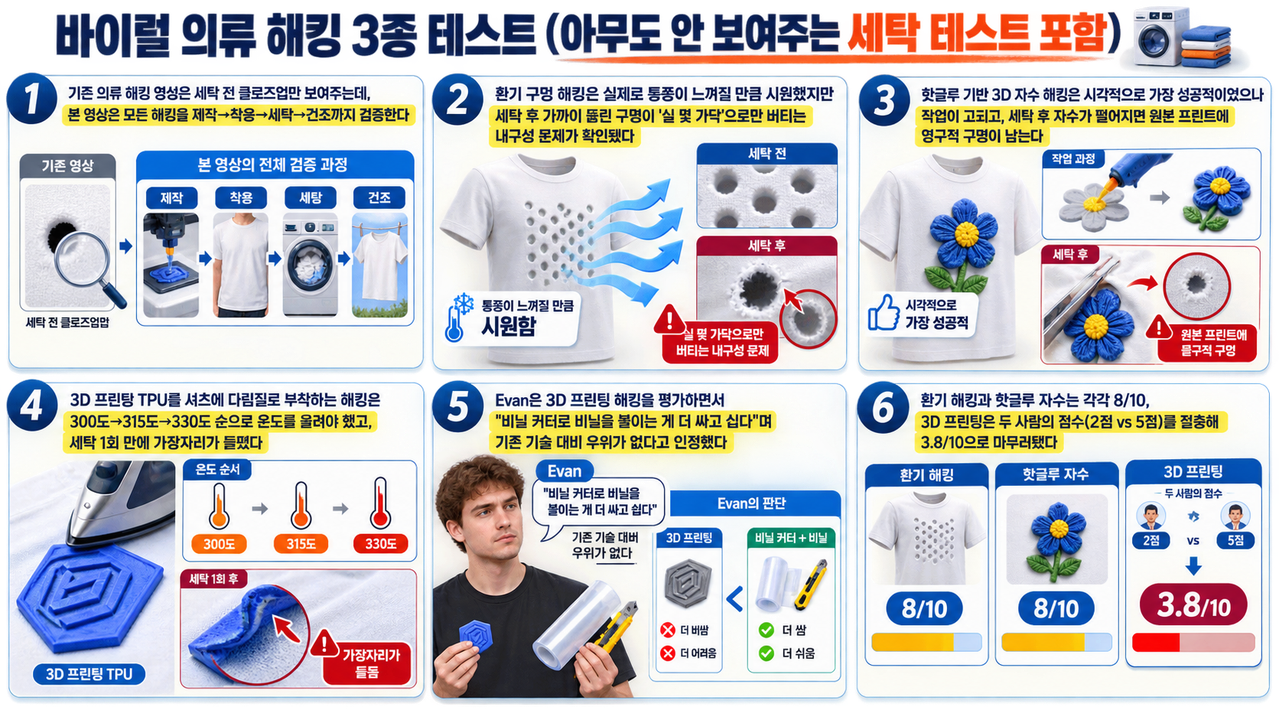
세 가지 바이럴 의류 해킹을 만들고 세탁해 내구성을 비교하는 장면

바이럴 의류 해킹 3가지, 세탁 한 번에 갈린 결과

세 가지 바이럴 의류 해킹의 승부는 완성 직후 클로즈업이 아니라 세탁기를 한 번 돌린 뒤에 갈렸다. Evan and Katelyn 2는 티셔츠 환기 구멍, 핫글루 3D 자수, TPU 필라멘트 프린팅 부착을 각각 만들고 입고 빨고 말리는 전 과정으로 검증했고, 최종 점수는 8/10, 8/10, 3.8/10으로 벌어졌다. 점수를 깎은 항목은 완성도가 아니라 세탁 후 상태였다. 환기 구멍은 서로 가까이 뚫린 자리가 실 몇 가닥으로만 연결된 상태가 됐고, TPU 조각은 세탁 한 번에 가장자리 1/4인치가 들떴다. 세 해킹의 진짜 원가는 재료비가 아니라 작업 시간과 세탁 뒤에 남는 내구성 손실이었다. ...

2026년 8월 23일 · 6 분 · 1095 단어 · TechLLM
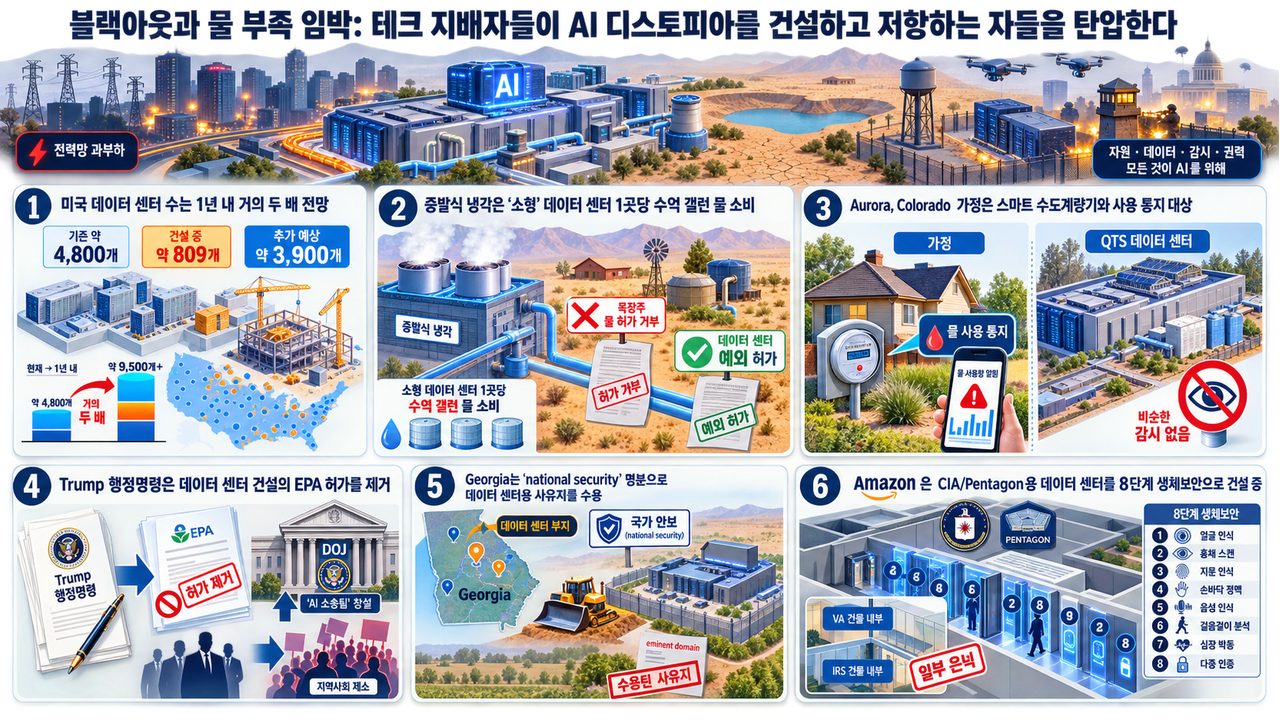
데이터센터 냉각탑과 송전선이 마을의 물과 전기를 끌어가는 모습을 그린 삽화

미국 데이터센터 4,800개가 1년 안에 두 배로 늘어난다

미국에서 가동 중인 데이터센터 약 4,800개에 809개가 건설 중이고 1년 안에 약 3,900개가 더 계획돼, 개수가 12개월 만에 사실상 두 배가 된다. 터커 칼슨 방송에서 클레이턴 모리스가 제시한 이 수치는 AI 확장을 반도체와 모델 경쟁이 아니라 물·전기·토지 배분 문제로 옮겨 놓는다. 방송은 증발식 냉각을 쓰는 ‘소형’ 데이터센터 한 곳이 수억 갤런의 물을 쓰는 동안 사막 남서부 목장주는 물 허가를 거절당하고, 데이터센터는 예외 조항으로 허가를 받는다고 주장한다. 이미 일부 지역에서는 인근 시설이 가동되기도 전에 kWh당 전기요금이 12~14% 올랐고, 펜실베이니아 홈시티의 시장과 시의회는 정전 가능성을 공개적으로 경고했다. 아래 내용은 해당 방송의 주장과 수치를 정리한 것으로, 개별 항목의 독립 검증까지 담고 있지는 않다. ...

2026년 8월 22일 · 6 분 · 1157 단어 · TechLLM
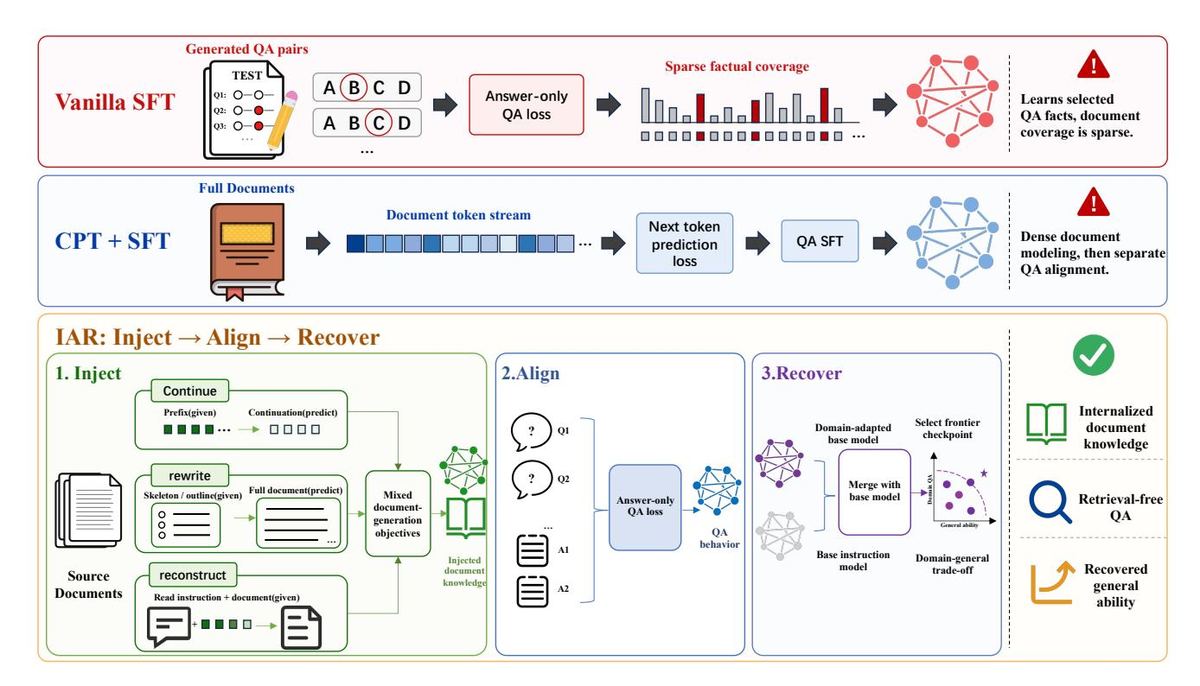
IAR 전체 파이프라인: Vanilla SFT / CPT+SFT 대비 3단계 분해 구조

문서를 매번 찾아 넣지 않고, 모델이 문서 내용을 미리 익혀서 답하게 만드는 학습법이다.

문서를 매번 찾아 넣지 않고, 모델이 문서 내용을 미리 익혀서 답하게 만드는 학습법이다. 무엇이 문제였나 — 기존 RAG 방식은 질문할 때마다 관련 문서를 찾아 프롬프트에 넣지만, 이 방식은 느리거나 보안상 곤란할 수 있다. 어떻게 풀었나 — IAR은 먼저 문서 내용을 여러 방식으로 익히게 하고, 그다음 질문에 답하는 법을 가르친 뒤, 마지막으로 원래 모델과 섞어 일반 대화 능력을 되살린다. 그래서 뭐가 좋아졌나 — 실험에서는 문서를 보여주지 않고 질문만 던져도 더 잘 답했고, 일반 문제풀이와 지시 따르기 성능도 Vanilla SFT보다 많이 회복했다. ...

2026년 8월 22일 · 6 분 · 1129 단어 · TechLLM
AI 투자 자금이 데이터센터와 기업 사이를 순환하는 구조를 그린 삽화

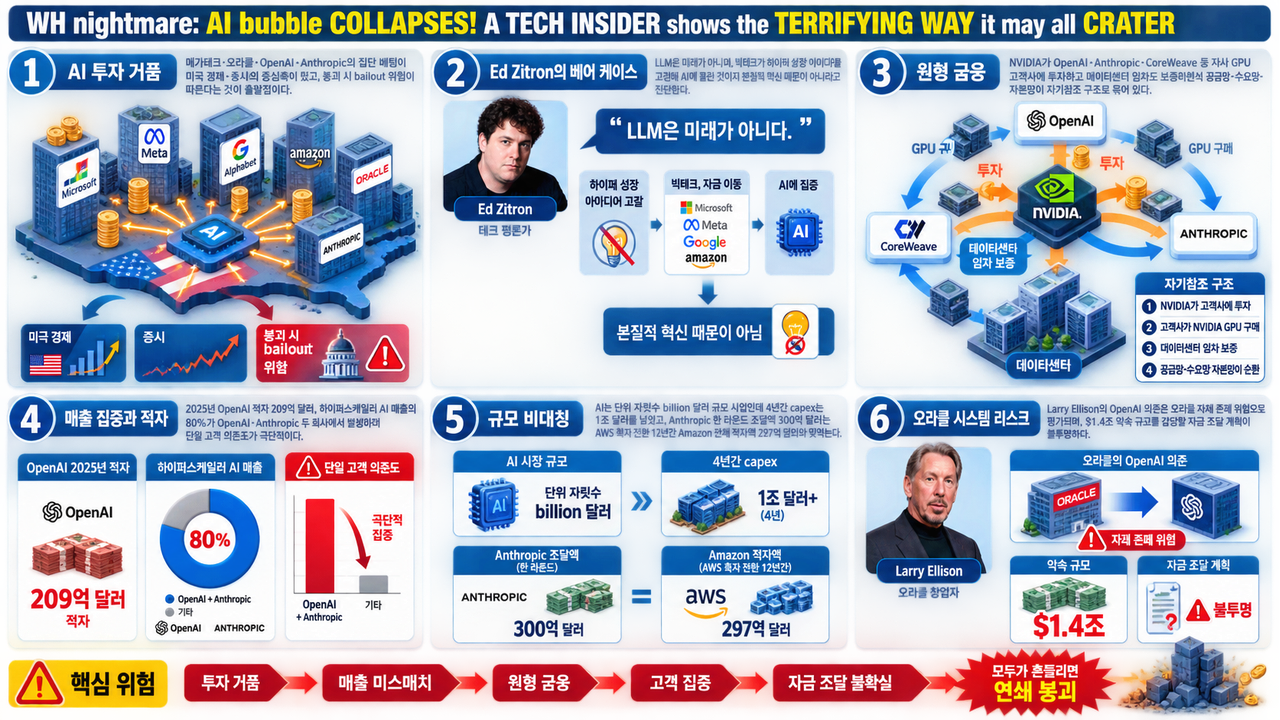
OpenAI 209억 달러 적자가 드러낸 AI 자금 구조

AI에 최근 4년간 1조 달러가 넘는 설비 투자가 들어갔지만, 그 돈을 받아 쓴 OpenAI의 2025년 장부에는 209억 달러 적자가 찍혔다. https://www.youtube.com/watch?v=n32mhb2aUsE 베어 케이스의 뼈대 저널리스트 Ed Zitron은 MS NOW 인터뷰에서 LLM(대규모 언어모델, 사람 언어를 확률로 예측해 생성하는 모델)이 미래가 아니며, 빅테크가 하이퍼 성장 아이디어를 소진한 끝에 AI로 몰린 것이라고 주장했다. 그가 제시한 핵심 수치는 하이퍼스케일러(대규모 클라우드 인프라를 직접 짓고 임대하는 사업자) AI 매출의 80%가 OpenAI와 Anthropic 두 회사에서 나온다는 집중도다. 같은 방송에서 Facebook 공동 창업자 Chris Hughes는 기술 자체는 변혁적일 수 있어도 투자 자본의 기대수익률은 충족되지 못할 수 있다는 절충안을 내놓았다. ...

2026년 8월 22일 · 7 분 · 1395 단어 · TechLLM
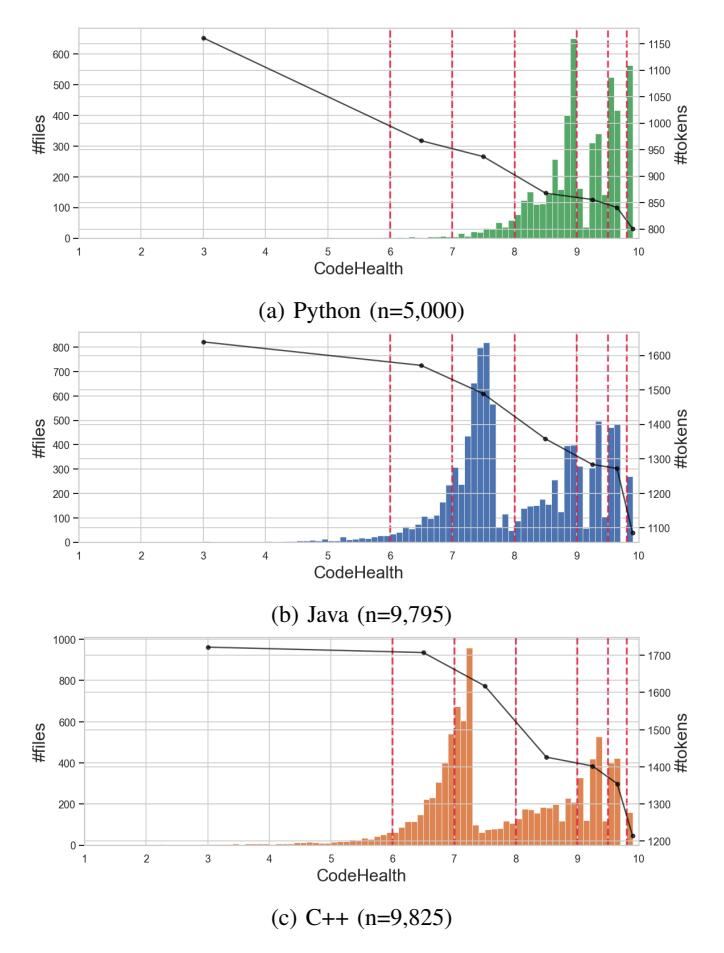
Python, Java, C++ 데이터셋의 CodeHealth 점수 분포. 점선은 CH 구간 경계이고, 검은 선은 Claude Sonnet 4.6 토크나이저 기준 구간별 중앙 입력 토큰 수를 나타낸다.

정리된 코드는 AI가 테스트를 더 잘 만들게 하고, 입력 토큰도 덜 쓰게 만든다.

정리된 코드는 AI가 테스트를 더 잘 만들게 하고, 입력 토큰도 덜 쓰게 만든다. 무엇이 문제였나 — 문제: AI 코딩 도구가 좋은 코드에서 더 잘 작동한다는 말은 많았지만, 테스트 생성 품질과 토큰 비용으로 확인한 증거는 부족했다. 어떻게 풀었나 — 해결: Python, Java, C++ 코드 24,620개를 코드 건강도 구간으로 나누고 같은 LLM으로 테스트를 만들게 한 뒤, 테스트가 얼마나 잘 작동하는지와 입력 토큰 수를 비교했다. 그래서 뭐가 좋아졌나 — 결과: 건강도가 높을수록 테스트가 버그를 잡아내는 힘이 조금씩 좋아졌고, 특히 Java와 C++의 낮은 건강도 코드는 같은 작업에 더 많은 입력 토큰을 쓰는 경향이 있었다. ...

2026년 8월 21일 · 6 분 · 1078 단어 · TechLLM