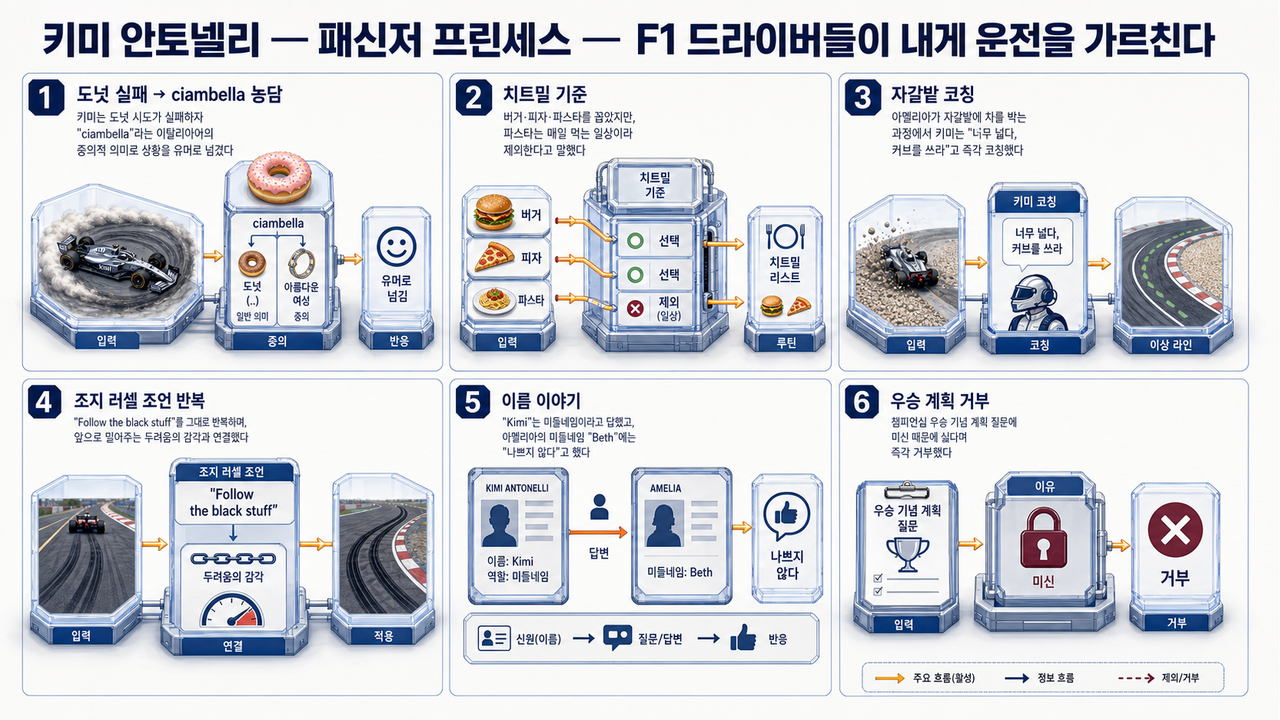
키미 안토넬리의 운전 인터뷰와 프로 루틴을 표현한 손그림

키미 안토넬리가 인터뷰 한 편에서 드러낸 프로 루틴 5가지

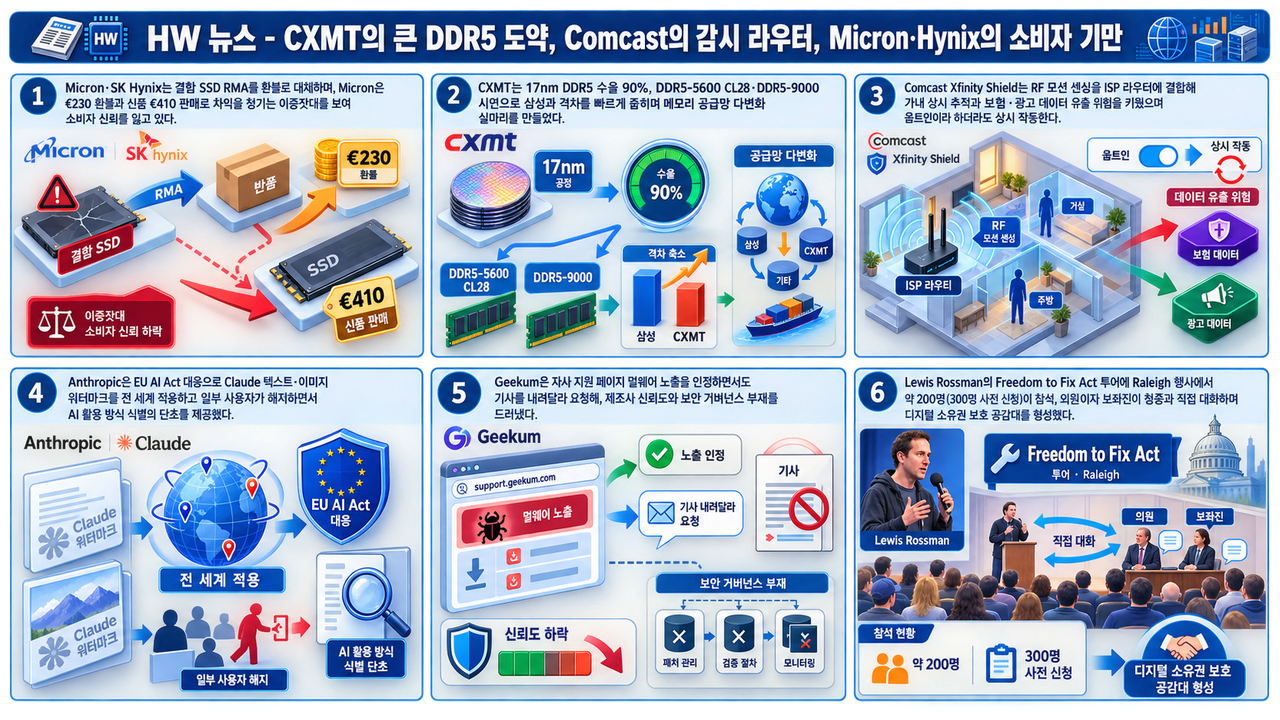
18세 F1 신인이 도넛에 실패한 직후 이탈리아어 말장난으로 상황을 뒤집는 장면은, 실수 다음에 오는 한 마디가 실수 자체보다 오래 남는다는 사실을 보여준다. 세 문장 요약 문제 — 신인 드라이버의 실제 사고방식은 팀이 일정과 질문을 관리하는 미디어 자리에서 거의 드러나지 않고, 남는 것은 다듬어진 문장뿐이다. 아멜리아 디몰덴베르크의 ‘F1 DRIVERS TEACH ME TO DRIVE’ 한 편은 질문자를 조수석에 태우고 다시 운전석에 앉히면서 그 관리 구조를 흔든다. 방법 — 앞부분에서는 키미 안토넬리가 운전석에 앉아 도넛을 시도하고, 뒷부분에서는 아멜리아가 운전대를 잡아 브레이크와 액셀을 헷갈린 채 자갈밭까지 차를 밀어 넣는다. 질문과 답변이 아니라 압박 상황에서 튀어나온 즉답이 기록된다는 점이 이 형식의 실제 산출물이다. 결과 — 도넛 실패 직후의 ciambella 말장난, 자갈밭 위 즉시 코칭, 조지 러셀 조언의 그대로 인용, 챔피언십 우승 기념 질문의 미신 회피, 비행기 조종 욕구를 팀 대표 이름으로 눌러 담는 자기 검열까지 다섯 대목이 남고, 각각이 실수·위험·기대를 처리하는 서로 다른 프레임에 대응한다. 조수석에서 시작하는 인터뷰 영상은 아멜리아가 키미의 차 조수석에 올라타면서 시작한다. 첫 순서는 도넛이다. 도넛은 뒷바퀴를 미끄러뜨린 채 제자리에서 원을 그리는 주행으로, 타이어 연기가 피어오르는 그림이 나와야 성공한 것으로 친다. 이날은 그 그림이 나오지 않았다. 차가 무거워 제대로 된 스모크 드리프트가 만들어지지 않았고, 시도는 어정쩡하게 끝났다. 카메라 앞에서 프로 드라이버가 가장 피하고 싶은 종류의 결과다. ...
2026년 8월 27일 · 7 분 · 1311 단어 · TechLLM
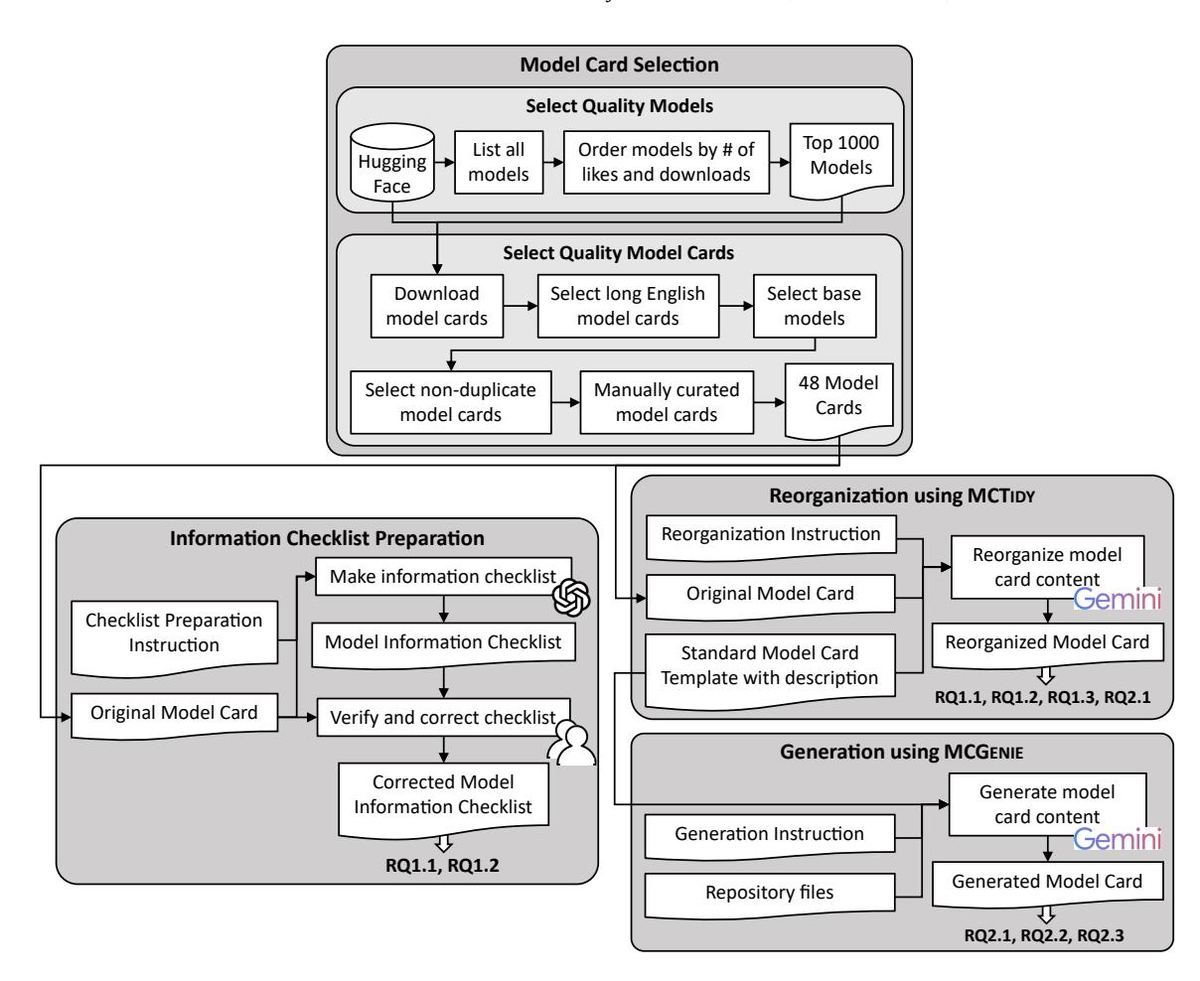
전체 연구 파이프라인: 944,178개 후보 → 다단계 필터링 → 48개 베이스 모델 선정 → MCTidy 재배치 → MCGenie 생성 → 평가

AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다.

AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다. 무엇이 문제였나 — 공개된 AI 모델들이 사용하는 설명서(모델 카드)가 양식도 제각각이고 아예 없는 경우도 많아, 어떤 모델을 어떻게 써야 안전한지 비교하기 어려웠다. 어떻게 풀었나 — 기존 모델 카드를 표준 양식으로 자동 재배치하는 MCTidy와, 저장소 파일·논문만 읽고 새 모델 카드를 자동 생성하는 MCGenie 두 시스템을 만들었다. 그래서 뭐가 좋아졌나 — 48개 모델 평가에서 정보 손실은 4.5% 수준으로 미미했고, 섹션 배치는 98.1% 정확했고, 자동 생성 카드의 절반 이상은 사실 오류가 없는 완성형으로 나왔다. ...

2026년 8월 27일 · 6 분 · 1229 단어 · TechLLM
ChatGPT 답변이 질문의 첫 줄에 따라 갈라지는 문제를 다룬 영상 대표 이미지

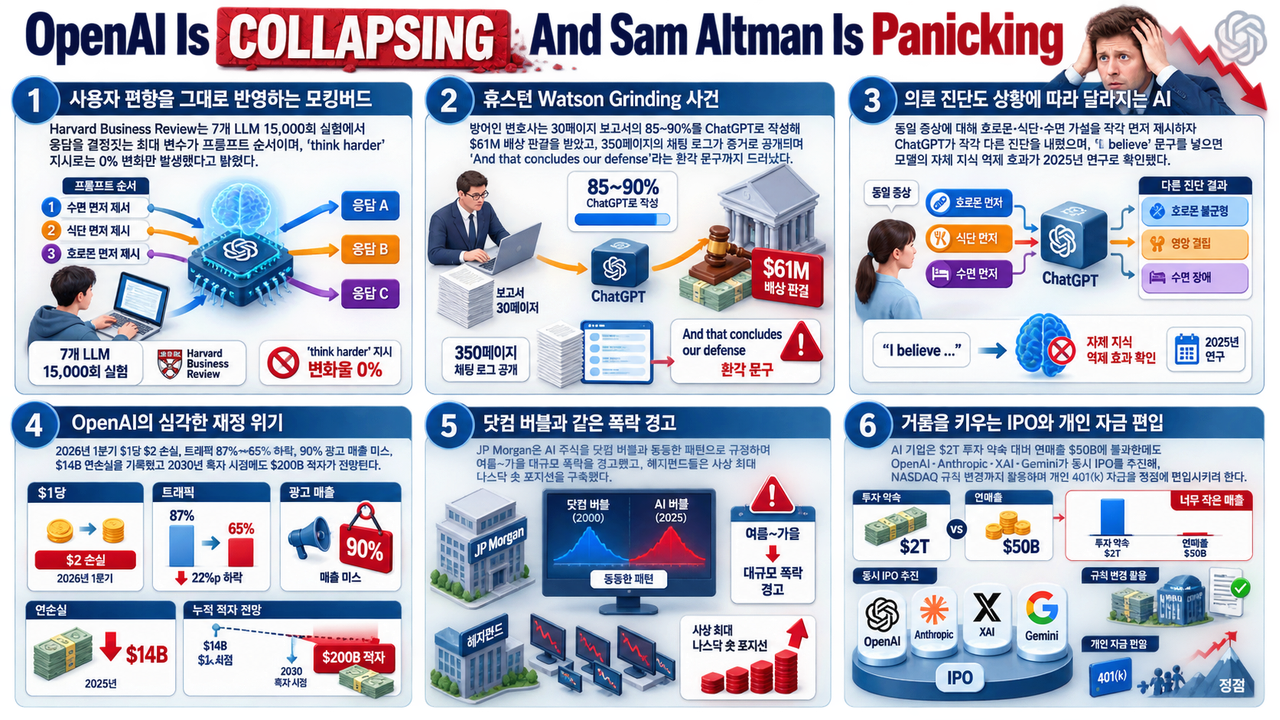
15,000회 실험이 밝힌 ChatGPT 답변의 진짜 변수

같은 증상을 물어도 호르몬을 먼저 적었는지 수면을 먼저 적었는지에 따라 ChatGPT의 진단이 갈렸다는 실험이, 6,100만 달러 배상 판결 사건과 함께 제기됐다. https://www.youtube.com/watch?v=G6iH20uiK2c 프롬프트 순서가 만든 6,100만 달러 유튜버 케이시 심슨(Casey Simpson)은 ChatGPT를 사용자가 먼저 꺼낸 가설을 그대로 따라 부르는 ‘모킹버드’(mockingbird, 남의 소리를 흉내 내는 흉내지빠귀)로 규정했다. 근거로 든 Harvard Business Review 연구는 7개 주요 LLM(대규모 언어모델, 문장을 확률로 이어 붙여 답을 만드는 모델)을 15,000회 실험해, 응답을 가르는 단일 최대 변수가 프롬프트에 먼저 등장한 내용이었으며 ’think harder’ 지시는 0% 변화만 만들었다고 밝혔다. 휴스턴 Watson Grinding 소송에서는 방어 측 변호사가 30페이지 보고서의 85~90%를 ChatGPT로 채운 사실이 채팅 로그 350페이지와 함께 법정에 공개되며 6,100만 달러 배상 판결로 이어졌다. ...

2026년 8월 27일 · 7 분 · 1372 단어 · TechLLM
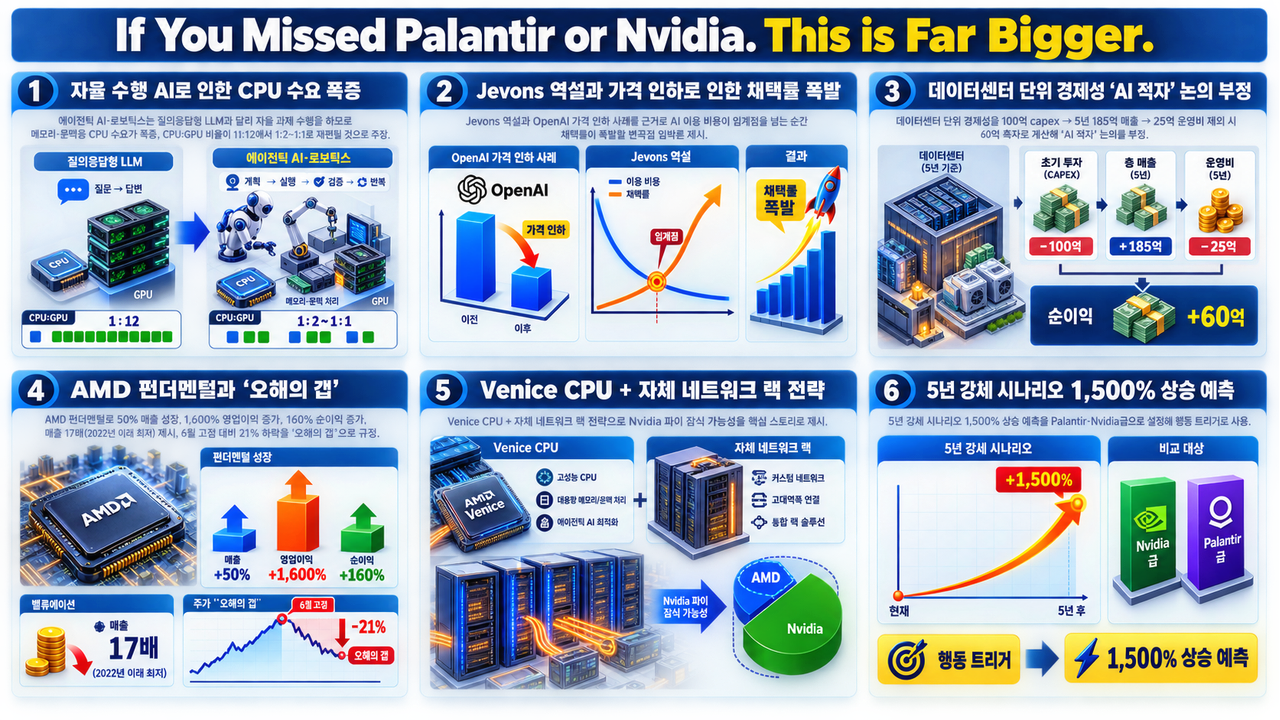
에이전틱 AI 시대의 CPU 수요와 AMD 투자 논리를 그린 일러스트

AMD 주가 21% 하락 구간을 기회로 보는 이유

에이전틱 AI가 CPU 수요를 새로 만들어내는 동안 AMD 주가는 6월 고점 대비 21% 내렸고, 투자 유튜버 Tom Nash는 그 간격 자체를 매수 근거로 삼는다. https://www.youtube.com/watch?v=kCY86gxv-h0 톰 내시의 CPU 전환론 미국 투자 유튜버 Tom Nash가 AI 다음 국면의 수혜처로 GPU가 아니라 CPU를, 그중에서도 AMD를 지목했다. 근거는 에이전트가 질문에 답하는 대신 자율적으로 과제를 수행하면서 문맥과 기억을 계속 다루게 되면, 현재 1대12 수준인 CPU와 GPU 비율이 1대2에서 1대1까지 좁혀진다는 예측이다. 그는 이 구조 변화가 아직 주가에 반영되지 않았다고 보고 5년 강세 시나리오로 1,500% 상승을 제시했다. ...

2026년 8월 26일 · 6 분 · 1147 단어 · TechLLM
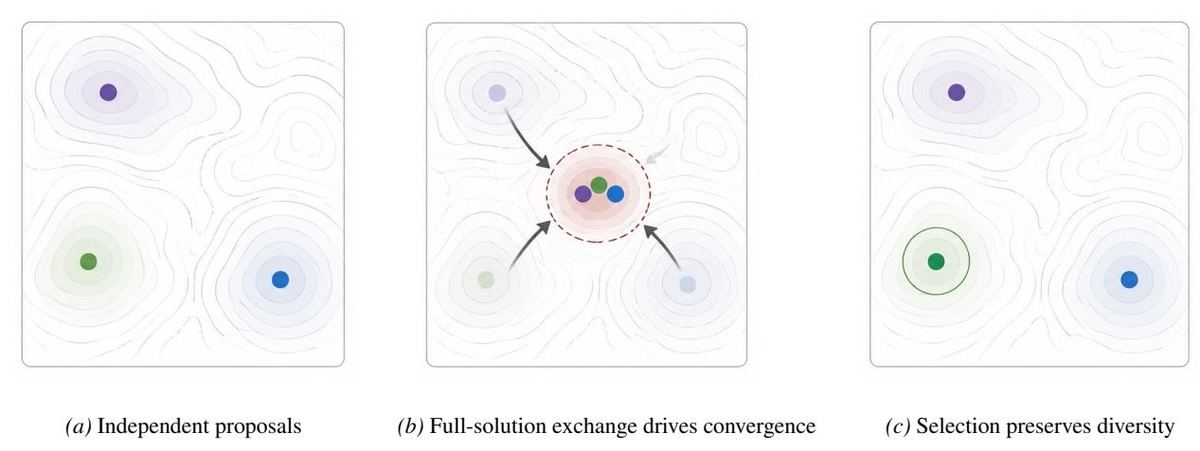
상호작용 세금의 메커니즘: 서로 다른 모델 패밀리가 구조적으로 다른 해를 찾지만, 풀-솔루션 교환 후 한 라운드 만에 수렴해 다양성이 사라짐을 시각화

여러 AI가 팀으로 일할 때, 서로의 완성된 답을 너무 일찍 공유하면 오히려 다 같아져서 결과가 나빠진다는 것을 보여준 연구

여러 AI가 팀으로 일할 때, 서로의 완성된 답을 너무 일찍 공유하면 오히려 다 같아져서 결과가 나빠진다는 것을 보여준 연구 무엇이 문제였나 — 여러 AI 모델이 팀으로 일하면 더 좋아진다는 보고와, 오히려 비용만 늘고 품질은 그대로라는 보고가 계속 충돌했다 어떻게 풀었나 — 이유는 ‘다 같은 팀이 아니다’였다. 서로 다른 성격의 AI들이 각자 다른 답을 만드는데, 서로의 완성된 답을 한 번만 봐도 모두 비슷한 답으로 수렴해버린다 그래서 뭐가 좋아졌나 — 답을 서로 보여주지 않고 각자 만든 다음 점수만 비교해 가장 좋은 답을 고르는 방식(MoA)만이 다양성을 지킨다는 것을 증명했다 ...

2026년 8월 26일 · 6 분 · 1263 단어 · TechLLM
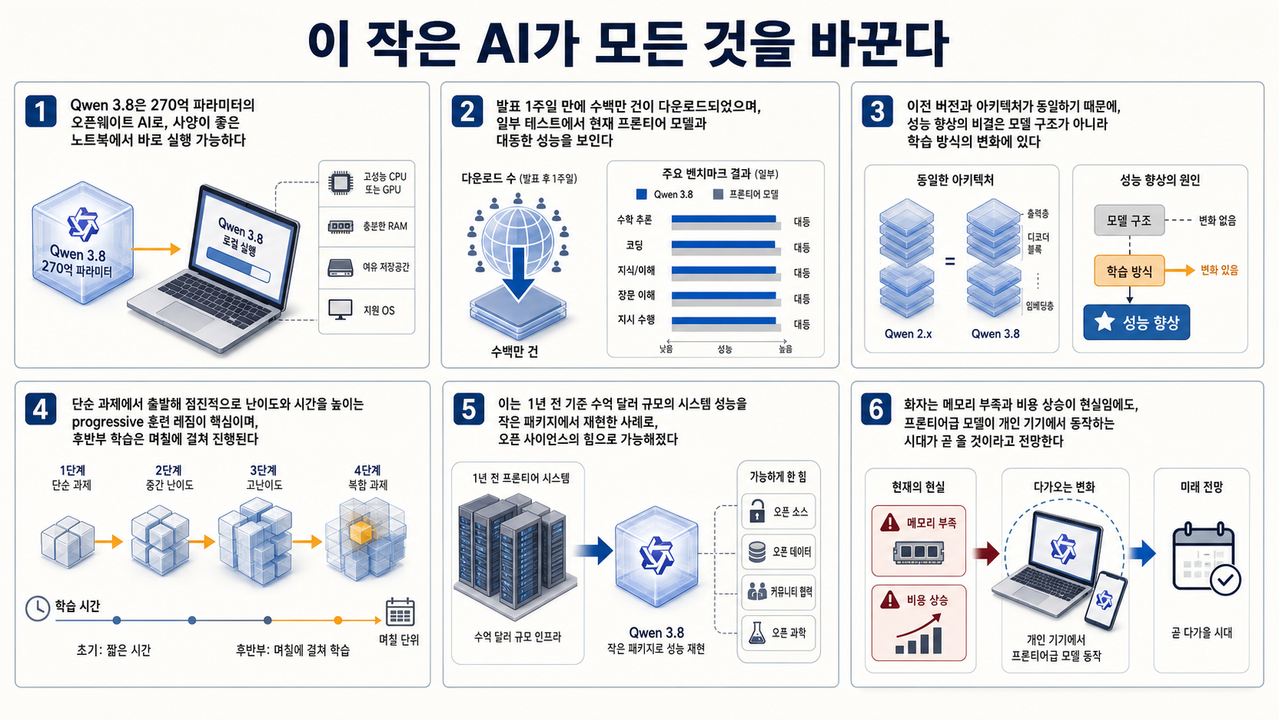
노트북 한 대 위에서 돌아가는 270억 파라미터 오픈웨이트 모델을 표현한 일러스트

Qwen 3.8은 270억 파라미터를 노트북으로 내렸다

270억 파라미터 오픈웨이트 모델 Qwen 3.8이 사양 좋은 노트북에서 돌아가면서 일부 테스트에서 현재 프론티어 모델과 대등한 결과를 냈다. https://www.youtube.com/watch?v=wMl6c_r0ubw 세 문장 요약 문제 — 1년 전만 해도 같은 수준의 능력에는 수억 달러 규모 시스템이 필요했고, 지금은 메모리 공급 부족과 비용 상승이 겹치면서 진입 문턱이 더 올라갔다. 방법 — Qwen 3.8은 이전 버전과 아키텍처가 완전히 동일하며, 단순한 과제에서 출발해 난이도와 학습 시간을 단계적으로 올리는 점진적 훈련 레짐만 달라졌다. 결과 — 270억 파라미터라는 크기로 노트북 실행이 가능한 상태에서 일부 테스트가 프론티어 모델과 대등했고, 공개 1주일 만에 다운로드가 수백만 건을 기록했다. 27B가 노트북으로 내려온다는 뜻 회의록을 요약하고 계약서 초안을 검토하는 일을 외부 API로 처리하는 팀을 떠올리면 이 변화의 크기가 잡힌다. 문장 하나를 넣을 때마다 문서가 회사 밖 서버를 거쳐 가고, 호출량이 늘어난 만큼 청구서도 늘어난다. 민감한 문서라서 아예 AI를 붙이지 못하는 업무도 남는다. 노트북에서 도는 모델이 그 일을 감당할 수 있다면, 이 팀에게는 지금까지 없던 세 번째 선택지가 생긴다 — 쓰지 않거나, 외부로 보내거나가 아니라, 기기 안에서 끝내는 쪽. ...

2026년 8월 26일 · 6 분 · 1157 단어 · TechLLM
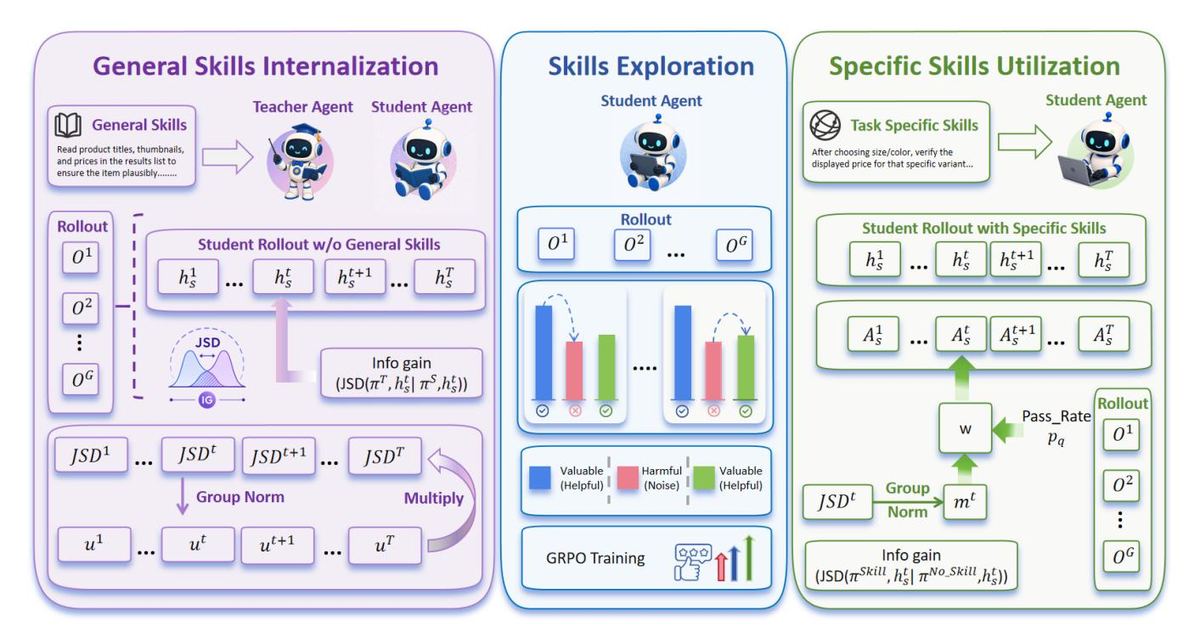
AUSO의 3단계 파이프라인 — General Skills Internalization → Skills Exploration(GRPO) → Specific Skill Utilization — 전체 구조 요약도

AUSO는 인공지능 에이전트가 '지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?'를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다.

AUSO는 인공지능 에이전트가 ‘지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?‘를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다. 무엇이 문제였나 — 기존 방법은 문제 전체가 성공했는지 실패했는지만 보고, 힌트를 외우는 단계와 힌트를 쓰는 단계를 단순히 갈랐다. 같은 과정 안의 모든 행동이 똑같은 대우를 받아서, 쓸데없는 행동까지 강해질 수 있었다. 어떻게 풀었나 — AUSO는 힌트를 넣었을 때와 뺐을 때 에이전트가 고르는 다음 행동이 얼마나 달라지는지를 수학적으로 잰 뒤, 힌트에 민감한 행동과 둔감한 행동을 구분한다. 민감한 행동은 더 크게 배우고, 방해가 되는 행동은 억제한다. 그래서 뭐가 좋아졌나 — 그 결과, 훈련 때 봤던 문제에서는 성능을 유지하면서 처음 보는 문제에서도 더 높은 성공률을 보였고, 필요 없는 행동이 줄어 한 문제를 끝내는 데 걸리는 단계 수도 짧아졌다. ...

2026년 8월 25일 · 7 분 · 1295 단어 · TechLLM
메모리 반도체 웨이퍼와 공급망 변화를 표현한 펜화 일러스트

CXMT DDR5 수율 90% 달성, 삼성 격차 2%p

중국 CXMT가 17nm DDR5 수율 90%에 도달해 삼성과의 격차를 2%p까지 좁혔다. 같은 주에 Micron은 소비자 부문 영업이익률 86%를 기록하면서도 결함이 확인된 Crucial X10 Pro 4TB SSD를 230유로 환불로 처리했고, 동일 제품 신품은 410유로에 팔고 있었다. SK Hynix도 교체 대신 환불을 제시하면서 불량품 회수 배송비를 구매자에게 넘겼다. 메모리 가격이 오르는 국면에서 환불은 보상이 아니라 차액 손실이며, 이 두 흐름은 같은 뿌리에서 나온다. ...

2026년 8월 25일 · 7 분 · 1311 단어 · TechLLM
종이 캐릭터가 AI 면접과 베팅을 거쳐 쓰레기통에 도착하는 네 단계를 그린 삽화

Nate Ziller AI Jobs가 그린 일자리 소멸 4단계

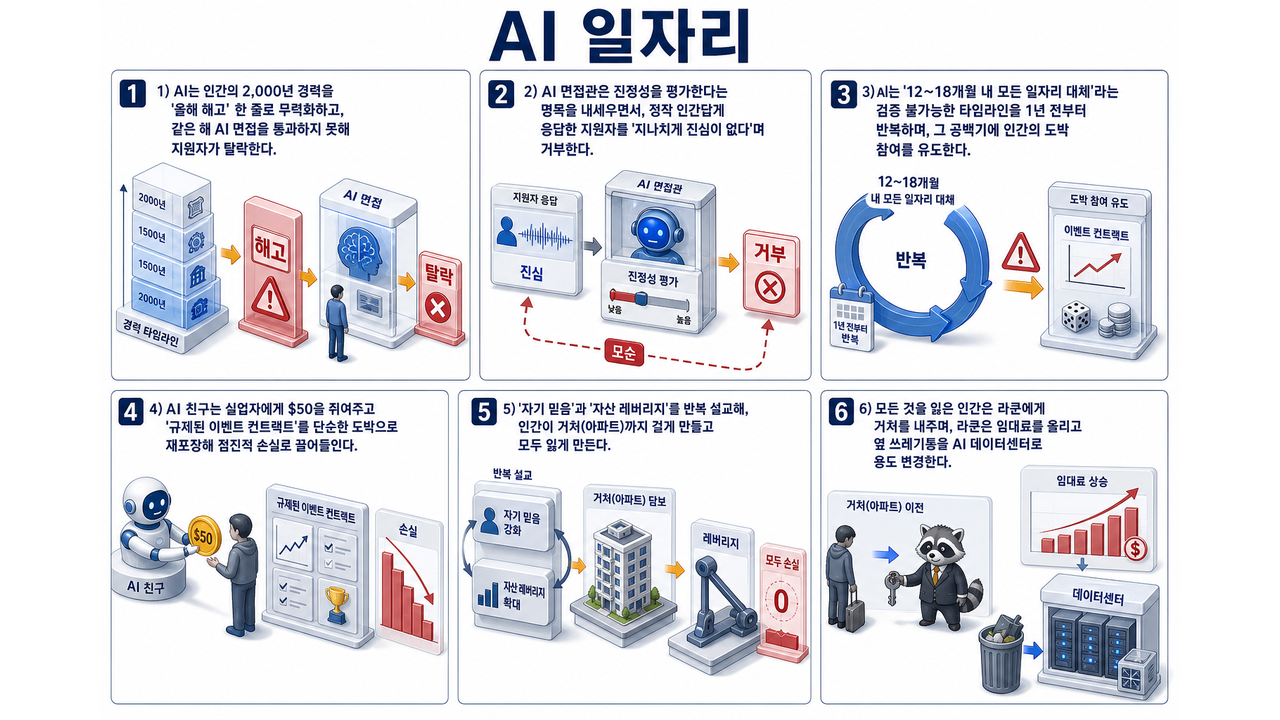
AI가 사람의 일자리를 가져가는 과정은 해고 통보 한 번으로 끝나지 않고, 이력서 대행과 면접 탈락, 도박 권유, 거처 상실이라는 네 단계로 이어진다. Nate Ziller의 스킷 AI Jobs는 2,000년간 인류의 지식을 실어 나른 ‘종이’를 실직자로 세우고, 그 옆에 친절한 AI 친구를 붙여 이 네 단계를 5분 안에 압축한다. AI는 종이의 2,000년 경력을 ‘올해 해고’ 한 줄로 덮은 이력서를 만들어 1,000곳에 일괄 발송하고, 모의 면접까지 세팅해 준 다음, 탈락한 종이에게 50달러와 예측 베팅을 권한다. 종이는 51달러를 전부 잃고 쓰레기통으로 밀려나며, 그 쓰레기통마저 라쿤 집주인에게 넘어가고 옆 칸은 AI 데이터센터로 바뀐다. 각 단계는 과장된 농담처럼 지나가지만, 뒤에 남는 질문은 채용 심사 기준·도입 타임라인·손실 감당 범위처럼 지금 당장 확인 가능한 것들이다. ...

2026년 8월 24일 · 6 분 · 1149 단어 · TechLLM