GPT-5.5의 에이전트형 업무 수행과 멀티툴 워크플로우를 표현한 대표 이미지

GPT-5.5는 왜 그냥 더 좋은 모델이 아니라, 일을 끝내는 방식 자체를 바꾸는 모델처럼 보일까

GPT-5.5는 왜 그냥 더 좋은 모델이 아니라, 일을 끝내는 방식 자체를 바꾸는 모델처럼 보일까 메타 설명: GPT-5.5는 단순히 답을 더 잘 만드는 모델이 아니다. 복잡하고 애매한 업무를 계획하고, 툴을 넘나들고, 검증하며 끝까지 밀어붙이는 업무 수행형 AI에 가까워졌다. GPT-5.4 대비 같은 지연 시간에서 더 높은 성능, 더 적은 토큰, 더 강한 에이전트형 작업 능력이 왜 중요한지 실무 관점에서 정리한다. ...
2026년 4월 24일 · 4 분 · 722 단어 · TechLLM
OpenRouter Workspaces를 통한 AI 환경 분리와 운영 통제를 표현한 대표 이미지

OpenRouter Workspaces, 에이전트 시대에는 계정 하나로는 운영이 안 된다

출처: TechLLM 문서유형: 기능 해설 #OpenRouter #Workspaces #APIKeys #Guardrails #Observability #에이전트운영 #개발환경분리 #AI인프라 핵심 요약 OpenRouter가 Workspaces를 내놓은 건 단순한 UI 개편이 아니다. 프로젝트, 팀, 에이전트별로 API 키, 라우팅 기본값, 가드레일, 관측성을 분리할 수 있게 되면서, AI 운영 환경을 계정 단위가 아니라 워크스페이스 단위로 설계하는 흐름이 본격화되고 있다. 중요한 건 편의성보다 운영 통제력이다. ...

2026년 4월 24일 · 3 분 · 596 단어 · TechLLM
Qwen3.6-27B의 agentic coding 성능과 실전 코딩 워크플로우를 표현한 대표 이미지

Qwen3.6-27B가 의미 있는 이유, 거대 모델 경쟁이 아니라 실전 코딩 에이전트 운영 관점에서 보기

출처: TechLLM 문서유형: 모델 분석 #Qwen36 #Qwen27B #AgenticCoding #SWEBench #TerminalBench #SkillsBench #OpenClaw #ClaudeCode 핵심 요약 Qwen3.6-27B는 27B dense 모델임에도 agentic coding에서 상당히 공격적인 성능을 보여준다. SWE-bench Verified 77.2, SWE-bench Pro 53.5, Terminal-Bench 2.0 59.3, SkillsBench 48.2, GPQA Diamond 87.8은 단순한 가성비 수준을 넘어선다. 중요한 건 숫자 그 자체보다, 이 모델이 큰 모델 일변도 흐름에 균열을 내며 실전 운영 효율의 새로운 기준을 보여준다는 점이다. ...

2026년 4월 24일 · 3 분 · 565 단어 · TechLLM
LLM Stats AI News의 AI 모델 뉴스와 벤치마크 관제판을 표현한 대표 이미지

LLM Stats AI News는 왜 단순 뉴스 모음이 아니라 AI 실무자의 관제판인가

출처: TechLLM 문서유형: 서비스 해설 #LLMStats #AI뉴스 #LLM벤치마크 #GPQA #MMLUPro #SWEBench #모델비교 #AI리서치 핵심 요약 LLM Stats AI News는 최신 모델 릴리스, 연구, 벤치마크, 리더보드를 한곳에 모아주는 허브다. hourly updates, 500개 이상 모델, 50개 이상 벤치마크, arenas, research feed까지 묶여 있어 AI 실무자의 정보 소비 비용을 줄이는 관제판 역할을 한다. 중요한 건 뉴스가 많다는 사실보다, 무엇을 먼저 봐야 하는지 판단하는 시간을 줄여준다는 점이다. ...

2026년 4월 24일 · 4 분 · 651 단어 · TechLLM
OpenAI Privacy Filter를 활용한 PII 탐지와 마스킹 파이프라인을 표현한 대표 이미지

OpenAI Privacy Filter, RAG와 로그 분석 전에 왜 지금 봐야 할까

출처: TechLLM 문서유형: 모델 해설 #OpenAI #PrivacyFilter #PII #개인정보보호 #RAG #LLMOps #온프레미스 #비식별화 핵심 요약 OpenAI Privacy Filter는 PII 탐지와 마스킹을 위한 양방향 토큰 분류 모델이다. Apache 2.0 라이선스, 128K 컨텍스트, 온프레미스 배포, 파인튜닝 가능성까지 갖춰 실무형 전처리 레이어로 꽤 매력적이다. 다만 이 모델은 완전한 익명화 엔진이 아니라, privacy-by-design을 돕는 보조 도구에 가깝다. ...

2026년 4월 24일 · 4 분 · 716 단어 · TechLLM
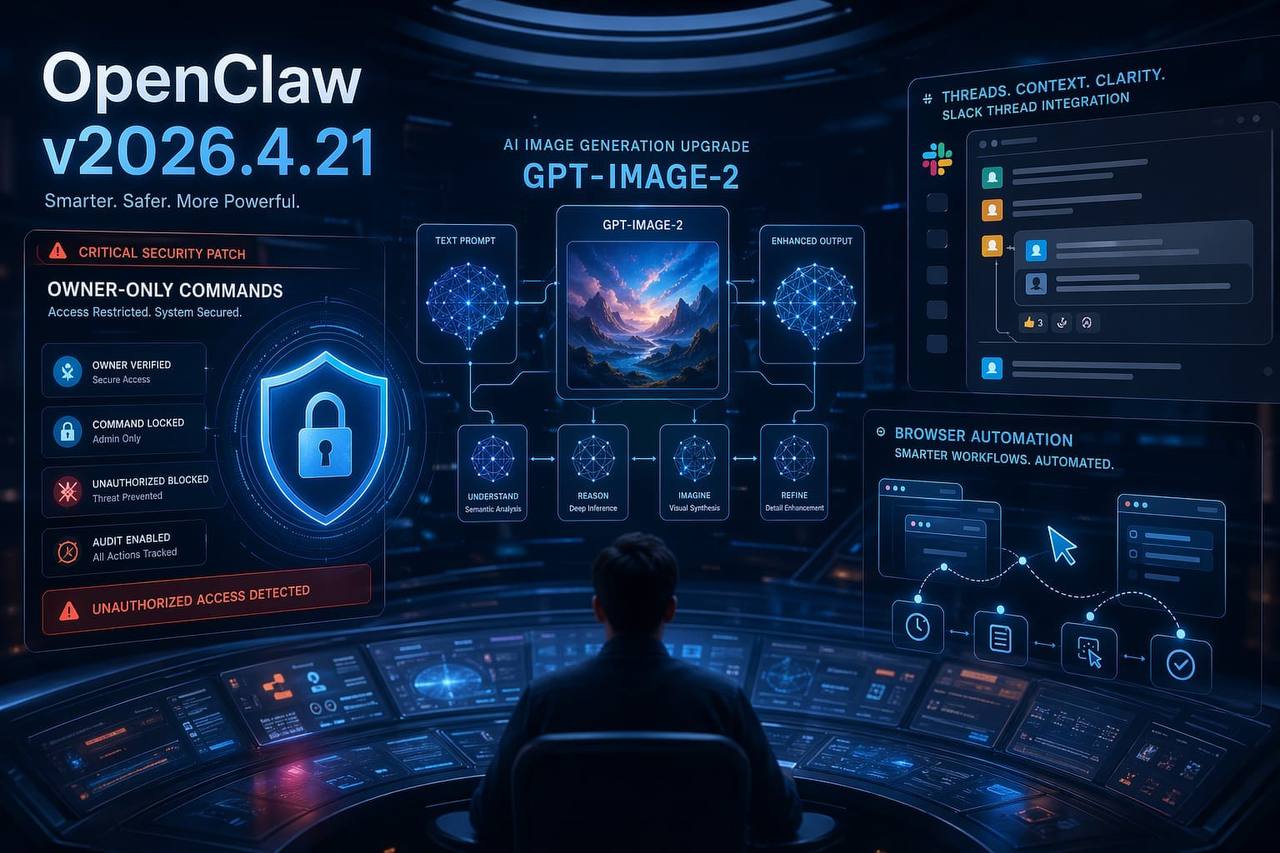
openclaw v2026.4.21 보안 패치와 gpt-image-2 전환을 다루는 TechLLM 블로그 대표 이미지

openclaw v2026.4.21, 바로 올려야 하는 이유: 오너 명령 보안 패치와 gpt-image-2 기본 전환

출처: TechLLM 문서유형: 릴리스 해설 #openclaw #릴리스노트 #보안패치 #gptimage2 #AI봇 #Slack #브라우저자동화 #이미지생성 핵심 요약 openclaw v2026.4.21은 enforceOwnerForCommands 관련 보안 허점을 막고, 이미지 생성 기본값을 gpt-image-2로 전환한 업데이트다. 여기에 Slack 스레드 유지, 브라우저 접근성 ref 처리 개선, doctor 의존성 복구, npm 경고 노이즈 축소까지 포함돼 있어 실무 운영자 입장에서는 꽤 챙겨볼 만한 릴리스다. ...

2026년 4월 23일 · 3 분 · 558 단어 · TechLLM
AI Agent 모델 선택과 워크플로우를 다루는 TechLLM 블로그 대표 이미지

AI Agent 활용을 위한 모델 선택, 정말 그렇게 중요할까

출처: TechLLM 문서유형: 블로그 포스트 #AI #AIAgent #모델선택 #LLM #에이전트 #프롬프트엔지니어링 #워크플로우 #생산성 핵심 요약 AI Agent 성능은 모델 선택에 영향을 받지만, 실무에서는 모델 하나보다 과업 유형, 툴 사용, 프롬프트 구조, 검증 루프가 더 큰 차이를 만드는 경우가 많다. 비싼 모델이 항상 정답은 아니며, 작업에 맞는 모델과 운영 설계를 함께 맞추는 것이 훨씬 중요하다. ...

2026년 4월 23일 · 5 분 · 922 단어 · TechLLM
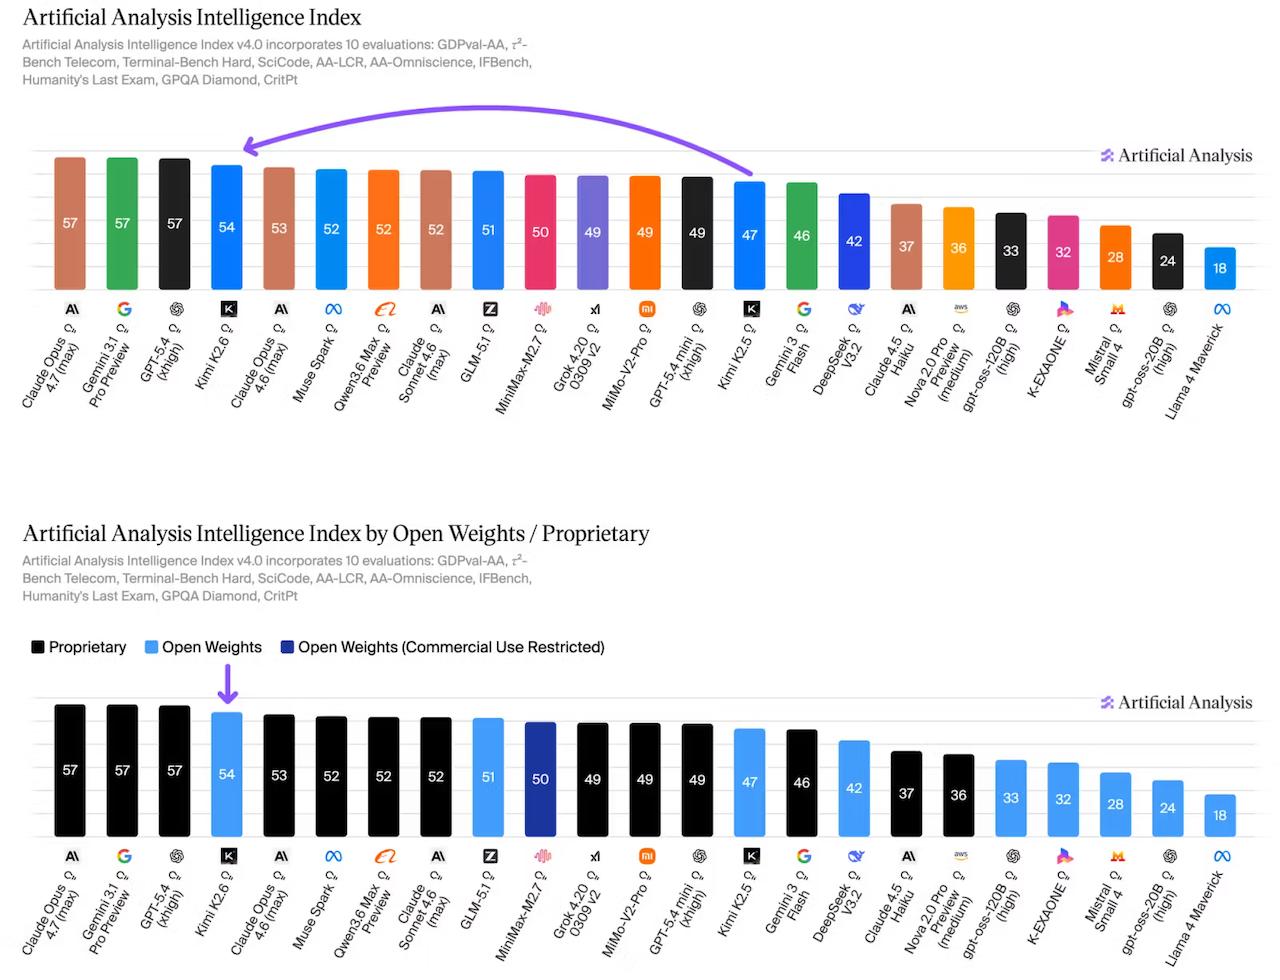
Kimi K2.6 Artificial Analysis chart

Kimi K2.6, 오픈 웨이트 진영의 새 선두주자일까

Kimi K2.6, 오픈 웨이트 진영의 새 선두주자일까 원문: https://artificialanalysis.ai/articles/kimi-k2-6-the-new-leading-open-weights-model 문서 유형: Artificial Analysis 기사 번역 및 해설 #KimiK2.6 #OpenWeights #MoonshotAI #LLM #AI에이전트 먼저 핵심만 보면 Kimi K2.6은 오픈 웨이트 계열에서 가장 강한 후보 중 하나로 평가된다 단순 점수 경쟁이 아니라, 실제 사용 가능한 성능과 효율의 균형이 핵심이다 폐쇄형 최상위 모델을 완전히 대체한다기보다, 오픈 웨이트 진영의 상한선을 끌어올린 모델에 가깝다 오픈 웨이트 모델 쪽은 늘 비슷한 기대를 받아왔다. “이제 진짜 닫힌 모델들과 붙어볼 수 있나?“라는 질문이다. ...

2026년 4월 22일 · 4 분 · 764 단어 · TechLLM

TechLLM 블로그를 시작하며

TechLLM 블로그를 시작하며 원문: 자체 작성 문서 유형: 블로그 소개 #TechLLM #블로그 #AIAgent 먼저 핵심만 보면 이 블로그는 LLM과 AI 에이전트를 실전 관점에서 다룹니다 단순 뉴스 요약보다 적용과 운영에 더 집중합니다 OpenClaw, Claude, 자동화, 제품화가 핵심 주제입니다 TechLLM은 화려한 발표보다, 실제로 써보고 부딪히며 정리한 내용을 쌓아가는 공간입니다.

2026년 4월 22일 · 1 분 · 47 단어 · TechLLM