Claude Mythos 취약점 발견

Claude Mythos, 한 달 만에 취약점 1만 개 발견 — Anthropic, 공개 출시에 한 발 더

개요 Anthropic의 보안 이니셔티브 Project Glasswing이 첫 한 달 결과를 발표했다. Claude Mythos Preview가 50여 개 파트너 조직과 함께 인터넷의 핵심 소프트웨어에서 고위험·치명적 취약점 1만 건 이상을 발굴했다. Cloudflare는 자사 시스템에서 2,000개 버그를, Mozilla는 Firefox 150에서 271개 취약점을 찾아냈다. 성과는 인상적이지만, 발견 속도를 패치 속도가 따라가지 못하는 새로운 문제가 수면 위로 떠오르고 있다. ...
2026년 5월 25일 · 4 분 · 722 단어 · TechLLM
AI 보안 실시간 대응

AI 보안은 실시간으로 풀어야 한다 — 구글도 마찬가지

개요 AI가 기업 시스템 깊숙이 침투하면서 보안의 판이 완전히 바뀌고 있다. 구글 클라우드 COO 프란시스 드 수자(Francis de Souza)는 최근 인터뷰에서 “AI 전략에는 반드시 데이터 전략과 보안 전략이 함께 가야 한다"고 강조했다. 그런데 아이러니하게도, 이 조언을 꺼낸 구글 자신이 API 키 취약점 문제로 개발자들에게 수천만 원짜리 청구서를 날리는 상황이 벌어졌다. 조언과 현실의 간극 — 지금 AI 보안의 풍경이다. ...

2026년 5월 25일 · 4 분 · 714 단어 · TechLLM
중앙 AI 코어가 여러 API 게이트웨이와 개발자 SDK 모듈로 연결되는 추상 기술 일러스트

Anthropic의 Stainless 인수, 에이전트 시대의 진짜 병목을 겨냥하다

AI 경쟁의 무게중심이 조금씩 바뀌고 있습니다. 이제 중요한 질문은 “모델이 얼마나 똑똑한가"에서 끝나지 않습니다. 그 모델이 실제 업무 시스템, 데이터, API, 도구에 얼마나 자연스럽게 연결되는지가 점점 더 중요해지고 있습니다. ...

2026년 5월 24일 · 3 분 · 599 단어 · TechLLM
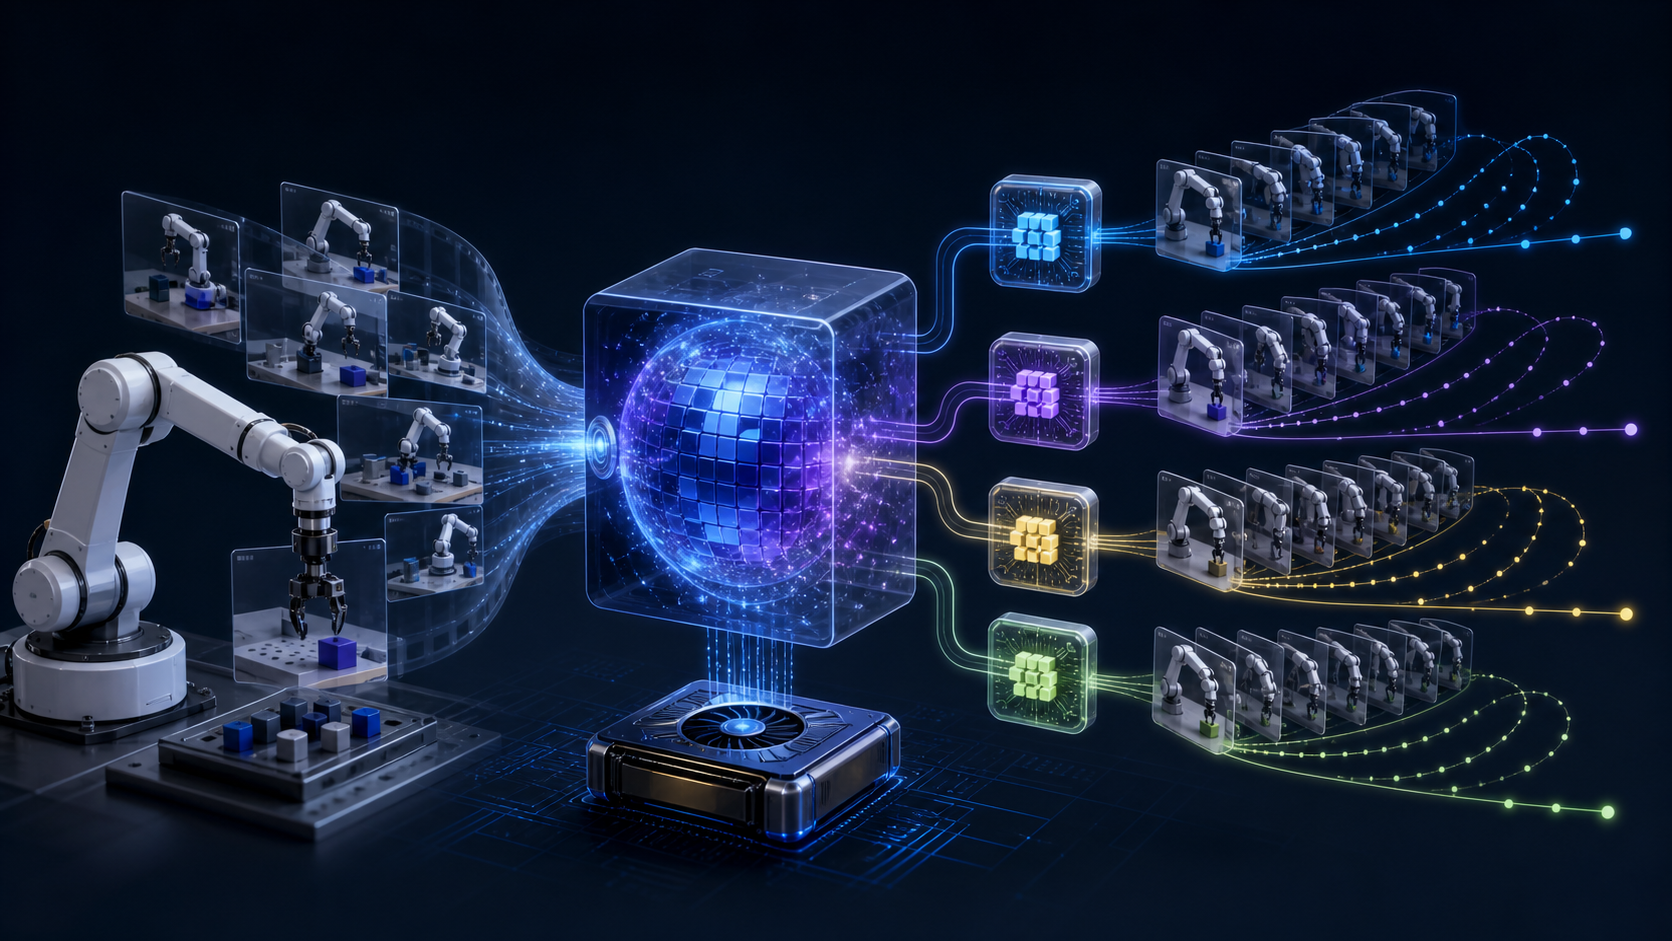
로봇 조작 영상 데이터가 월드 모델과 LoRA 어댑터를 거쳐 합성 궤적으로 확장되는 기술 일러스트

Cosmos Predict 2.5, 로봇 영상을 LoRA로 빠르게 길들이는 법

NVIDIA가 Hugging Face에 공개한 글은 Cosmos Predict 2.5를 로봇 조작 영상에 맞게 파인튜닝하는 방법을 다룬다. 핵심은 거대한 비디오 월드 모델 전체를 다시 학습하는 것이 아니라, LoRA와 DoRA 어댑터만 학습해 적은 데이터로 로봇 합성 영상을 만드는 것이다. ...

2026년 5월 24일 · 3 분 · 591 단어 · TechLLM
Fast-growing areas in neuroscience

신경과학에서 가장 빠르게 커지는 분야들: AI, 시스템 신경과학, 신경면역학

개요 신경과학은 지금 연구 주제만 넓어지는 것이 아니라, 연구하는 방식 자체가 바뀌는 중이다. The Transmitter가 2025년 신경과학 현황 보고서에서 연구자들에게 물은 결과, 가장 빠르게 성장하는 영역으로 계산 신경과학, 인공지능, 시스템 신경과학, 자연 행동 연구, 신경면역학, 신경영상 등이 반복해서 언급됐다. ...

2026년 5월 24일 · 3 분 · 525 단어 · TechLLM
Small Language Models and on-device AI

작은 언어모델 SLM이 중요한 이유: 온디바이스 AI 시대의 현실적인 선택지

개요 거대 언어모델이 AI의 가능성을 보여줬다면, **Small Language Model(SLM)**은 그 가능성을 실제 제품과 기기 안으로 가져오는 역할을 한다. 모든 작업에 수천억 파라미터 모델이 필요한 것은 아니기 때문이다. ...

2026년 5월 24일 · 3 분 · 568 단어 · TechLLM
Gemini Omni Flash — 멀티모달 영상 생성 AI

Google I/O 2026: Gemini Omni Flash 출시 — 텍스트·이미지·오디오로 영상을 만드는 새 시대

🔑 개요 2026년 5월 19일, Google은 I/O 개발자 컨퍼런스에서 Gemini Omni Flash를 전격 출시했다. 단순한 영상 생성 모델 업데이트가 아니다. 텍스트·이미지·오디오·영상을 한꺼번에 입력으로 받아 하나의 일관된 영상으로 만들어내는, Gemini 지식 기반 위에 세워진 완전히 새로운 멀티모달 아키텍처다. ...

2026년 5월 24일 · 3 분 · 467 단어 · TechLLM
LiteRT-LM 공식 블로그 메인 이미지

서버 없이 76토큰/초? 구글 LiteRT-LM이 온디바이스 AI의 병목을 뚫었다

구글이 LiteRT-LM을 전면에 내세웠다. 핵심은 단순하다. LLM을 서버로 보내지 않고, Android·iOS·브라우저 안에서 빠르게 돌리겠다는 것이다. 원문이 제시한 숫자는 꽤 공격적이다. Gemma 4 E2B 기준 Android GPU 52 tokens/sec, iOS Metal 56 tokens/sec, WebGPU에서는 최대 76 tokens/sec까지 언급한다. ...

2026년 5월 24일 · 4 분 · 749 단어 · TechLLM
Qwen3.7-Max 공식 메인 배너 이미지

Qwen3.7-Max, 에이전트 시대를 겨냥한 Qwen의 새 플래그십

Qwen 팀이 Qwen3.7-Max를 공개했다. 이번 글에서 Qwen은 이 모델을 단순한 채팅 모델이 아니라, 코딩·업무 자동화·장기 자율 실행을 수행하는 에이전트 기반 모델로 소개한다. 핵심은 벤치마크 점수 하나가 아니라, 여러 하네스와 도구 환경에서 오래 버티며 문제를 풀 수 있는가에 있다. ...

2026년 5월 23일 · 4 분 · 649 단어 · TechLLM