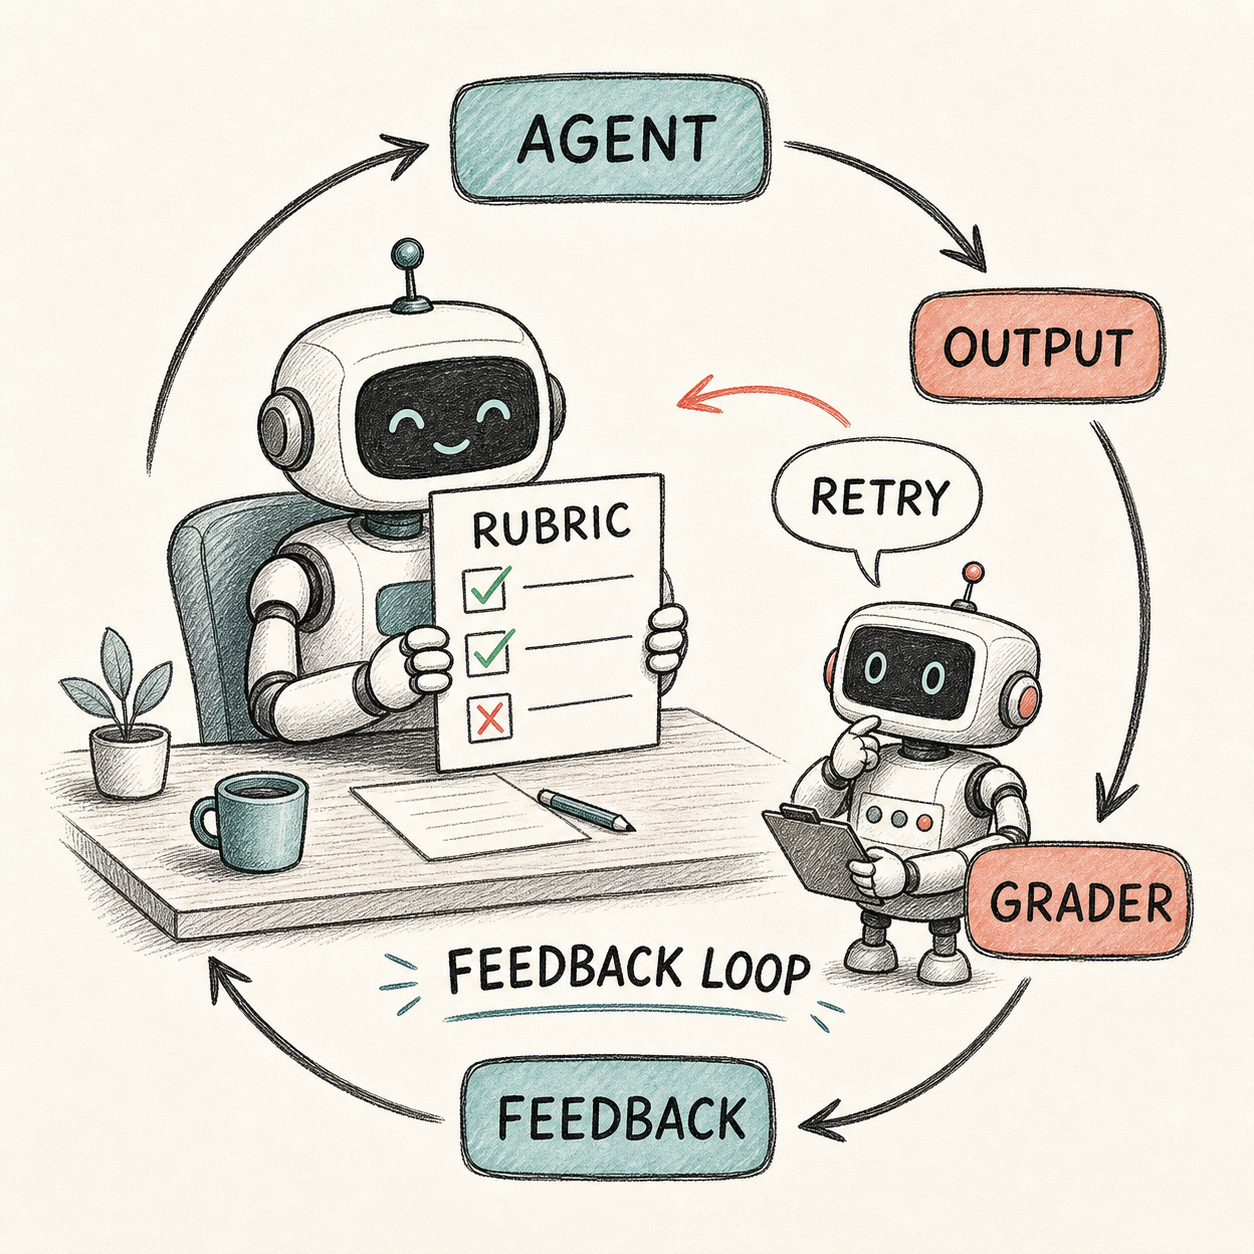
RubricMiddleware 자기 채점 루프를 표현한 스케치 인포그래픽

LangChain RubricMiddleware: 에이전트가 스스로 채점하고 다시 시도하게 만드는 법

LangChain이 6월 2일에 Deep Agents 쪽에 RubricMiddleware를 추가했습니다. 한 줄로 요약하면, “이 에이전트의 결과가 합격인지 아닌지"를 채점하는 서브에이전트를 끼워 넣고, 기준 미달이면 피드백을 다시 주입해 재실행시키는 루프입니다. Claude Code나 Codex의 /goal 패턴과 비슷하지만, 채점 단계를 별도 서브에이전트로 분리하고 채점자가 도구까지 호출할 수 있다는 점이 다릅니다. ...
2026년 6월 25일 · 4 분 · 839 단어 · TechLLM
2026년 생성형 AI 코딩 툴 지도

2026년 생성형 AI 코딩 툴 16선 — 자동완성에서 에이전트 플랫폼까지 한눈에

개요 생성형 AI가 들어온 뒤 소프트웨어를 만드는 방식 자체가 많이 바뀌었습니다. 처음에는 한 줄짜리 자동완성이었는데, 지금은 프롬프트 하나로 풀스택 앱을 통째로 찍어내는 도구까지 나옵니다. 그 사이에는 코드 검색, 디자인-투-코드, 코드 품질 점검, 문서 자동화처럼 한 군데만 깊게 파는 도구들도 자리를 잡았습니다. ...

2026년 6월 24일 · 5 분 · 1002 단어 · TechLLM
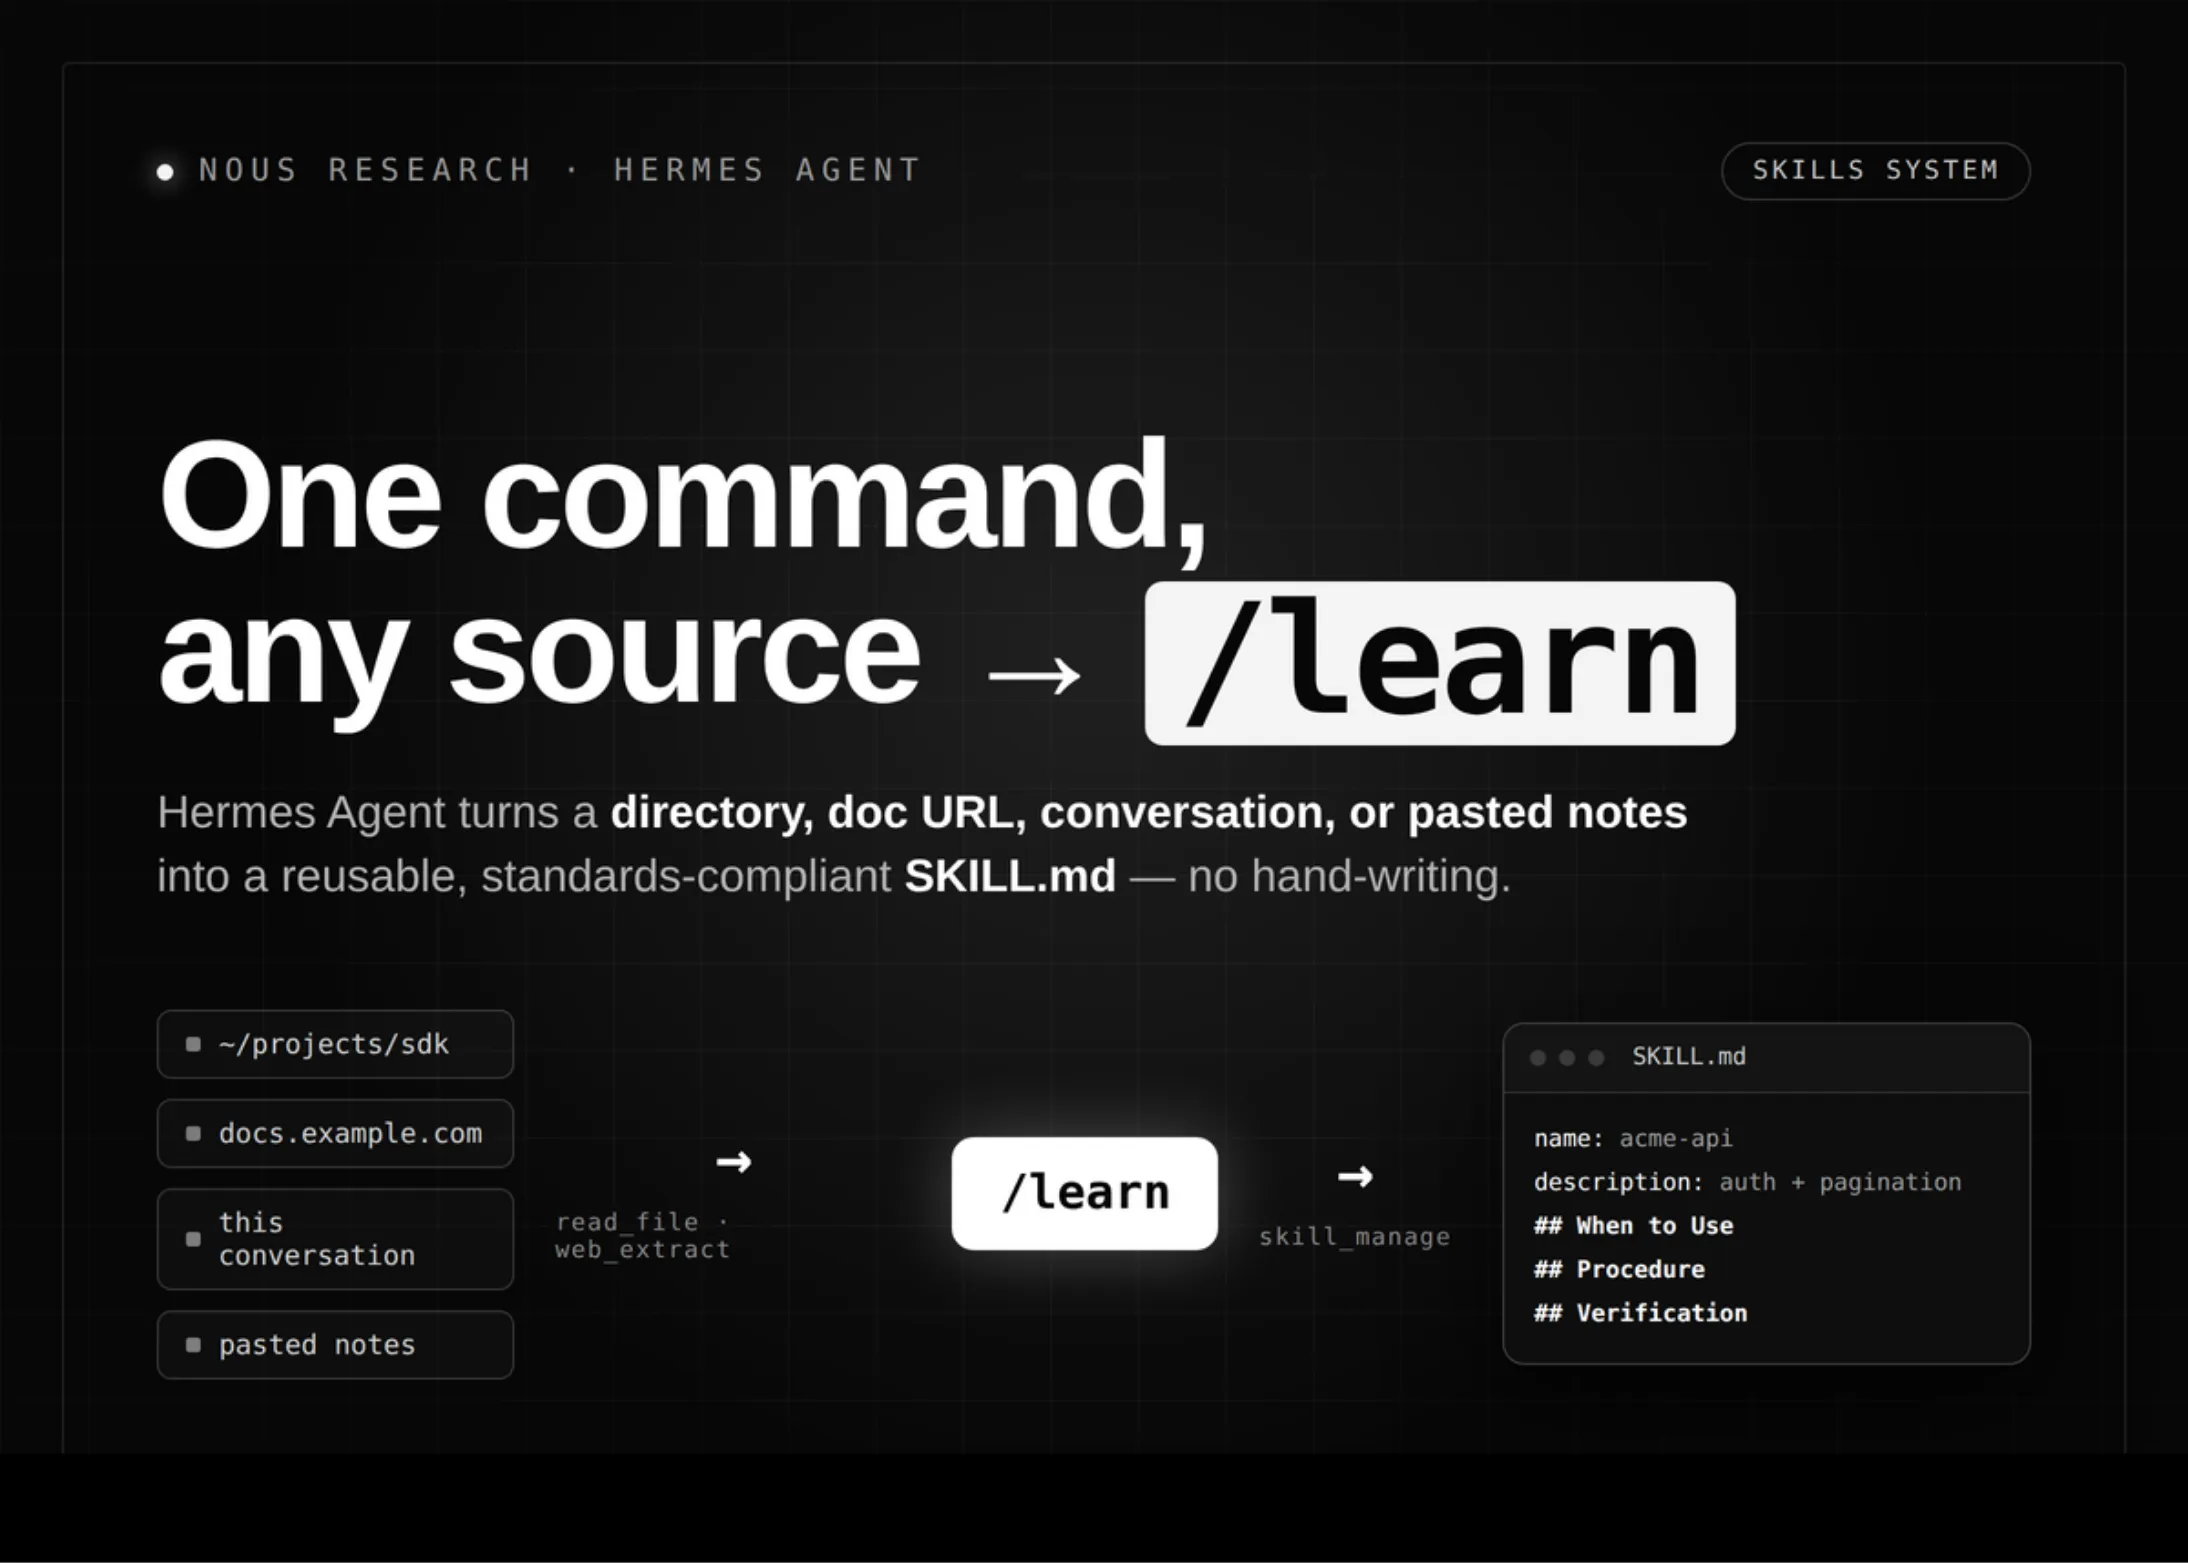
Hermes Agent의 /learn 명령으로 스킬을 자동 생성하는 흐름

누스 리서치 Hermes Agent에 /learn 명령 추가 — SKILL.md를 사람이 안 짜도 된다

개요 오픈소스 진영에서 자기개선 에이전트를 끌고 가던 누스 리서치(Nous Research)가 자사 Hermes Agent에 흥미로운 기능을 하나 더 얹었습니다. /learn이라는 슬래시 명령입니다. 그동안 에이전트에게 새 능력을 가르치려면 사람이 직접 SKILL.md 파일을 손으로 써야 했습니다. 폴더 만들고, 헤더 맞추고, 절차를 단계별로 정리하고. 이게 귀찮아서 만들다 만 스킬 디렉터리가 누구한테나 한두 개씩은 있을 겁니다. /learn은 그 작업 자체를 에이전트에게 떠넘기는 명령입니다. 원본 자료만 가리키면, 표준에 맞는 스킬 파일을 알아서 써 줍니다. ...

2026년 6월 24일 · 4 분 · 704 단어 · TechLLM
프런티어 AI 모델 접근권이 국가 안보와 산업 인프라로 변모하는 지정학적 지도

프런티어 모델 접근권은 제품 기능이 아니라 지정학적 인프라가 된다

개요 2026년 6월, 사흘 사이에 세 가지 사건이 겹쳤습니다. Anthropic이 자사의 Fable 5와 Mythos 5를 내렸고, NSA는 작전에 쓰던 Mythos를 잃었으며, OpenAI는 GPT-5.5-Cyber를 30곳의 보안 벤더에게 푸는 Daybreak 사이버 파트너 프로그램을 정식 출범시켰습니다. 이 셋을 따로 보면 평범한 기업 뉴스지만, 함께 놓고 보면 같은 신호가 잡힙니다. 프런티어 모델 접근권이 더 이상 클릭 한 번이면 풀리는 API 사용권이 아니라는 것입니다. 이제는 국가가 끄고 켜며, 정부 작전이 기대고, 벤더 생태계가 줄을 서서 받는 산업 인프라가 됐습니다. ...

2026년 6월 24일 · 6 분 · 1235 단어 · TechLLM
에이전트 검증 루프 스택을 표현한 일러스트

AI 에이전트 경쟁축이 바뀐다: '모델 성능'에서 '검증 루프 설계'로

개요 요즘 AI 에이전트 발표를 따라가다 보면 한 가지가 눈에 들어옵니다. 어느 회사도 더 이상 “우리 모델이 코드를 더 잘 짭니다"만으로는 발표를 끝내지 않는다는 점입니다. 그 다음에 반드시 따라오는 문장이 있습니다. 그리고 그 결과가 맞는지 직접 확인합니다. 6월에 쏟아진 발표들 — xAI Grok Build의 /goal, 시스코의 FAPO, 랭체인의 휴먼 인 더 루프 패턴, 그리고 그 사이에서 조용히 자리를 굳히는 OpenAI Codex CLI — 가 모두 같은 방향을 가리키고 있습니다. 에이전트 경쟁의 무게중심이 모델 성능에서 검증 루프 설계로 이동하는 중입니다. ...

2026년 6월 24일 · 6 분 · 1138 단어 · TechLLM
비행 중인 항공기 — Omio가 OpenAI Codex와 ChatGPT를 엔지니어링과 예약 인터페이스 전반에 통합하는 모습을 상징

Omio가 OpenAI Codex로 여행 상품 개발을 4배 빠르게 — '대화형 커머스'의 실제 사례

OpenAI 모델을 “그냥 갖다 붙이는” 회사는 많습니다. 그런데 유럽의 멀티모달 여행 예약 플랫폼 Omio는 그 반대를 택했습니다. CTO Tomas Vocetka는 “기존 업무 프로세스에 AI를 얹는 식의 피상적인 적용은 거부한다"고 못 박았습니다. 모든 부서가 처음부터 일하는 방식을 다시 설계해, AI 네이티브 기업으로 굴러가도록 만들겠다는 겁니다. ...

2026년 6월 24일 · 5 분 · 952 단어 · TechLLM
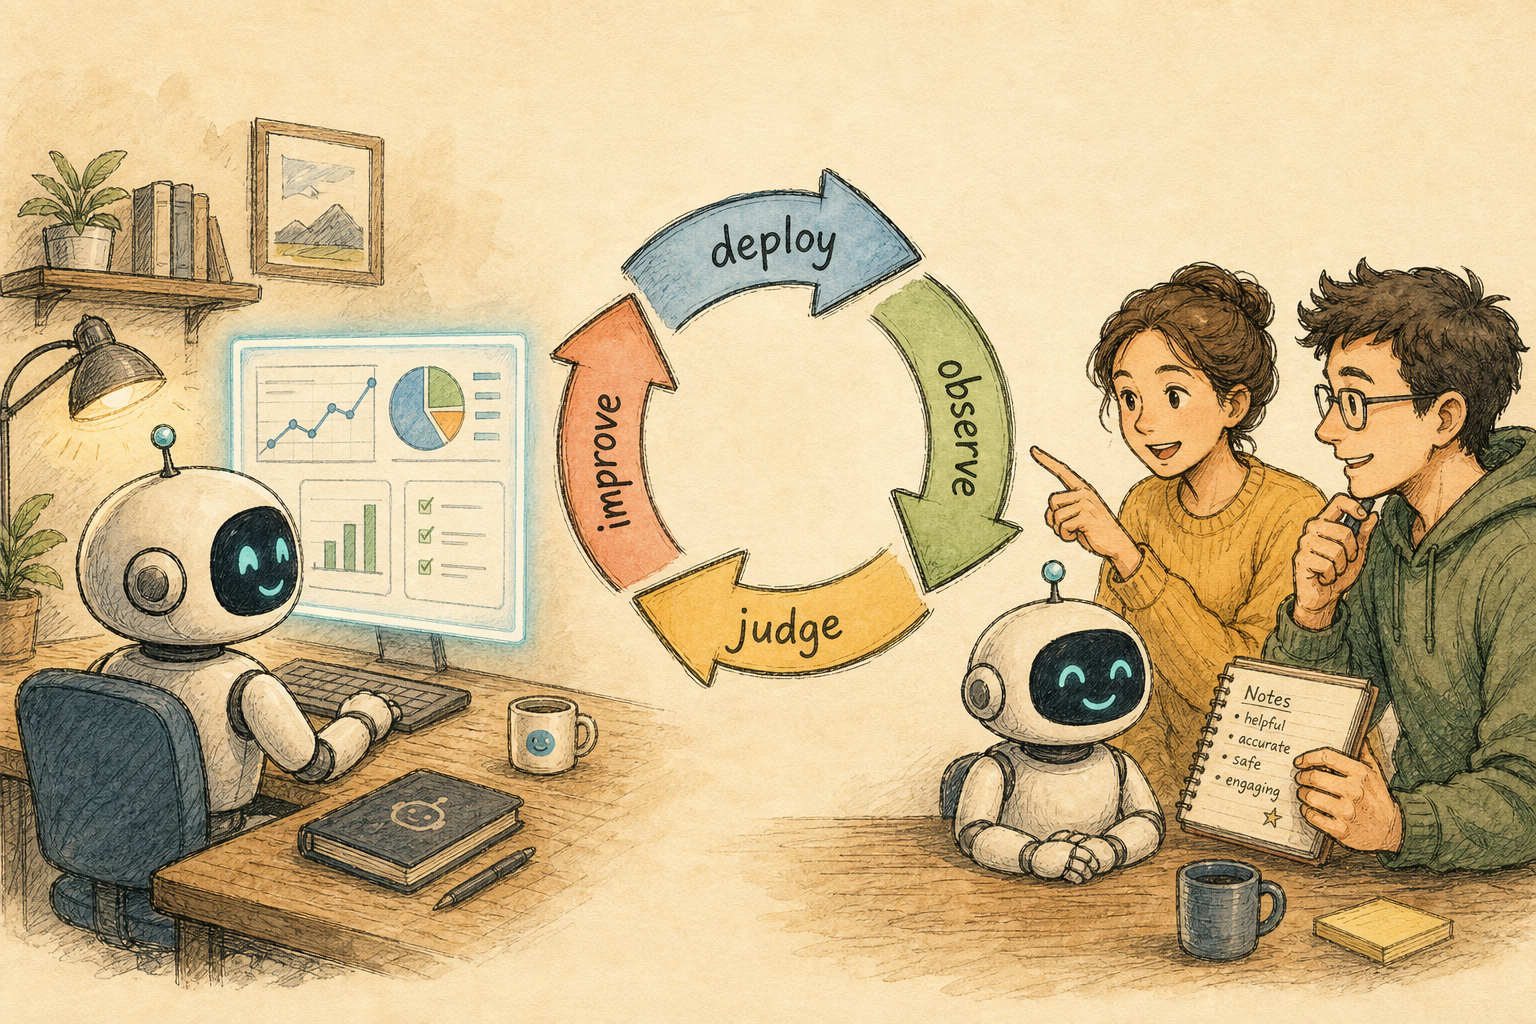
에이전트 개선 루프와 사람의 판단

에이전트 개선 루프에 사람의 판단을 어디에 넣을 것인가 — LangChain의 관점

에이전트가 진짜 쓸 만해지는 순간은, 우리 팀이 오랫동안 쌓아 온 판단이 그 안에 녹아 들어갈 때입니다. 문서로 정리된 매뉴얼은 그대로 떠먹이면 됩니다. 진짜 어려운 건 시니어들의 머릿속에만 있는, 말로 잘 안 풀어 본 그 직관입니다. ...

2026년 6월 24일 · 4 분 · 763 단어 · TechLLM
여행 플랫폼 엔지니어링에 OpenAI Codex가 결합된 모습

Omio가 OpenAI Codex로 여행 상품 개발을 5배 빠르게 만든 방법 — '한 분기 짜리 프로젝트가 한 달'로

개요 47개국, 3,000개가 넘는 교통수단 제공자를 하나로 묶는 멀티모달 여행 플랫폼 Omio가 자사 엔지니어링 전 과정에 OpenAI Codex를 박아 넣었습니다. 결과는 단순한 생산성 향상이 아니라 상품을 만들 때 드는 공수 자체가 약 5분의 1로 줄어든 구조 변화입니다. 여러 명의 개발자가 한 분기를 들이던 작업이 이제는 엔지니어 한 명이 한 달이면 끝납니다. ...

2026년 6월 24일 · 4 분 · 820 단어 · TechLLM
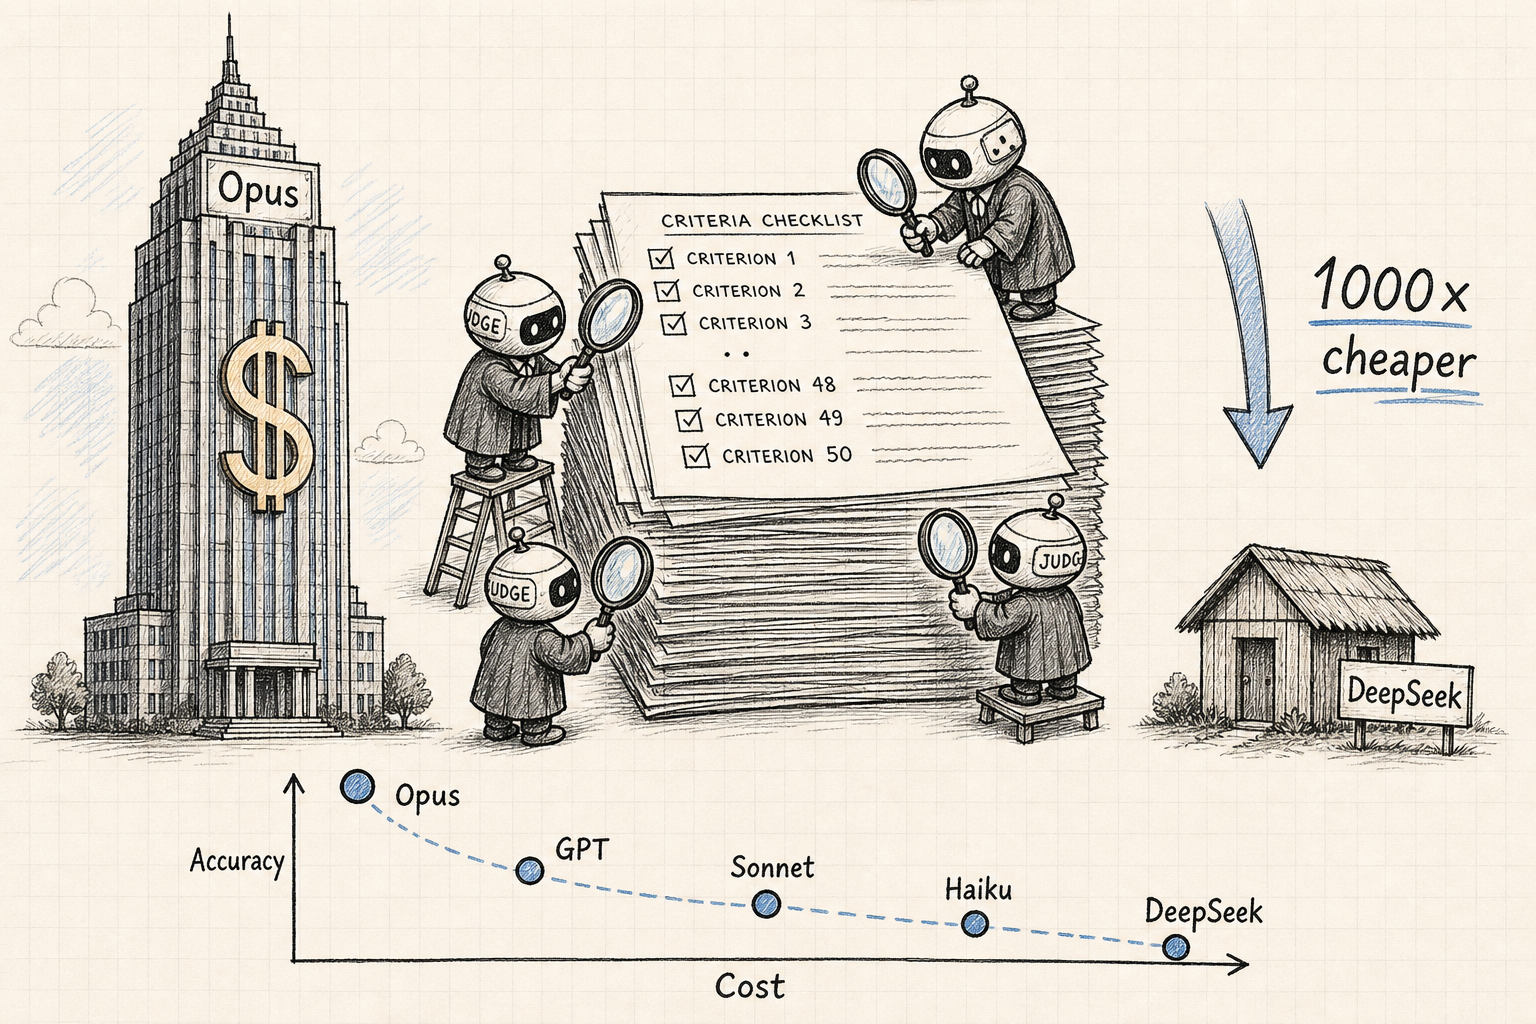
법률 에이전트 검증기 비용 비교 인포그래픽

법률 에이전트 검증 비용을 10분의 1로 — LangChain × Harvey 공동연구

개요 법률 에이전트의 답을 LLM 심판이 채점한다고 칩시다. 한 과제에 채점 기준이 50개가 넘으면, 그걸 다 GPT-5.5나 Opus 4.7로 한 줄씩 돌리는 순간 평가 비용이 학습 비용보다 더 큰 부담이 됩니다. LangChain Labs와 Harvey 팀이 이 병목을 정면으로 다뤘습니다. 결론부터 말하면, 묶음 채점과 오픈 모델을 같이 쓰면 같은 정확도 근방에서 비용이 한 자릿수까지 떨어집니다. ...

2026년 6월 24일 · 4 분 · 708 단어 · TechLLM