노트북 옆에 외장 그래픽카드가 케이블 한 가닥으로 연결된 작업대 장면

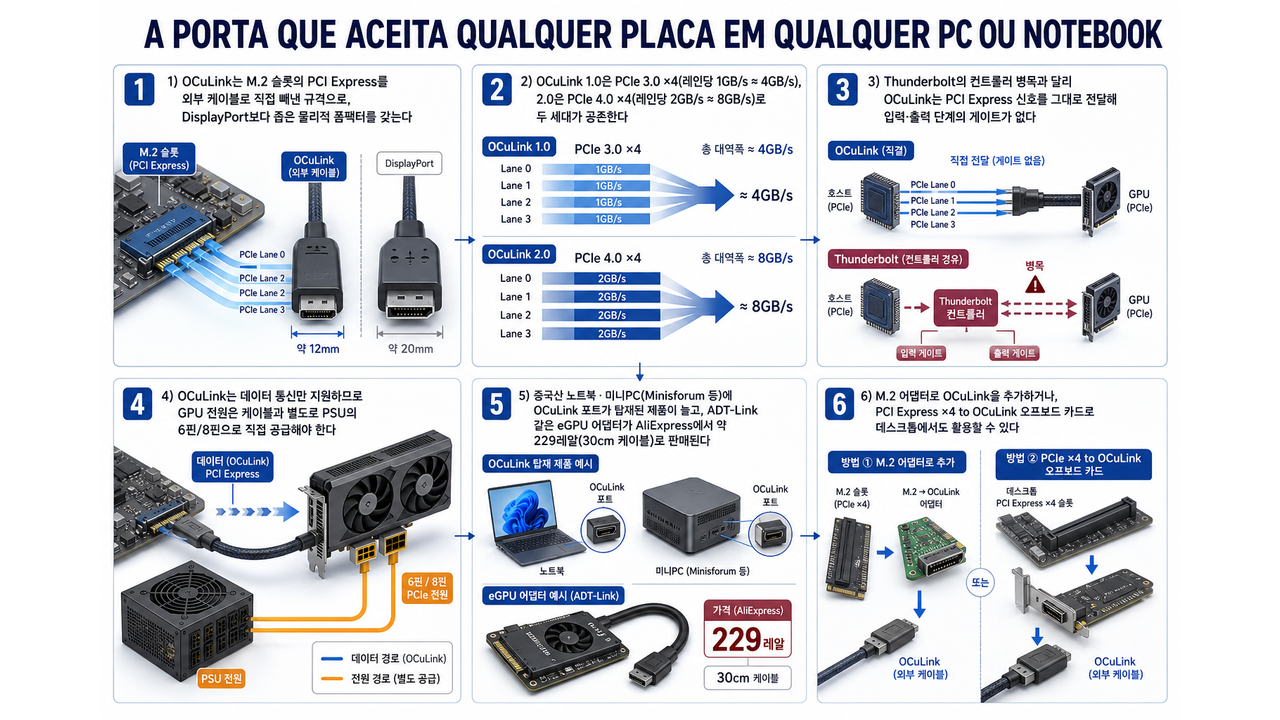
OCuLink 2.0이 eGPU에 8GB/s를 직결한다

노트북에 외장 그래픽카드를 붙이는 가장 빠른 길은 지금 Thunderbolt가 아니라, M.2 슬롯의 PCI Express를 통째로 밖으로 빼내는 OCuLink 케이블이다. 이 커넥터는 DisplayPort보다 좁은 몸집으로 PCI Express 4레인을 그대로 옮긴다. OCuLink 1.0은 PCI Express 3.0 기준 레인당 1GB/s, 합계 약 4GB/s를 낸다. 2.0은 PCI Express 4.0으로 올라가면서 레인당 2GB/s, 합계 약 8GB/s로 정확히 두 배가 된다. 중간에 입출력 컨트롤러 칩이 없다는 점이 Thunderbolt와 갈리는 지점이고, 대신 영상 출력과 전력 공급은 아예 담당하지 않는다. ...
2026년 8월 11일 · 8 분 · 1515 단어 · TechLLM
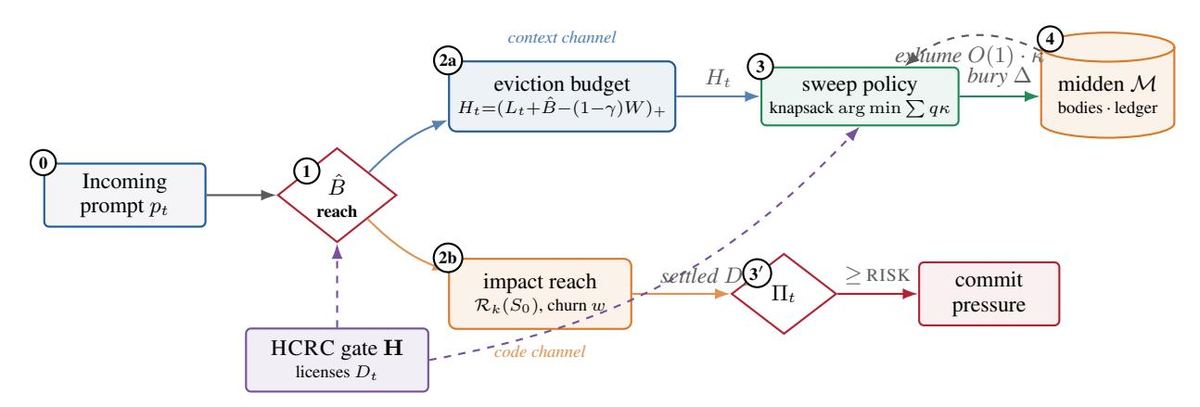
Blast Radius의 두 채널 구조: 컨텍스트 채널은 eviction budget H_t를 만들고, 코드 채널은 churn-weighted dependency reach를 통해 commit-pressure signal Π_t를 만든다.

AI 코딩 도우미가 오래된 기록을 지우지 않고 보관함으로 옮겨, 필요하면 다시 꺼내면서도 매번 읽는 양을 줄이는 방법이다.

AI 코딩 도우미가 오래된 기록을 지우지 않고 보관함으로 옮겨, 필요하면 다시 꺼내면서도 매번 읽는 양을 줄이는 방법이다. 무엇이 문제였나 — AI 코딩 도우미는 작업을 이어가기 위해 이전 대화, 파일 내용, 빌드 로그, 테스트 결과를 매번 다시 읽는다. 어떻게 풀었나 — 하지만 이미 끝난 작업 기록이나 거의 똑같이 반복되는 로그까지 계속 읽으면 비용과 컨텍스트 사용량이 커진다. 그래서 뭐가 좋아졌나 — 이 논문은 오래된 내용은 원문 그대로 보관하고 작은 표식만 남기는 방식으로, 필요하면 되돌릴 수 있게 하면서 토큰을 약 20% 줄였다고 보고한다. ...

2026년 8월 11일 · 6 분 · 1211 단어 · TechLLM
메모리 모듈 한 짝이 반송 상자에 담겨 되돌아가는 장면을 그린 삽화

Micron이 1400달러 램을 241달러에 회수했다

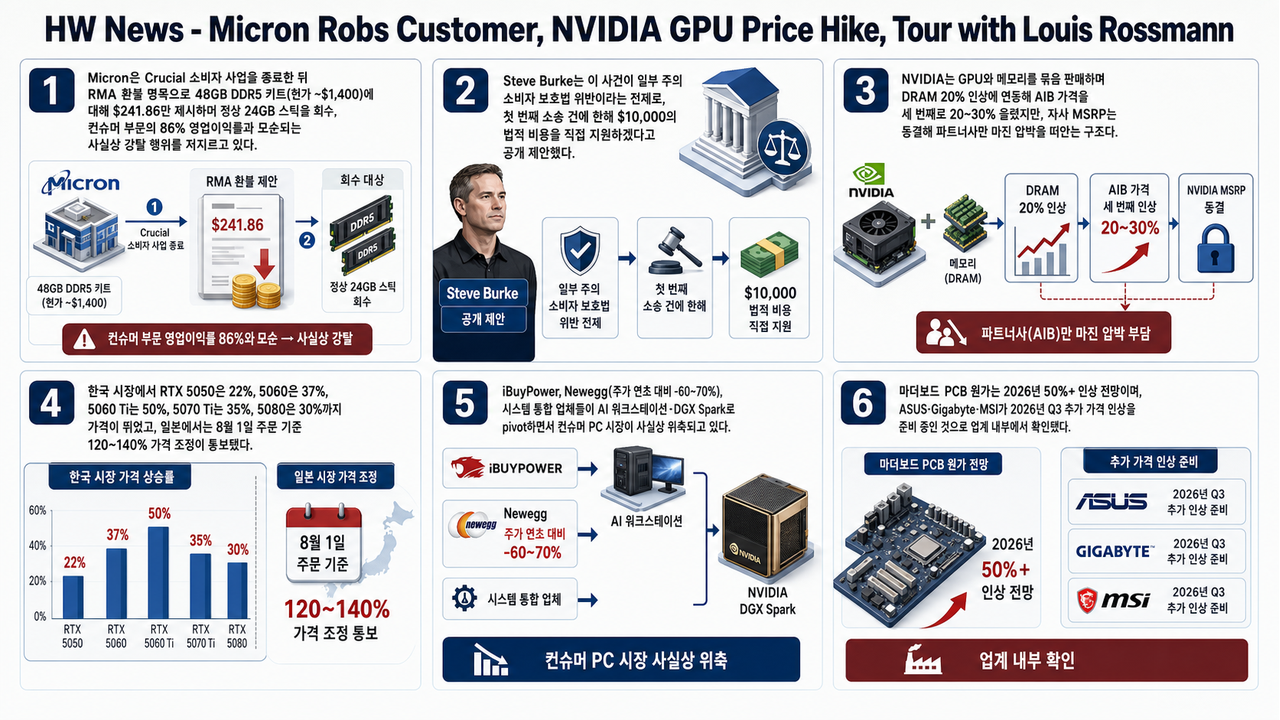
Micron은 시장가 약 1,400달러인 48GB DDR5 키트의 보증 환불액으로 241.86달러를 제시하고, 고장나지 않은 나머지 24GB 스틱까지 회수했다. 핵심 3문장 Micron은 Crucial 소비자 사업을 접은 뒤 48GB DDR5 키트의 보증 처리 환불액으로 241.86달러만 제시했다. 현재 시장가 약 1,400달러 기준 17% 수준이고, 그 대가로 결함이 없는 24GB 스틱까지 반납 대상에 넣었다. NVIDIA는 DRAM 가격 20% 인상에 연동해 GPU와 메모리를 묶은 공급가를 올해 세 번째로 2030% 올렸지만 자사 MSRP는 그대로 뒀다. 그 결과 한국 RTX 5060 Ti 실판매가는 50%, 일본은 8월 1일 주문분부터 120140% 조정이 통보됐다. 마더보드 PCB 원가가 2026년 50% 넘게 오를 전망이고 ASUS·Gigabyte·MSI가 2026년 3분기 추가 인상을 준비하면서, iBuyPower 같은 시스템 통합 업체는 게이밍 PC 대신 AI 워크스테이션과 DGX Spark 쪽으로 라인을 옮기고 있다. 원본 방송: HW News - Micron Robs Customer, NVIDIA GPU Price Hike, Tour with Louis Rossmann (Gamers Nexus) ...

2026년 8월 10일 · 7 분 · 1439 단어 · TechLLM

훈련 데이터를 본 뒤 정답이 맞는 예시만 더 넣어도, 데이터의 순수한 무작위성이 깨져서 어떤 학습법도 일반적인 경우에는 로그만큼 더 느리게 배울 수 있음을 증명한 논문입니다.

훈련 데이터를 본 뒤 정답이 맞는 예시만 더 넣어도, 데이터의 순수한 무작위성이 깨져서 어떤 학습법도 일반적인 경우에는 로그만큼 더 느리게 배울 수 있음을 증명한 논문입니다. 무엇이 문제였나 — 문제: 실제 데이터셋은 수집 후 사람이 보거나 규칙으로 다듬는 경우가 많고, 그러면 표본이 처음 뽑힌 무작위 표본처럼 행동하지 않을 수 있습니다. 어떻게 풀었나 — 해결: 이 논문은 ‘정답 라벨을 가진 예시만 추가한다’는 제한된 조작만으로도 VC 차원 2 이상에서는 최적 오류율에 로그 요인이 반드시 붙는다는 하한을 보입니다. 그래서 뭐가 좋아졌나 — 결과: VC 차원 1은 예외적으로 Θ(1/n)을 유지하지만, VC 차원 2 이상과 Littlestone 차원 2 이상에서는 단순한 ERM의 로그 손실이 실제 최적률과 일치합니다. ...

2026년 8월 10일 · 6 분 · 1109 단어 · TechLLM
생성형 도구로 만든 정치 풍자 영상이 뉴스 한 건에서 출발해 짧은 클립으로 퍼지는 구조를 그린 삽화

AI 트럼프 풍자 영상 7편이 뉴스를 대신하는 방식

Really American이 이번 주 공개한 AI 트럼프 풍자 모음은 클립 일곱 편으로 짜여 있고, 각 편은 실제 뉴스 한 건을 짧은 장면 하나로 눌러 담은 결과물이다. 진행자 스티브는 이 코너를 스스로 “AI 슬롭"이라고 부른다. 생성형 도구로 급히 찍어낸 조악한 영상이라는 자조다. 그런데 실제로 굴러가는 방식은 자조와 어긋난다. 뉴스 한 건을 공유 버튼 하나 거리의 장면으로 옮겨 놓고, 회차 끝에서 11월 중간선거 투표라는 행동 하나로 수렴시킨다. 웃기려고 만든 물건이 동원 도구로 작동한다. ...

2026년 8월 9일 · 7 분 · 1473 단어 · TechLLM
오디언스 캡처부터 개인 AI 정책 공개까지 한크 그린의 발언을 여섯 단계로 정리한 인포그래픽

한크 그린이 제작팀 4곳에 사과하고 AI 정책을 공개했다

한크 그린은 지난주 자신의 LLM 관련 발언이 Complexly 산하 채널 4곳의 신뢰를 훼손했다고 인정하고, 조언·편집·소싱 세 영역에서 LLM 의존을 줄이는 개인 AI 정책을 공개했다. 사과 대상은 Crash Course, SciShow, Eons, Endlings 제작팀이다. 그는 Complexly의 기존 AI 정책은 이미 명확하며 이번 일은 회사 차원의 정책 변경이 아니라 자신의 개인 책임이라고 두 번 강조했다. ...

2026년 8월 9일 · 5 분 · 943 단어 · TechLLM
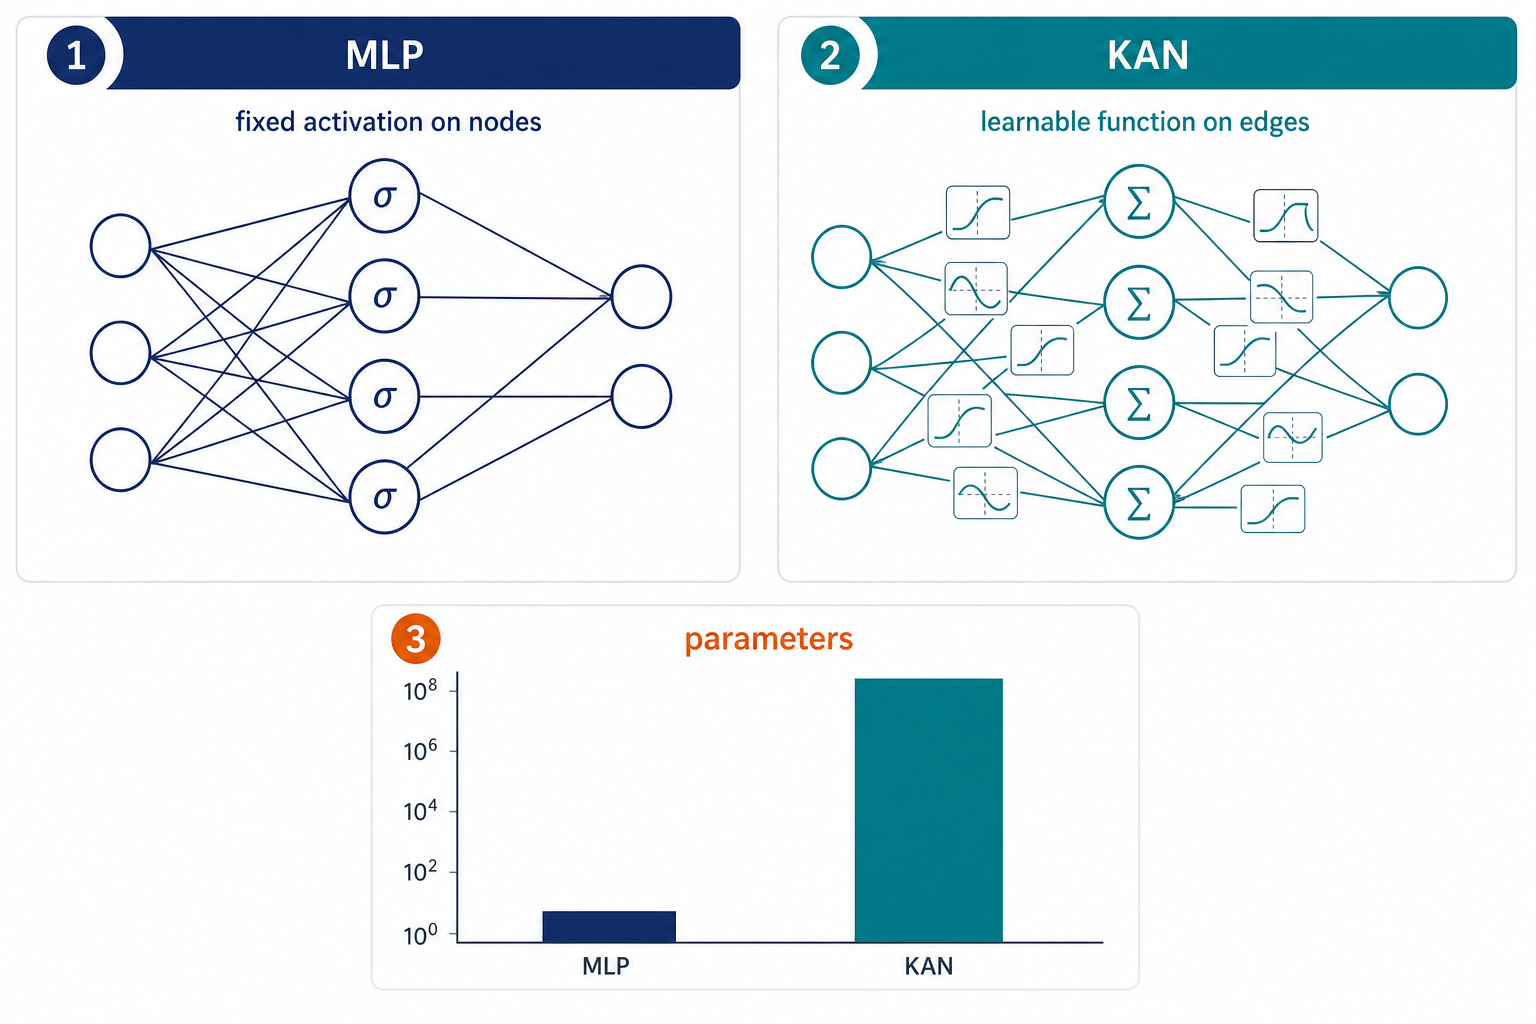
노드에 고정 활성화를 둔 MLP와 엣지마다 학습 가능한 곡선을 둔 KAN의 구조를 나란히 비교한 도해

KAN, 파라미터 200개로 MLP 30만 개를 이겼다

MIT 연구진이 신경망의 곱셈 가중치를 전부 학습 가능한 곡선으로 바꿨더니, 매듭 이론 과제에서 파라미터 200개짜리 모델이 30만 개짜리 MLP보다 정확했습니다. 세 문장 요약 문제 — 지금의 신경망은 대부분 MLP(다층 퍼셉트론, 노드마다 정해진 활성화 함수를 두고 연결선에는 숫자 가중치 하나씩만 두는 구조)를 쌓아 만드는데, 데이터 뒤에 깔끔한 수식이 숨어 있는 과학 문제에서도 파라미터를 크게 늘려야 겨우 정확도가 나오고 학습한 내용을 사람이 읽어내기도 어렵습니다. ...

2026년 8월 8일 · 12 분 · 2347 단어 · TechLLM

데이터베이스가 어떤 실세계 대상을 담고 있는지, AI가 추론하되 그 추론을 데이터로 직접 확인해서 틀린 부분을 잡아내는 자동 설명서 생성기다.

데이터베이스가 어떤 실세계 대상을 담고 있는지, AI가 추론하되 그 추론을 데이터로 직접 확인해서 틀린 부분을 잡아내는 자동 설명서 생성기다. 무엇이 문제였나 — 비전문가가 데이터를 쓰려면 ‘이 테이블이 무엇을 의미하는지, 어떻게 연결되는지’를 전문가가 손으로 적어야 하는 병목이 있었다. 어떻게 풀었나 — TYTAN은 DB 구조는 결정론적으로 분석하고, 의미 해석은 LLM에 맡긴 뒤, 모든 제안을 실제 데이터에 대해 검증하고 모호하면 사용자에게 한두 줄 질문한다. 그래서 뭐가 좋아졌나 — 그 결과 누구나 자연어로 복잡한 분석 질문을 할 수 있게 해주는 신뢰할 수 있는 데이터 설명서가 거의 자동으로 만들어진다. ...

2026년 8월 8일 · 5 분 · 861 단어 · TechLLM

학습 중에만 어텐션을 압축했다가 마지막에 원래 방식으로 돌려놓으면, 긴 문맥을 훨씬 빠르고 저렴하게 학습하면서도 정상적인 모델을 얻는다.

학습 중에만 어텐션을 압축했다가 마지막에 원래 방식으로 돌려놓으면, 긴 문맥을 훨씬 빠르고 저렴하게 학습하면서도 정상적인 모델을 얻는다. 무엇이 문제였나 — 긴 문맥(10만100만 토큰) 학습은 어텐션의 제곱 비용 때문에 GPU 시간과 메모리가 폭발한다. 어떻게 풀었나 — 질문·키·값을 같이 여러 해상도로 압축하고 중요한 것만 골라 표준 어텐션을 돌린 뒤, 마지막에 잠깐 원래 어텐션으로 마무리한다. 그래서 뭐가 좋아졌나 — 동일 토큰 예산에서 dense baseline보다 loss가 더 낮거나 같으면서 1.41.7× wall-clock을 절약하고, 512K에서는 21× 빨라진다. ...

2026년 8월 8일 · 4 분 · 796 단어 · TechLLM