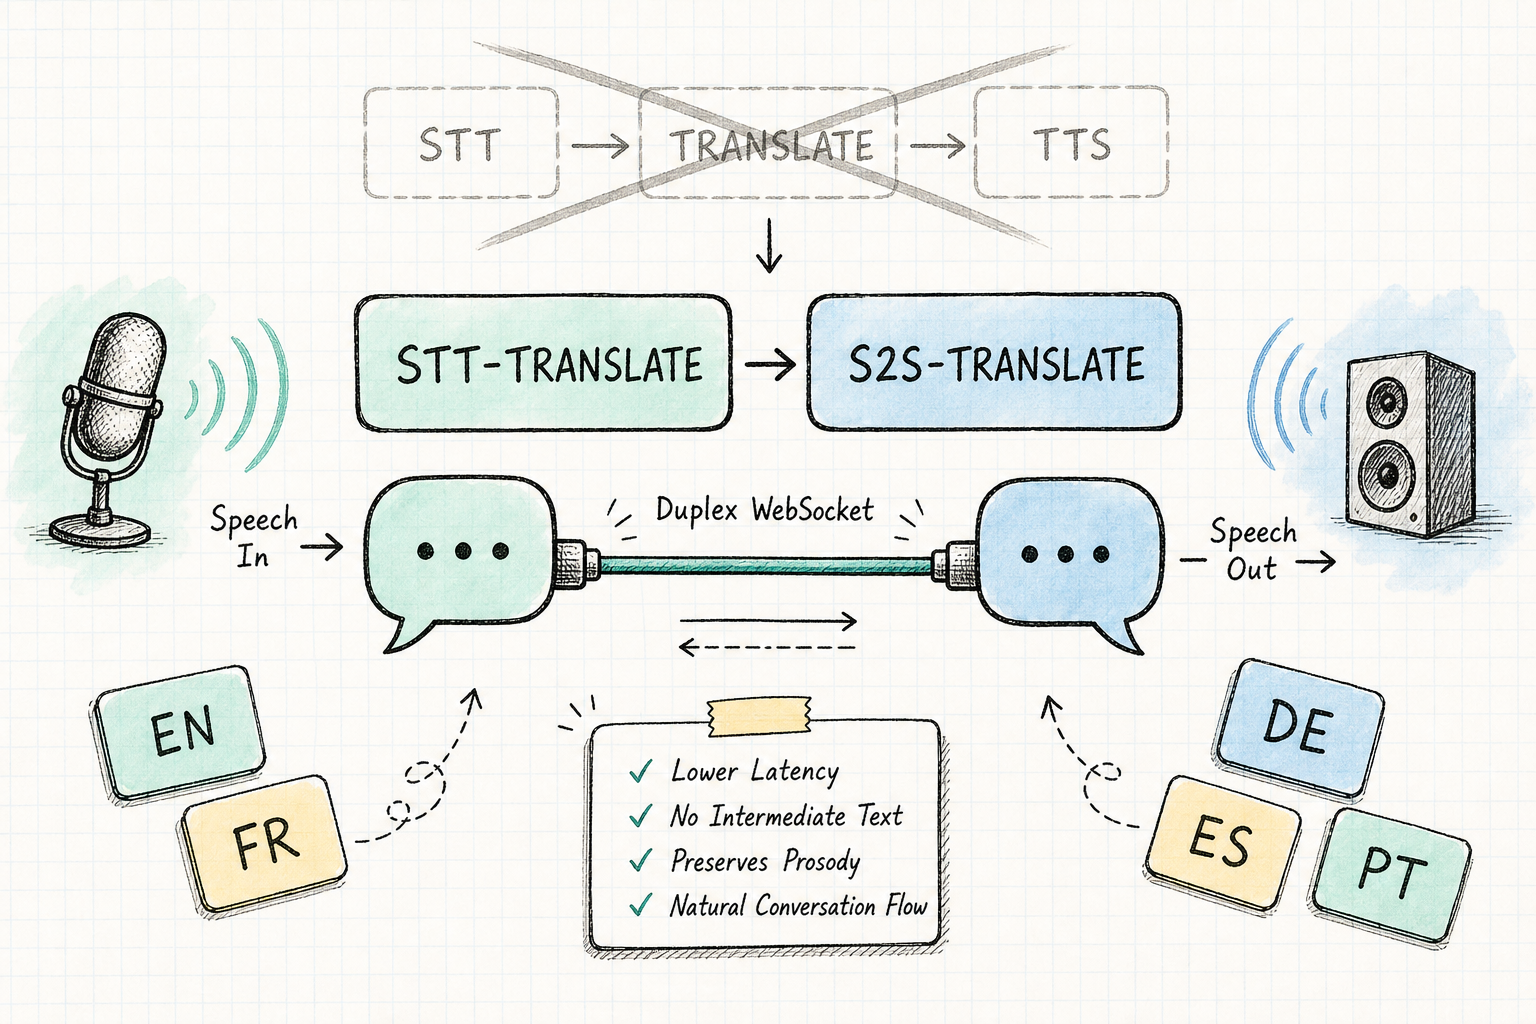
Gradium 실시간 음성 번역 파이프라인

Gradium이 stt-translate와 s2s-translate를 공개했다 — 3-모델 파이프라인을 2개로 줄인 실시간 음성번역

개요 Gradium이 실시간 음성번역 모델 두 개를 한꺼번에 내놨습니다. 음성을 받아 다른 언어 텍스트로 돌려주는 stt-translate, 음성을 받아 다른 언어 음성으로 돌려주는 s2s-translate. 둘 다 브라우저에서 바로 스트리밍됩니다. 회사 주장으로는 OpenAI gpt-realtime-translate보다 정확도-지연 균형이 좋고, Gemini의 gemini-3.5-live-translate보다도 정확도에서 앞섭니다. 게다가 GPT에는 없는 출력 음성 선택과 보이스 클로닝까지 붙였습니다. ...
2026년 6월 25일 · 5 분 · 924 단어 · TechLLM
추론 스타트업 베이스텐 메가 라운드

베이스텐, 5개월 만에 또 1.5B 달러 — 추론 골드러시는 식지 않는다

베이스텐(Baseten)이 또 큰 수표를 받습니다. 테크크런치 보도에 따르면 이 회사는 130억 달러 밸류에이션에 15억 달러 규모의 신규 라운드를 마무리하는 중입니다. 불과 다섯 달 전에 50억 달러 밸류로 3억 달러 시리즈 E를 끝낸 회사인데, 같은 해 같은 분기 안에 다시 두 배 반짜리 라운드를 더 얹는 셈입니다. AI 추론(inference) 레이어로 돈이 얼마나 쏠리고 있는지, 그 흐름이 가장 노골적으로 드러나는 사례입니다. ...

2026년 6월 19일 · 4 분 · 660 단어 · TechLLM
핸드드로잉 스타일로 로켓 격납고와 GPU 서버랙, 클라우드 연결망을 함께 표현한 그림

SpaceX와 Google의 11만 Nvidia AI 칩 계약, AI 인프라 임대 시장이 열렸다

SpaceX가 Google에 대규모 AI 컴퓨팅 용량을 제공하는 계약을 맺었다는 공시가 나왔습니다. 숫자부터 큽니다. 월 9.2억 달러. 기간은 2026년 10월부터 2029년 6월까지. 제공 대상은 약 11만 개 NVIDIA GPU와 CPU, 메모리 등 관련 구성품입니다. ...

2026년 6월 14일 · 4 분 · 838 단어 · TechLLM
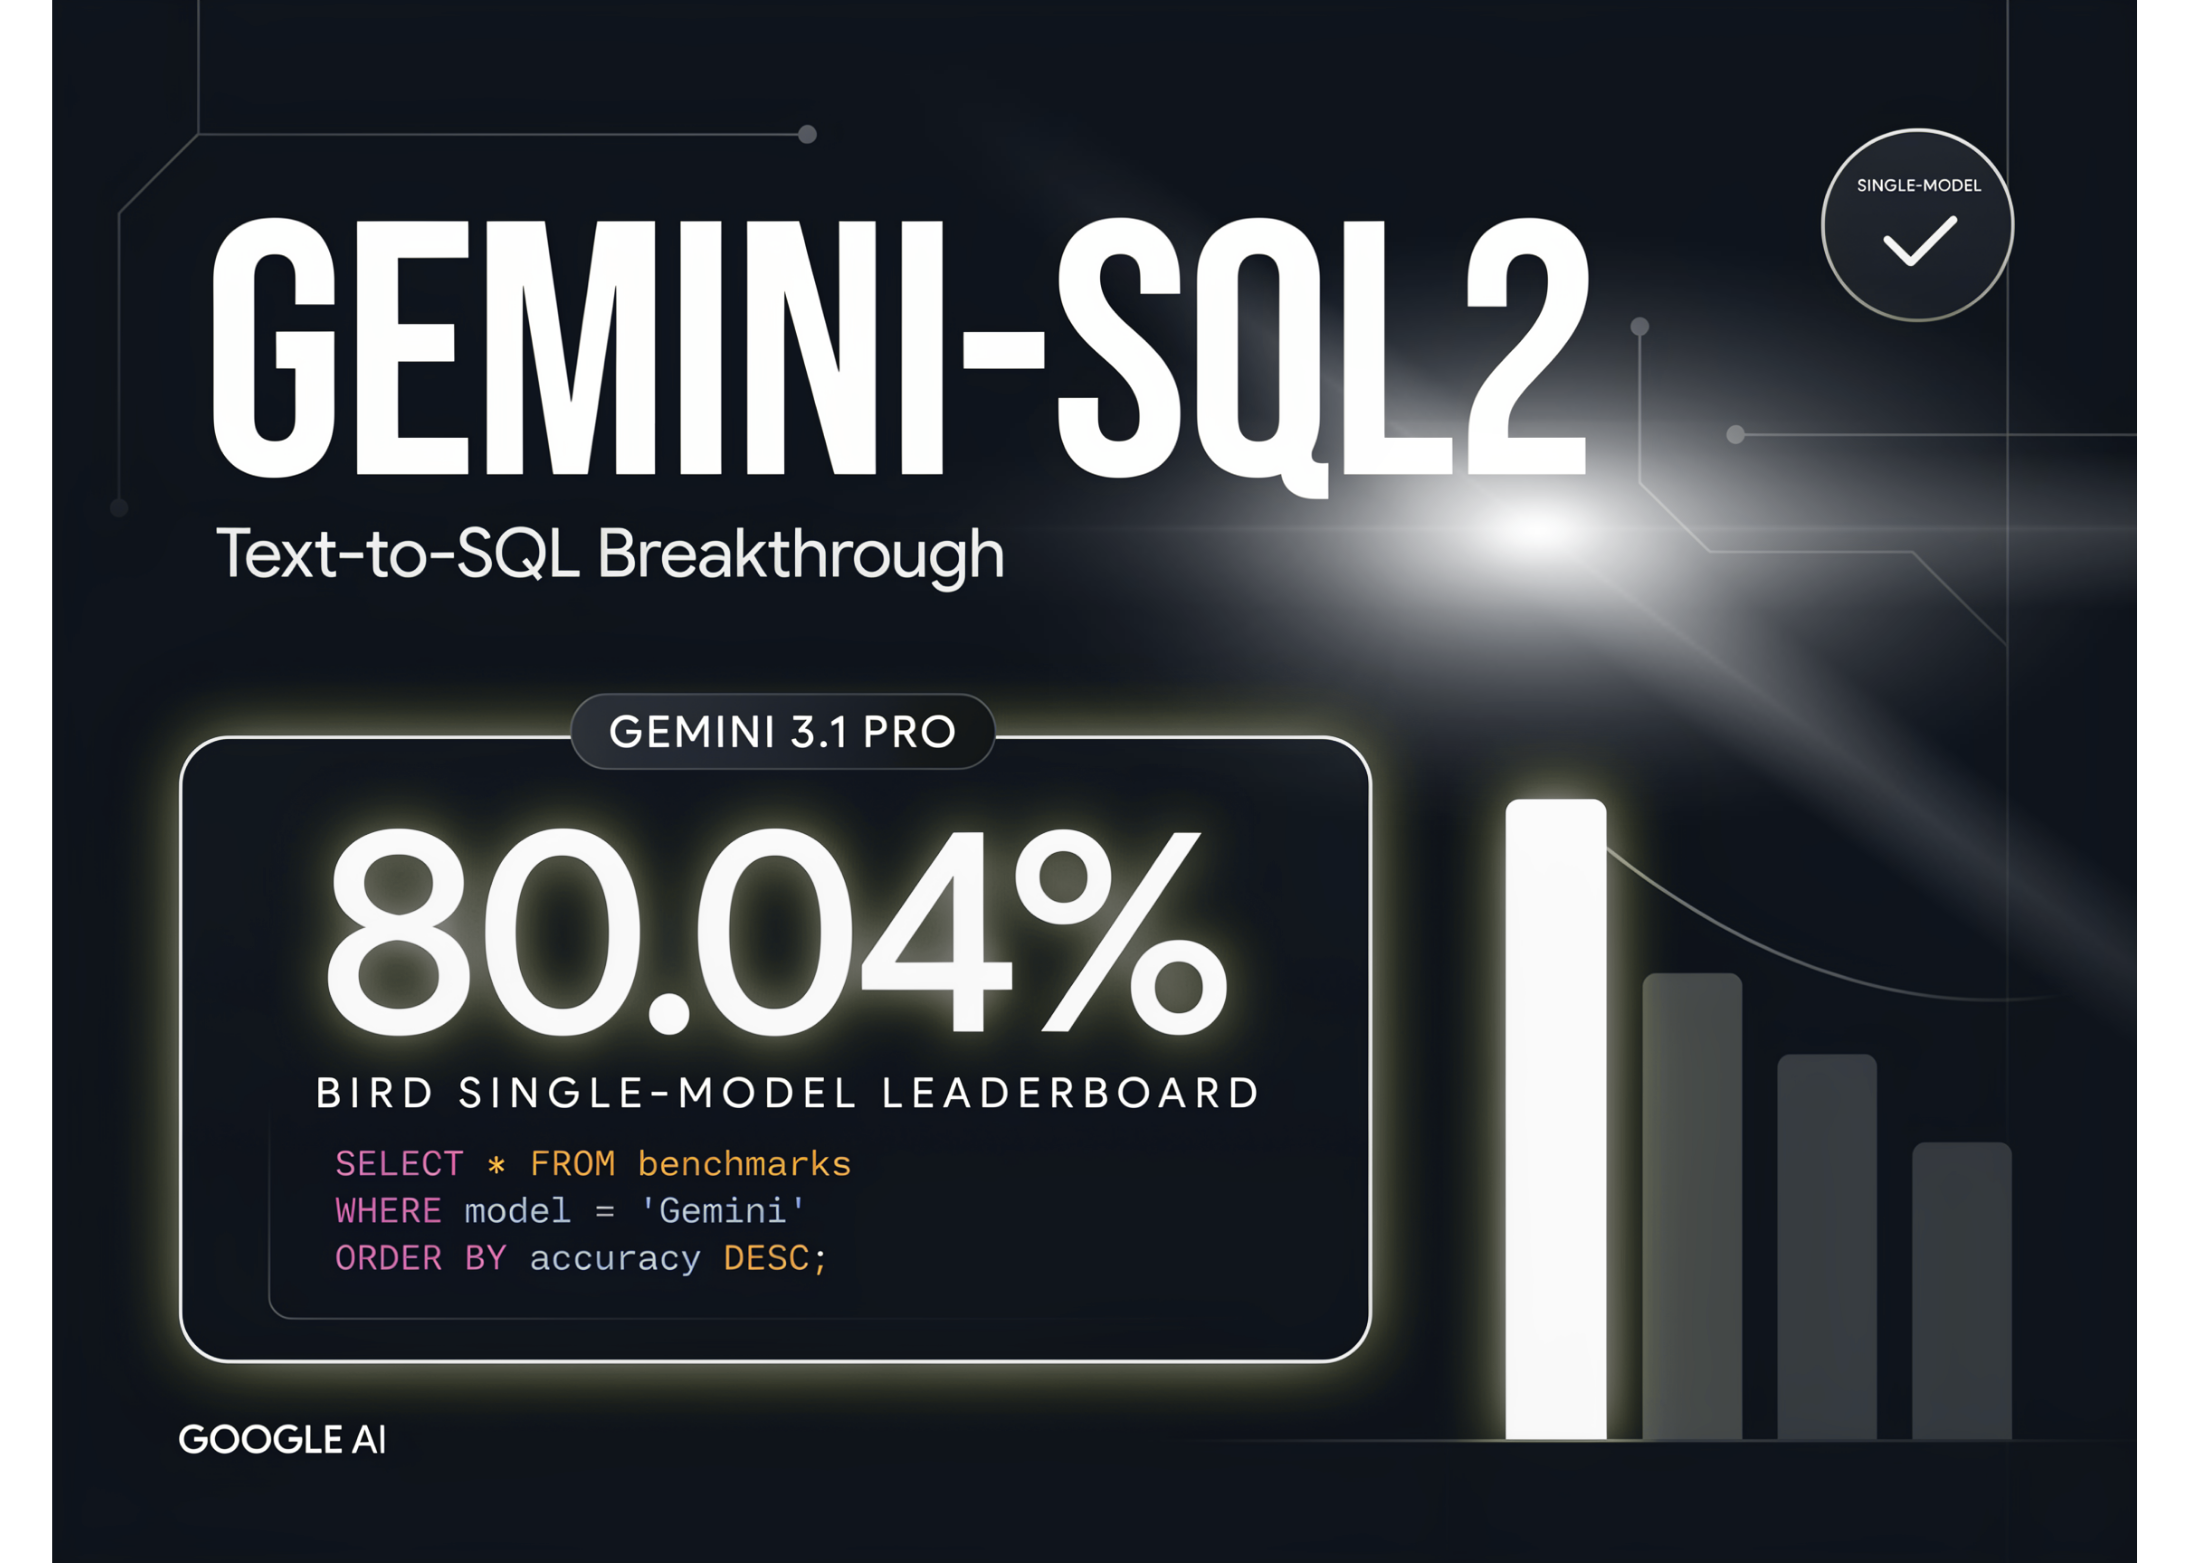
Gemini-SQL2, BIRD 단일 모델 리더보드 80.04%

구글 Gemini-SQL2: BIRD 단일 모델 80.04%로 텍스트-투-SQL 1위

구글이 6월 12일 Gemini-SQL2를 공개했습니다. 이름만 보면 또 다른 신규 모델 같지만, 실상은 Gemini 3.1 Pro 위에 얹은 텍스트-투-SQL 전용 능력입니다. 자연어 질문을 받아 곧장 돌아가는 SQL을 만들어 주는 쪽에 무게를 둔 업데이트라고 보면 됩니다. 숫자가 화제입니다. 업계 표준 벤치마크인 BIRD의 단일 모델 부문에서 실행 정확도 80.04%를 찍었습니다. 7개월 전만 해도 같은 구글의 이전 기록이 76.13%였습니다. ...

2026년 6월 13일 · 4 분 · 755 단어 · TechLLM
olmo-eval 워크벤치 개요

Ai2 olmo-eval: 모델 개발 루프를 위한 평가 워크벤치

Allen Institute for AI(이하 Ai2)가 6월 12일 olmo-eval이라는 평가 워크벤치를 공개했습니다. 모델을 다 만든 다음 한 번 평가하는 도구가 아니라, 학습 중에 체크포인트가 쏟아질 때마다 같은 벤치마크를 빠르게 다시 돌리는 데 초점을 둔 도구입니다. 토대는 Ai2가 2024년에 내놓은 OLMES(Open Language Model Evaluation Standard)인데, 거기에 개발자가 매일 반복하는 평가 루프를 그대로 옮겨 담았습니다. ...

2026년 6월 13일 · 4 분 · 759 단어 · TechLLM
DeepSeek V4 추론 성능 비교 차트

DeepSeek V4 출시 43일, 추론 최적화 전쟁의 실제 성적표

DeepSeek V4 1.6T가 공개된 지 43일이 지났습니다. SemiAnalysis가 이 기간 동안 NVIDIA, AMD, 화웨이 진영의 추론 스택이 어떻게 진화했는지 추적한 보고서를 내놓았는데, 숫자가 흥미롭습니다. 같은 모델, 같은 하드웨어인데 26일 만에 처리량이 100배 늘어난 경우도 있었습니다. 오늘은 그 보고서를 한국어로 정리합니다. ...

2026년 6월 10일 · 5 분 · 1018 단어 · TechLLM
Reflective prompt optimization with GEPA

GEPA로 짓는 반사형 프롬프트 최적화: 다중 컴포넌트 + 구조화 피드백 + 홀드아웃 검증

개요 수동 프롬프트 튜닝은 끝이 없다. 한 줄 고치고 돌려보고, 또 한 줄 고치고 다시 돌리고. MarkTechPost가 6월 7일 공개한 GEPA 튜토리얼은 그 루프를 LLM 두 대와 점수 함수에 떠넘긴다. 약한 작업 모델은 풀고, 강한 리플렉션 모델은 프롬프트를 고친다. 사람은 평가 기준만 정확히 적어주면 된다. ...

2026년 6월 8일 · 4 분 · 645 단어 · TechLLM
Claude Opus 4.8 출시

Claude Opus 4.8 출시 — 더 정직하고 더 빠른 협업 AI

핵심 요약 Anthropic, Claude Opus 4.8 출시 — Opus 4.7 대비 벤치마크 전반 개선, 동일 가격 유지 다이나믹 워크플로 출시: Claude Code에서 수백 개의 병렬 서브에이전트 실행, 코드베이스 전체 마이그레이션 자동화 노력 제어(Effort Control): 사용자가 응답 품질과 속도를 직접 선택 가능 Opus 4.8, 코드 결함을 무심코 통과시킬 확률이 이전 모델 대비 약 4배 낮음 빠른 모드(Fast Mode) 비용 3배 인하 — 입력 $10/M, 출력 $50/M 토큰 왜 Opus 4.8인가 Anthropic은 오늘 Claude Opus 4.8을 공식 발표했다. Opus 4.7의 직계 후속 모델로, 같은 가격을 유지하면서 코딩·에이전트 작업·추론·실무 지식 작업 전반에서 성능을 끌어올렸다. ...

2026년 5월 29일 · 3 분 · 527 단어 · TechLLM
Qwen3.7-Max 공식 메인 배너 이미지

Qwen3.7-Max, 에이전트 시대를 겨냥한 Qwen의 새 플래그십

Qwen 팀이 Qwen3.7-Max를 공개했다. 이번 글에서 Qwen은 이 모델을 단순한 채팅 모델이 아니라, 코딩·업무 자동화·장기 자율 실행을 수행하는 에이전트 기반 모델로 소개한다. 핵심은 벤치마크 점수 하나가 아니라, 여러 하네스와 도구 환경에서 오래 버티며 문제를 풀 수 있는가에 있다. ...

2026년 5월 23일 · 4 분 · 649 단어 · TechLLM