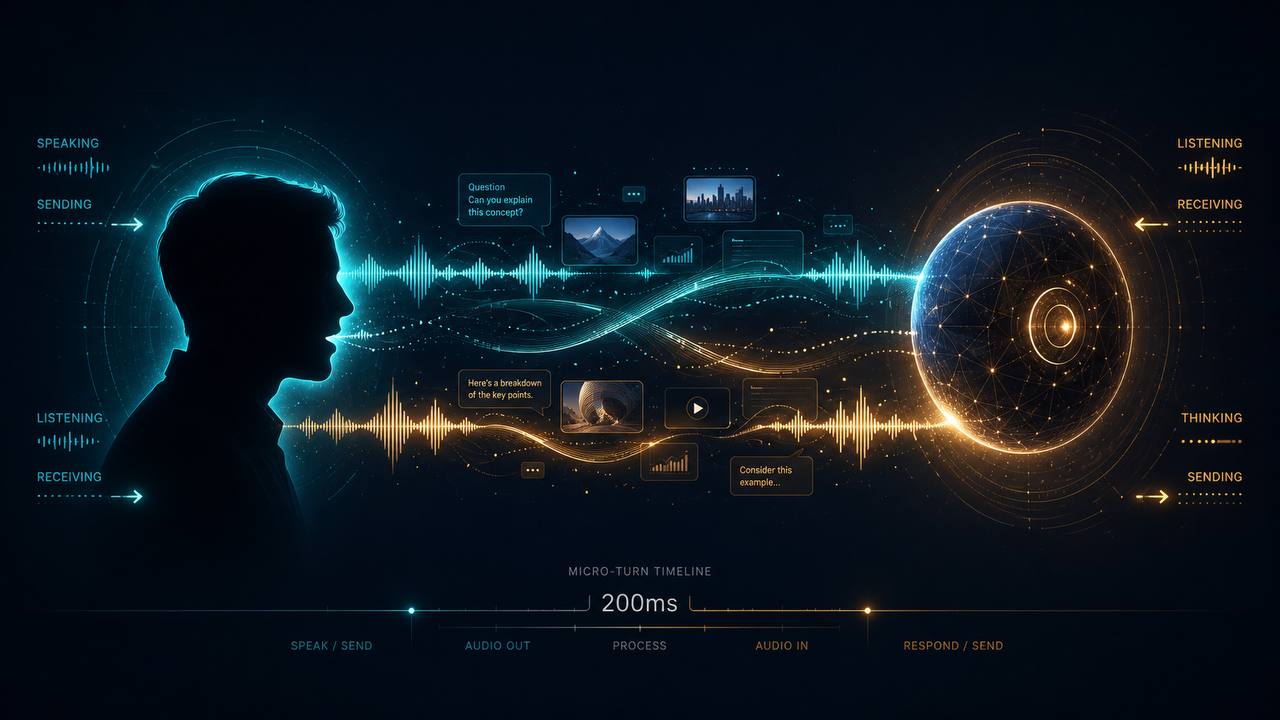
Thinking Machines 인터랙션 모델이 사용자와 AI가 실시간으로 양방향 협업하는 모습을 표현한 일러스트

Thinking Machines 인터랙션 모델 — 외부 하네스 없이 모델이 직접 실시간 협업한다

핵심 요약 Thinking Machines가 TML-Interaction-Small을 research preview로 공개했다. “AI와의 상호작용” 자체를 모델이 네이티브로 처리하는 새 패러다임이다. 현재 frontier 모델은 사용자를 자율 워크플로 밖으로 밀어내며 협업 대역폭을 좁히는 흐름이었다 — 인터랙션 모델은 이 추세를 반대 방향으로 잡는다. 핵심 설계는 time-aligned micro-turn (200ms) — 입력과 출력을 200ms 단위로 인터리브해 audio·video·text가 동시 흐른다. 인터랙션 모델 + 백그라운드 모델 이원 구조 — 실시간 응답성과 reasoning 깊이를 동시에 확보. 벤치마크: 턴테이킹 지연 0.40초(GPT-realtime-2.0 minimal 1.18초의 1/3), FD-bench v1.5 평균 77.8 (다음 후보 54.3), Audio MultiChallenge 43.4%(instant 모델 중 1위). 협업 병목 — 자율성 경쟁이 가린 사용자 AI 연구의 주류 서사는 모델이 사람 없이 얼마나 멀리 갈 수 있는가에 맞춰져 왔다. METR의 “long-task” 측정처럼 자율 능력이 핵심 지표로 자리 잡으며, 인터페이스는 사람이 빠진 자율 실행을 전제로 진화했다. Anthropic이 자사 model card에서 직접 짚었듯, 일부 모델은 hands-on-keyboard 패턴에서 너무 느리게 느껴져 가치가 작아 보이고, 장시간 자율 agent harness가 더 잘 작동한다는 평가가 자리 잡고 있다. ...
2026년 5월 12일 · 4 분 · 749 단어 · TechLLM
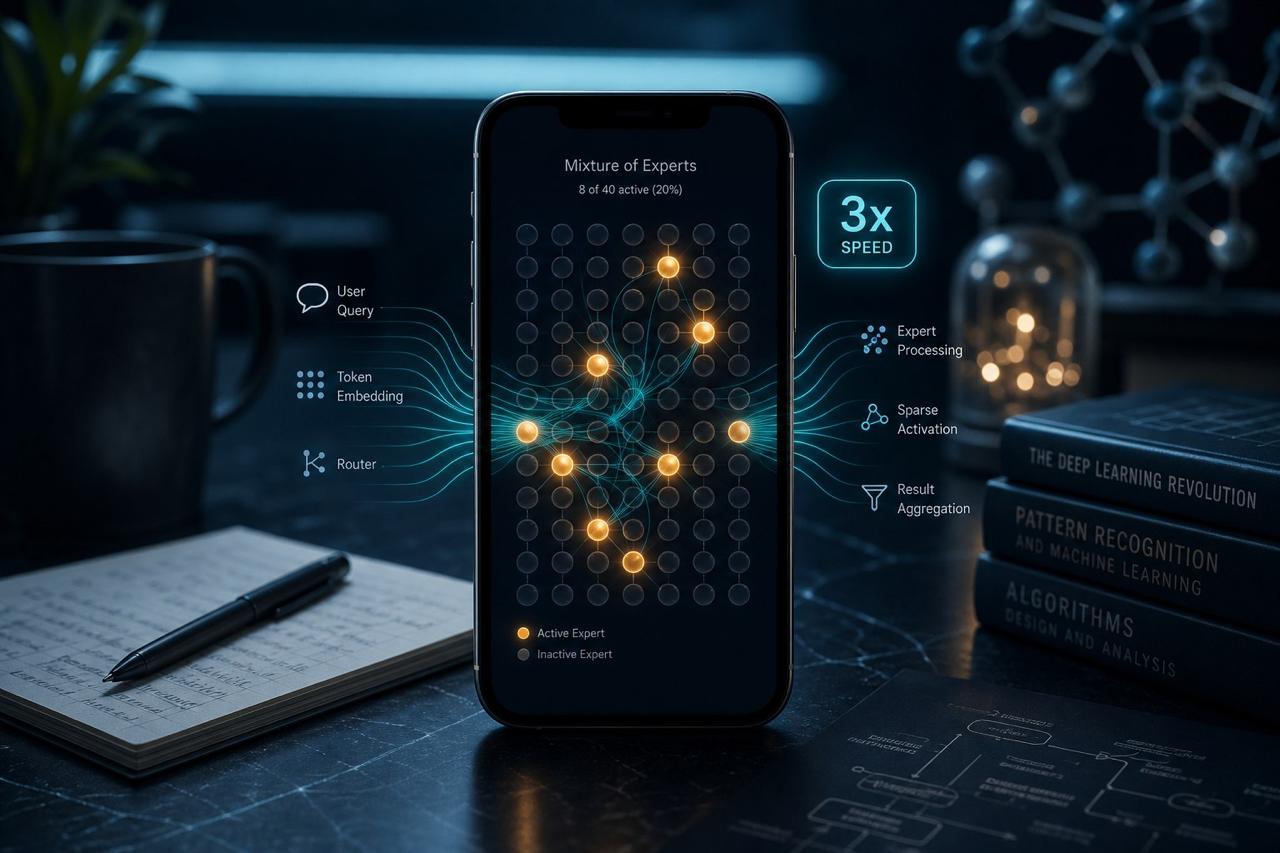
DECO 아키텍처가 온디바이스 환경에서 sparse MoE로 dense 성능을 따라잡는 모습을 표현한 일러스트

DECO — 온디바이스 LLM에 처음 'dense 매칭' MoE를 데려온다

핵심 요약 새로 공개된 DECO는 sparse MoE를 dense Transformer 성능에 매칭시키는 아키텍처다 — 동일 total parameter 예산·학습 토큰 조건에서. 핵심은 세 가지: ① 학습 가능한 expert-wise scaling이 결합된 ReLU 기반 라우팅, ② SiLU 앞에 normalize를 두는 NormSiLU 활성화, ③ non-gated MLP expert + ReLU 라우팅 조합. 전체 expert 중 20%만 활성화해도 dense 모델 성능을 따라잡고, 기존 MoE baseline을 능가했다. 전용 가속 커널 적용 시 실제 하드웨어에서 dense 추론 대비 3.00× speedup. 코드와 체크포인트가 공개 예정이라 온디바이스 LLM에 MoE를 진지하게 적용해볼 첫 실용적 후보가 될 가능성이 있다. MoE는 왜 온디바이스에서 잘 안 됐나 Mixture-of-Experts(MoE)는 LLM 효율화의 단골 후보다. 전체 capacity는 크게, 한 번 추론에 쓰는 계산은 작게. 클라우드 환경에서는 이 트레이드오프가 매력적이지만, 휴대폰·노트북·임베디드 같은 end-side(온디바이스) 환경으로 옮기면 다른 문제가 튀어나온다. ...

2026년 5월 12일 · 4 분 · 760 단어 · TechLLM
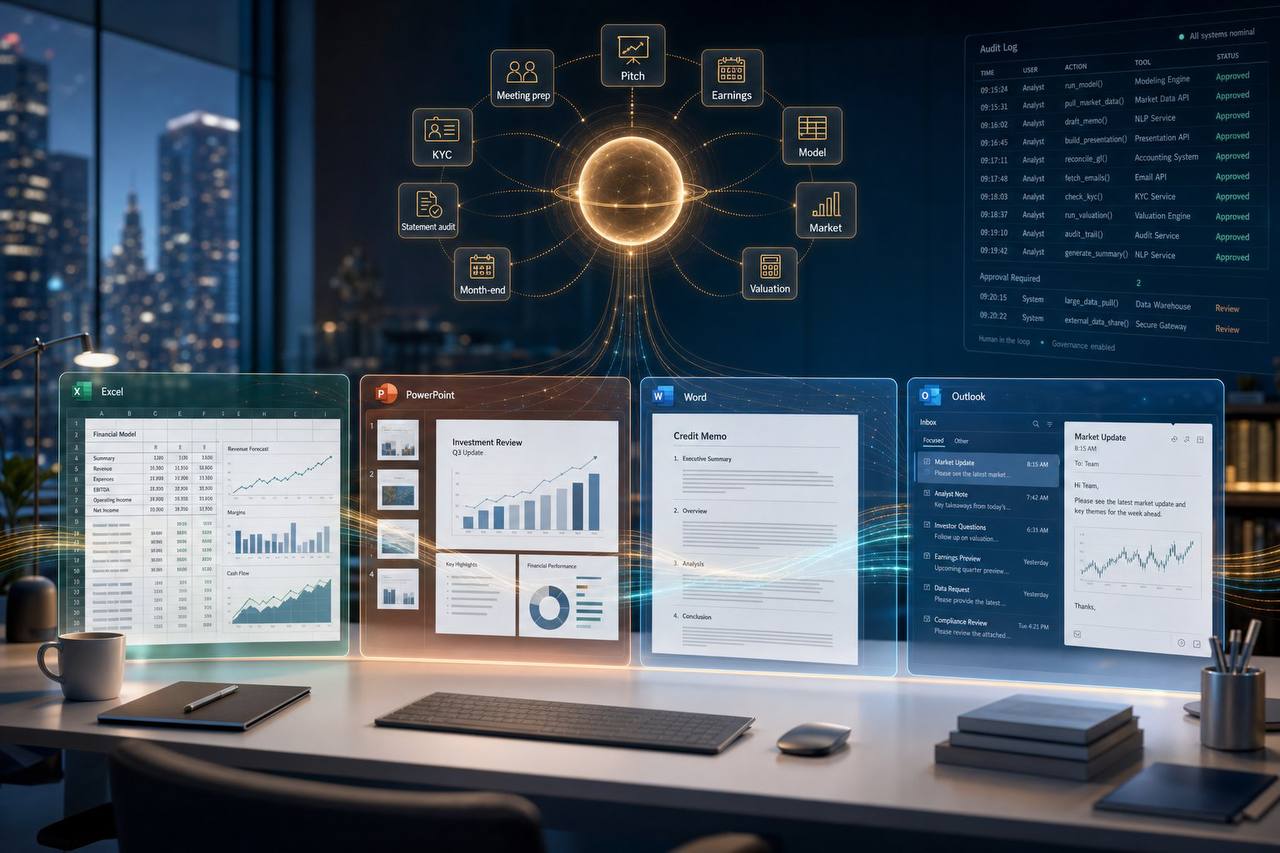
Anthropic이 공개한 금융 서비스용 Claude 에이전트 템플릿 10종을 표현한 일러스트

Anthropic, 금융 업무용 Claude 에이전트 10종 공개 — 피치북부터 월말 결산까지

핵심 요약 Anthropic이 금융 서비스용 Claude 에이전트 템플릿 10종을 공개했다 — 리서치·클라이언트 커버리지 5종, 재무·운영 5종. 각 템플릿은 Claude Cowork·Claude Code 플러그인, 또는 Claude Managed Agents 쿡북 두 형태로 즉시 도입할 수 있다. Claude Excel·PowerPoint·Word add-in이 정식 출시됐고 Outlook도 곧 합류한다. 모델·덱·메모 간 컨텍스트가 끊김 없이 이어진다. Dun & Bradstreet, FactSet, Moody’s MCP 앱 등 새 커넥터와 파트너가 추가되며 거버넌스 기반 실시간 데이터 접근이 확대됐다. Claude Opus 4.7이 Vals AI Finance Agent 벤치마크에서 **64.37%**로 업계 1위를 기록했다. 왜 이번 발표가 의미 있나 Anthropic은 이번 발표에서 새로운 모델보다 금융 업무 형태에 맞춘 에이전트 패키지에 무게를 두었다. 단일 LLM의 성능 향상이 아니라 분석가·트레이더·컴플라이언스가 매일 반복하는 작업 단위에 맞춰 스킬·데이터·서브에이전트가 묶여 있다는 게 핵심이다. Vals AI Finance Agent 벤치마크에서 Claude Opus 4.7이 **64.37%**로 1위에 오른 점도 같은 방향을 가리킨다. 모델만 좋아진 게 아니라 모델·도구·데이터 결합 결과가 경쟁 모델보다 앞서 있다는 신호다. ...

2026년 5월 12일 · 5 분 · 875 단어 · TechLLM
RAG 시스템 구조 — 검색과 생성의 연결

외부 라이브러리 없이 RAG를 직접 만들어보자 — Python + ollama로 처음부터 구현하기

LangChain이나 LlamaIndex 없이, RAG를 밑바닥부터 만들 수 있을까? 개요 Retrieval-Augmented Generation(RAG)은 LLM이 학습 데이터에 없는 외부 지식을 참조해 답변을 생성하게 만드는 구조다. 요즘은 프레임워크가 많아서 몇 줄이면 RAG를 붙일 수 있지만, 내부에서 무슨 일이 일어나는지 이해하지 못한 채 쓰면 디버깅도, 튜닝도 막막해진다. ...

2026년 5월 12일 · 3 분 · 605 단어 · TechLLM
과학 논문의 미래 — AI 시대의 지식 단위 재설계

논문이라는 단위가 사라질 수 있다 — AI가 과학 출판의 다음 형식을 묻고 있다

360년 전 등장한 ‘논문’이라는 형식이 AI 앞에서 흔들리고 있다. 핵심 요약 AI를 쓰는 연구자들은 이전보다 훨씬 많은 논문을 출판하고 있고, 시스템은 이를 감당하지 못하고 있다 Google의 Paper Orchestra는 연구 노트를 받아 40분 안에 제출 가능한 논문을 생성한다 ICLR 2026 제출 리뷰의 21%가 AI가 작성한 것으로 추정된다 Caltech의 OpenEval은 논문을 개별 ‘주장’ 단위로 분해해 AI가 평가하는 새로운 레이어를 제안한다 공통된 진단: 논문은 너무 많은 기능을 하나의 형식에 묶어놓았고, 그 묶음이 풀리기 시작했다 논문은 원래 혁신이었다 케플러의 《신천문학》은 10년치 관측을 책 한 권에 담았다. 뉴턴의 《프린키피아》도 수십 년의 사고를 집약한 대작이었다. 그런데 1665년 런던 왕립학회가 《Philosophical Transactions》를 창간하면서 흐름이 바뀌었다. 잠정적 발견을 작은 단위로 빠르게 공유할 수 있게 됐다. 다윈은 이 짧은 형식을 불신했고(“내 이론은 저널에서 과학적으로 다루기 어렵다”), 그러면서도 결국 이 형식이 표준이 됐다. ...

2026년 5월 11일 · 4 분 · 698 단어 · TechLLM
Gemini API File Search 멀티모달 RAG — 이미지와 텍스트를 함께 검색하는 인터페이스

Gemini API File Search 멀티모달 지원 — 이미지·텍스트·메타데이터를 한 번에 검색하는 RAG

RAG(검색 증강 생성)를 구축할 때 가장 큰 벽은 비정형 데이터다. PDF 수백 장, 이미지 수천 장이 섞인 기업 자료에서 원하는 정보를 정확히 찾고, 출처까지 명확하게 표시하는 것 — 지금까지는 직접 파이프라인을 쌓아야 했다. ...

2026년 5월 10일 · 4 분 · 738 단어 · TechLLM

OncoAgent: 환자 데이터를 병원 밖으로 내보내지 않는 암 치료 AI 에이전트

병원 AI가 환자 기록을 외부 클라우드로 전송한다면? 의사는 이 시스템을 쓸 수 없다. 개인정보 보호법이 막고, 윤리 위원회가 막고, 환자가 막는다. OncoAgent는 이 문제를 정면으로 해결한다. 모든 추론과 학습을 병원 내 서버에서 끝낸다. 클라우드 API 없이. 환자 데이터 유출 없이. 그러면서도 70개 이상의 국제 암 치료 가이드라인을 실시간으로 참조한다. ...

2026년 5월 10일 · 5 분 · 960 단어 · TechLLM
transformers에서 MLX로 모델을 포팅하는 AI 에이전트 스킬 개념도

에이전트가 PR을 열면 안 되는 이유 — HuggingFace의 transformers→MLX 포팅 스킬

에이전트가 코드를 짜고, 이슈를 찾고, PR까지 열어준다. 좋아 보인다. 그런데 오픈소스 메인테이너들은 지금 곤혹스럽다. PR이 10배 늘었는데, 대부분 쓸 수 없는 것들이다. HuggingFace가 이 문제를 정면으로 파고든 글을 2026년 4월 공개했다. transformers 모델을 Apple Silicon용 MLX 프레임워크로 포팅하는 AI 스킬을 만들면서, 에이전트 시대 오픈소스 기여가 어때야 하는지 기준을 제시했다. ...

2026년 5월 10일 · 3 분 · 611 단어 · TechLLM
NVIDIA Nemotron 3 Nano Omni 멀티모달 AI — 문서·오디오·비디오 통합 처리

NVIDIA Nemotron 3 Nano Omni: 문서·오디오·비디오를 한 번에 처리하는 멀티모달 AI

문서를 읽고, 목소리를 듣고, 영상을 보고, 화면을 조작한다 — 이 모든 걸 단일 모델 하나로. NVIDIA가 공개한 Nemotron 3 Nano Omni 30B-A3B는 기존 비전-언어 모델의 경계를 텍스트·이미지·비디오·오디오 전체로 확장한 옴니모달 모델이다. ...

2026년 5월 10일 · 4 분 · 710 단어 · TechLLM