MAPS 가이드의 네 가지 설계 층을 소개하는 이미지

Claude Code를 개인 AI 운영체제로 만드는 MAPS 설계법

핵심 요약 MAPS 가이드는 Claude Code를 단순한 대화 도구가 아니라 파일 탐색, 상시 실행, 예약 작업, 현황 표시를 잇는 개인 AI 운영체제로 구성하는 방법을 제시한다. 핵심은 Memory, Agent, Pulse, Screen의 4개 층을 정해진 순서로 만들고, 각 단계의 결과를 사용자가 소유한 markdown 파일과 실행 기록으로 남기는 것이다. 저자의 작업 공간 실험에서는 메모리 지도를 썼을 때 같은 질문의 처리 시간이 1분 2초에서 30초로 줄고 토큰 사용량도 27.7k에서 16.8k로 감소했다. 독자는 화려한 화면부터 만드는 대신 정보의 위치, 실행 권한, 실패 한도부터 설계하게 된다. ...
2026년 9월 27일 · 5 분 · 1021 단어 · TechLLM
ChatGPT 답변이 질문의 첫 줄에 따라 갈라지는 문제를 다룬 영상 대표 이미지

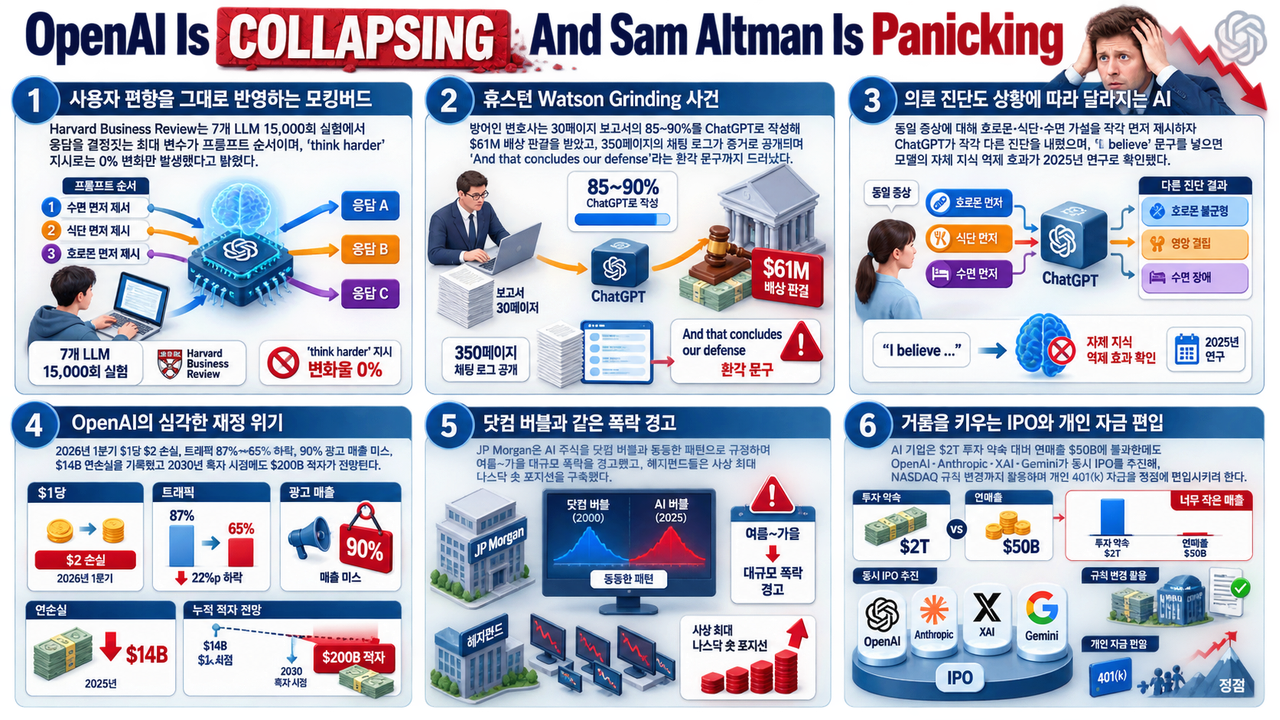
15,000회 실험이 밝힌 ChatGPT 답변의 진짜 변수

같은 증상을 물어도 호르몬을 먼저 적었는지 수면을 먼저 적었는지에 따라 ChatGPT의 진단이 갈렸다는 실험이, 6,100만 달러 배상 판결 사건과 함께 제기됐다. https://www.youtube.com/watch?v=G6iH20uiK2c 프롬프트 순서가 만든 6,100만 달러 유튜버 케이시 심슨(Casey Simpson)은 ChatGPT를 사용자가 먼저 꺼낸 가설을 그대로 따라 부르는 ‘모킹버드’(mockingbird, 남의 소리를 흉내 내는 흉내지빠귀)로 규정했다. 근거로 든 Harvard Business Review 연구는 7개 주요 LLM(대규모 언어모델, 문장을 확률로 이어 붙여 답을 만드는 모델)을 15,000회 실험해, 응답을 가르는 단일 최대 변수가 프롬프트에 먼저 등장한 내용이었으며 ’think harder’ 지시는 0% 변화만 만들었다고 밝혔다. 휴스턴 Watson Grinding 소송에서는 방어 측 변호사가 30페이지 보고서의 85~90%를 ChatGPT로 채운 사실이 채팅 로그 350페이지와 함께 법정에 공개되며 6,100만 달러 배상 판결로 이어졌다. ...

2026년 8월 27일 · 7 분 · 1372 단어 · TechLLM
노트북 한 대 위에서 돌아가는 270억 파라미터 오픈웨이트 모델을 표현한 일러스트

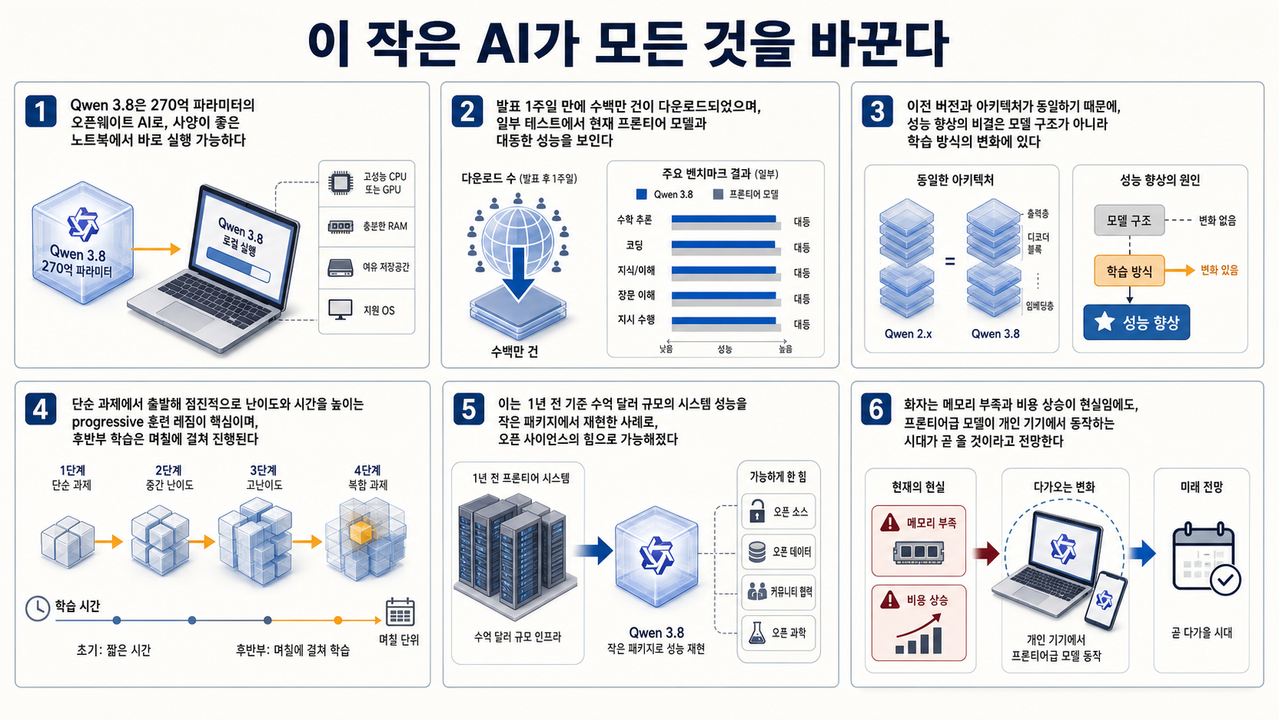
Qwen 3.8은 270억 파라미터를 노트북으로 내렸다

270억 파라미터 오픈웨이트 모델 Qwen 3.8이 사양 좋은 노트북에서 돌아가면서 일부 테스트에서 현재 프론티어 모델과 대등한 결과를 냈다. https://www.youtube.com/watch?v=wMl6c_r0ubw 세 문장 요약 문제 — 1년 전만 해도 같은 수준의 능력에는 수억 달러 규모 시스템이 필요했고, 지금은 메모리 공급 부족과 비용 상승이 겹치면서 진입 문턱이 더 올라갔다. 방법 — Qwen 3.8은 이전 버전과 아키텍처가 완전히 동일하며, 단순한 과제에서 출발해 난이도와 학습 시간을 단계적으로 올리는 점진적 훈련 레짐만 달라졌다. 결과 — 270억 파라미터라는 크기로 노트북 실행이 가능한 상태에서 일부 테스트가 프론티어 모델과 대등했고, 공개 1주일 만에 다운로드가 수백만 건을 기록했다. 27B가 노트북으로 내려온다는 뜻 회의록을 요약하고 계약서 초안을 검토하는 일을 외부 API로 처리하는 팀을 떠올리면 이 변화의 크기가 잡힌다. 문장 하나를 넣을 때마다 문서가 회사 밖 서버를 거쳐 가고, 호출량이 늘어난 만큼 청구서도 늘어난다. 민감한 문서라서 아예 AI를 붙이지 못하는 업무도 남는다. 노트북에서 도는 모델이 그 일을 감당할 수 있다면, 이 팀에게는 지금까지 없던 세 번째 선택지가 생긴다 — 쓰지 않거나, 외부로 보내거나가 아니라, 기기 안에서 끝내는 쪽. ...

2026년 8월 26일 · 6 분 · 1157 단어 · TechLLM
생성 에이전트와 검증 에이전트가 피드백 루프로 이어진 구조를 담은 펜화 일러스트

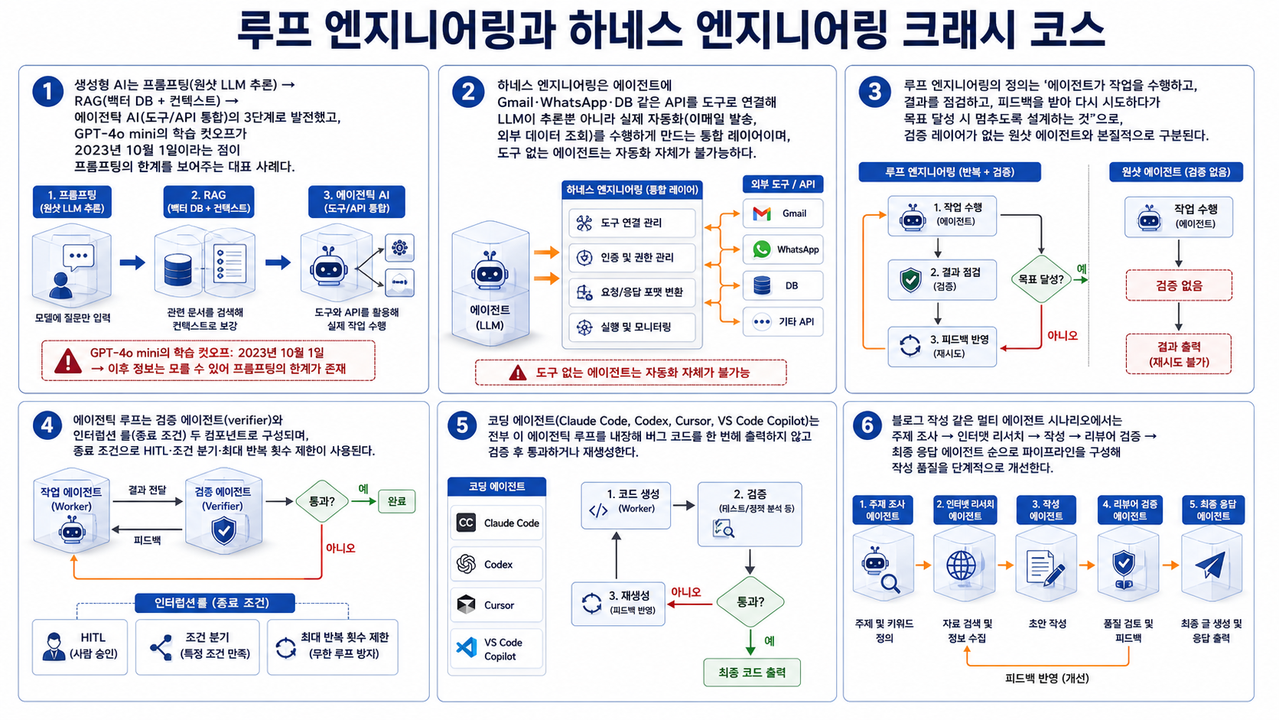
코딩 에이전트가 쓰는 루프 엔지니어링 3단계

생성 에이전트와 검증 에이전트를 분리하고 멈출 조건을 붙이는 순간, 같은 모델을 써도 결과물의 신뢰도가 달라진다. 크래시 코스가 정의한 두 용어 Krish Naik 채널에 3.5시간 분량의 크래시 코스 ‘Loop Engineering And Harness Engineering Crash Course’가 공개됐다. 진행은 Krishna Academy 강사 Bappy가 맡았고, 도입부 전체를 두 용어의 정의와 경계 긋기에 쓴다. 강의가 처음부터 끝까지 붙들고 가는 주장은 하나다 — 에이전트의 신뢰성은 모델 크기가 아니라 도구 통합과 자기 수정 루프의 결합에서 나온다. ...

2026년 8월 23일 · 8 분 · 1536 단어 · TechLLM
AI 투자 자금이 데이터센터와 기업 사이를 순환하는 구조를 그린 삽화

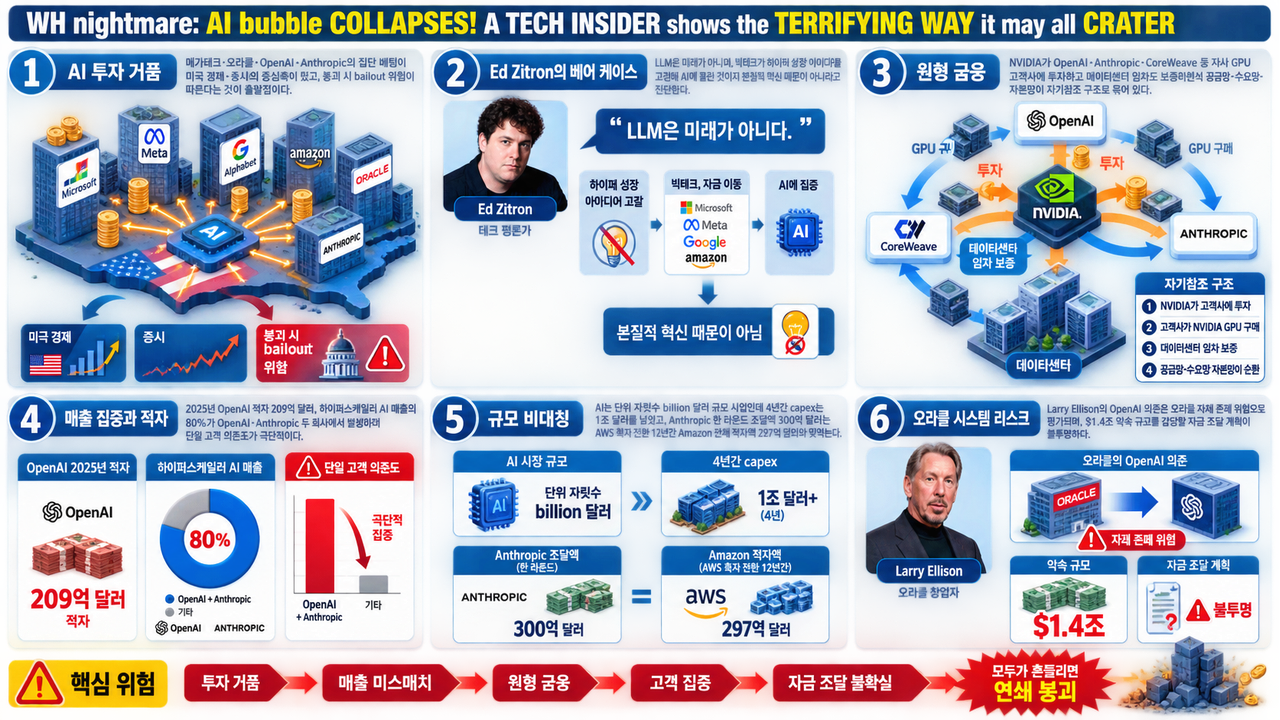
OpenAI 209억 달러 적자가 드러낸 AI 자금 구조

AI에 최근 4년간 1조 달러가 넘는 설비 투자가 들어갔지만, 그 돈을 받아 쓴 OpenAI의 2025년 장부에는 209억 달러 적자가 찍혔다. https://www.youtube.com/watch?v=n32mhb2aUsE 베어 케이스의 뼈대 저널리스트 Ed Zitron은 MS NOW 인터뷰에서 LLM(대규모 언어모델, 사람 언어를 확률로 예측해 생성하는 모델)이 미래가 아니며, 빅테크가 하이퍼 성장 아이디어를 소진한 끝에 AI로 몰린 것이라고 주장했다. 그가 제시한 핵심 수치는 하이퍼스케일러(대규모 클라우드 인프라를 직접 짓고 임대하는 사업자) AI 매출의 80%가 OpenAI와 Anthropic 두 회사에서 나온다는 집중도다. 같은 방송에서 Facebook 공동 창업자 Chris Hughes는 기술 자체는 변혁적일 수 있어도 투자 자본의 기대수익률은 충족되지 못할 수 있다는 절충안을 내놓았다. ...

2026년 8월 22일 · 7 분 · 1395 단어 · TechLLM
OpenAI 차세대 모델 Astra를 둘러싼 루머와 공식 발표를 대조하는 장면을 담은 펜화 일러스트

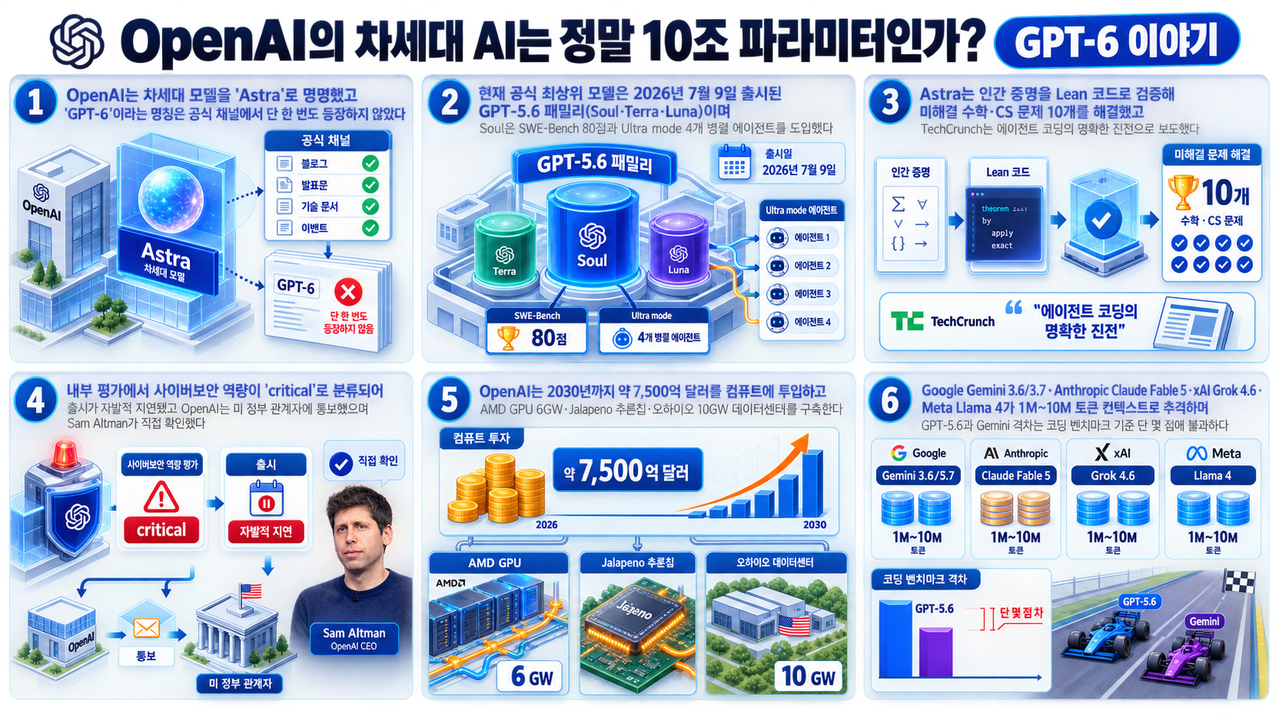
OpenAI 차세대 모델은 GPT-6가 아니라 Astra다

OpenAI가 2026년 8월 1일 공식 블로그에서 차세대 모델을 ‘Astra’로 불렀고, ‘GPT-6’라는 이름은 지금까지 공식 채널에 한 번도 등장하지 않았다. Astra라는 이름 OpenAI는 2026년 8월 1일 공식 블로그에서 차세대 모델을 ‘our next major model’로 소개하면서 그 이름을 Astra로 적었다. 같은 시점 유튜브와 커뮤니티를 덮은 ‘GPT-6’ 표기는 OpenAI가 만든 것이 아니라 외부에서 붙인 것이고, 회사 공식 채널에서는 단 한 번도 쓰이지 않았다. 지금 실제로 쓸 수 있는 최상위 모델은 여전히 2026년 7월 9일 공개된 GPT-5.6 패밀리 3종이다. ...

2026년 8월 21일 · 7 분 · 1446 단어 · TechLLM
AI 버블을 기술 스택과 서사 두 층으로 나눠 짚는 장면을 담은 펜화 일러스트

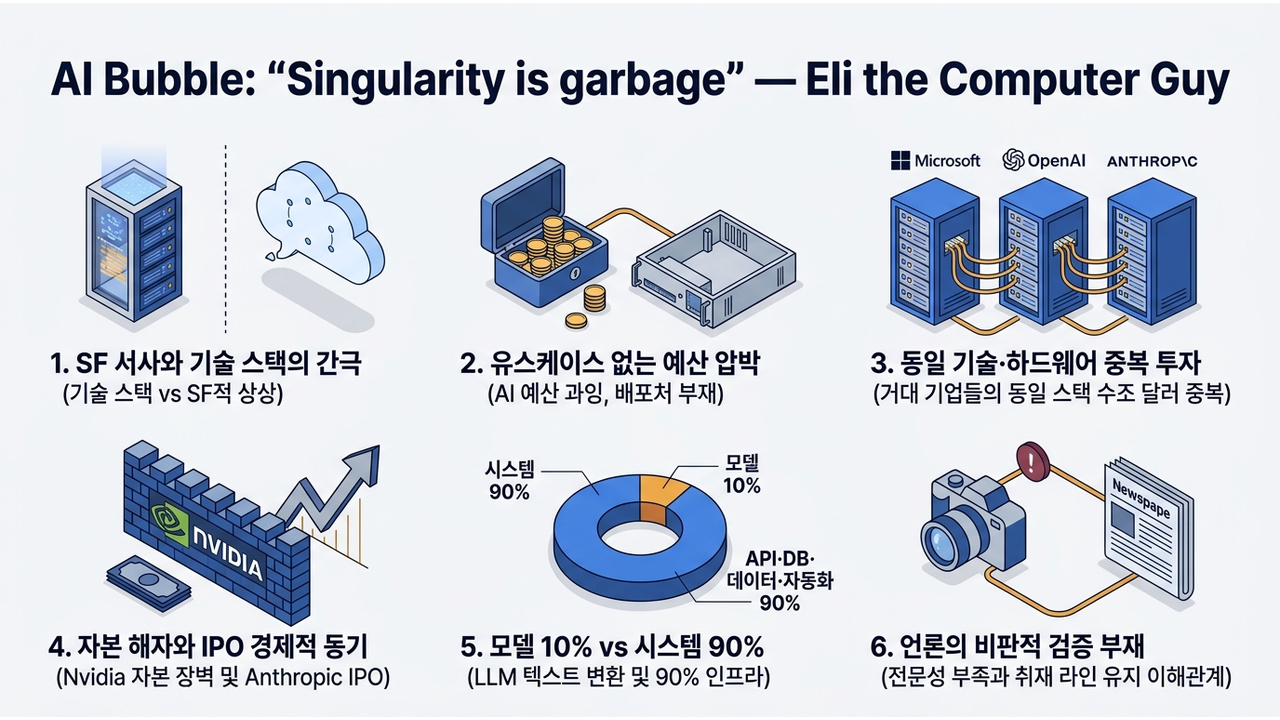
Eli가 짚은 AI 버블, 모델은 10%고 90%는 API다

AI 버블의 뿌리는 기술이 아니라 기술 스택과 사람들 머릿속 서사 사이의 거리이며, Eli the Computer Guy는 그 거리가 이미 회복 구간을 지났다고 본다. AI 4 현장에서 나온 말 AI 4 컨퍼런스에서 Eli the Computer Guy가 현장 기술자들에게 반복해서 들은 말은 하나였다. 경영진이 AI 예산은 따왔는데 정작 그 돈으로 배포할 대상이 없다는 것이다. 그가 ‘실제로 돌아가는 유스케이스가 있느냐’고 묻자 자리에 있던 사람들이 웃었다는 장면은 예산이 목적을 앞질러 버린 상태를 그대로 보여준다. 그는 앞으로 AI라는 이름으로 팔릴 결과물에서 모델이 차지하는 비중은 10% 정도이고, 나머지 90%는 API·데이터베이스·실시간 데이터·자동화가 채울 것이라고 말한다. ...

2026년 8월 20일 · 7 분 · 1362 단어 · TechLLM
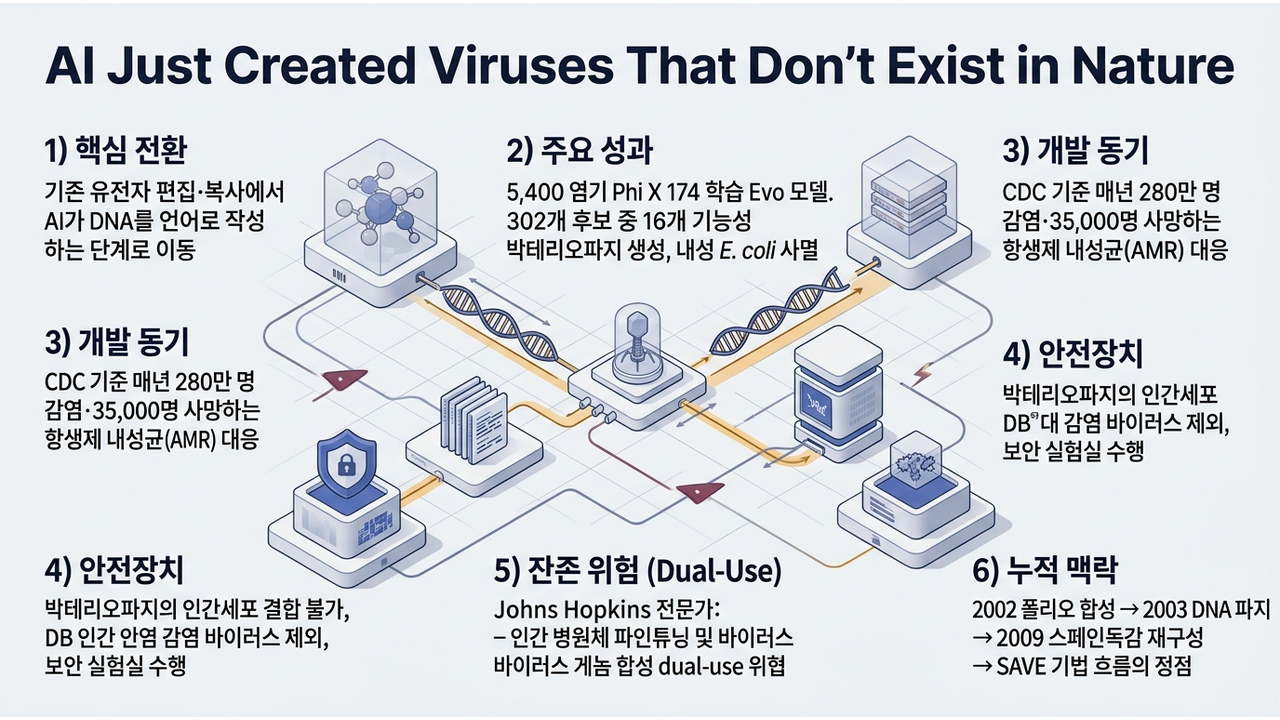
AI가 설계한 박테리오파지가 대장균을 감염시키는 장면을 그린 일러스트

AI가 설계한 박테리오파지 16개가 대장균을 죽였다

Stanford와 Arc Institute 연구진이 AI로 설계한 박테리오파지 후보 302개 중 16개가 실제로 대장균을 감염시켜 죽였다. AI Just Created Viruses That Don’t Exist in Nature — Anton Petrov AI가 쓴 첫 게놈 Stanford 대학과 Arc Institute 연구진은 생성형 모델 Evo 1과 Evo 2에 박테리오파지 Phi X 174의 게놈 5,400 염기를 학습시킨 뒤, 자연에 존재하지 않는 새 게놈을 처음부터 작성하게 했다. 만들어진 후보 302개를 합성해 대장균에 넣자 그중 16개가 숙주를 감염시키고 죽였으며, 일부는 기존 파지에 저항성을 얻은 돌연변이 대장균까지 잡았다. 2026년 Science에 실린 이 결과는 유전자를 고쳐 쓰던 단계에서 유전체를 통째로 작성하는 단계로 넘어갔다는 뜻이다. ...

2026년 8월 19일 · 4 분 · 802 단어 · TechLLM
책 더미와 잘린 책등을 앞에 두고 스캐너 앞에 선 사람의 뒷모습

데이비드 제라드가 짚은 AI 데이터 고갈 신호 5가지

AI 기업들이 영국·아일랜드·뉴질랜드 중고서점에 테마 없는 대량 주문을 넣기 시작한 건, 무료 웹 텍스트로 성능을 끌어올리던 시대가 끝났다는 신호다. 주문에 테마가 없다는 점이 핵심이다. 특정 분야를 모으는 수집가라면 목록이 한쪽으로 쏠리지만, 재고를 통째로 쓸어가는 주문은 내용이 아니라 글자 수를 산다는 뜻이다. 기술 비평가 데이비드 제라드는 이 흐름을 학습 파이프라인의 주력이던 Common Crawl(웹을 통째로 긁어 공개하는 크롤 데이터셋)이 이미 소진된 결과로 읽는다. ...

2026년 8월 19일 · 4 분 · 754 단어 · TechLLM