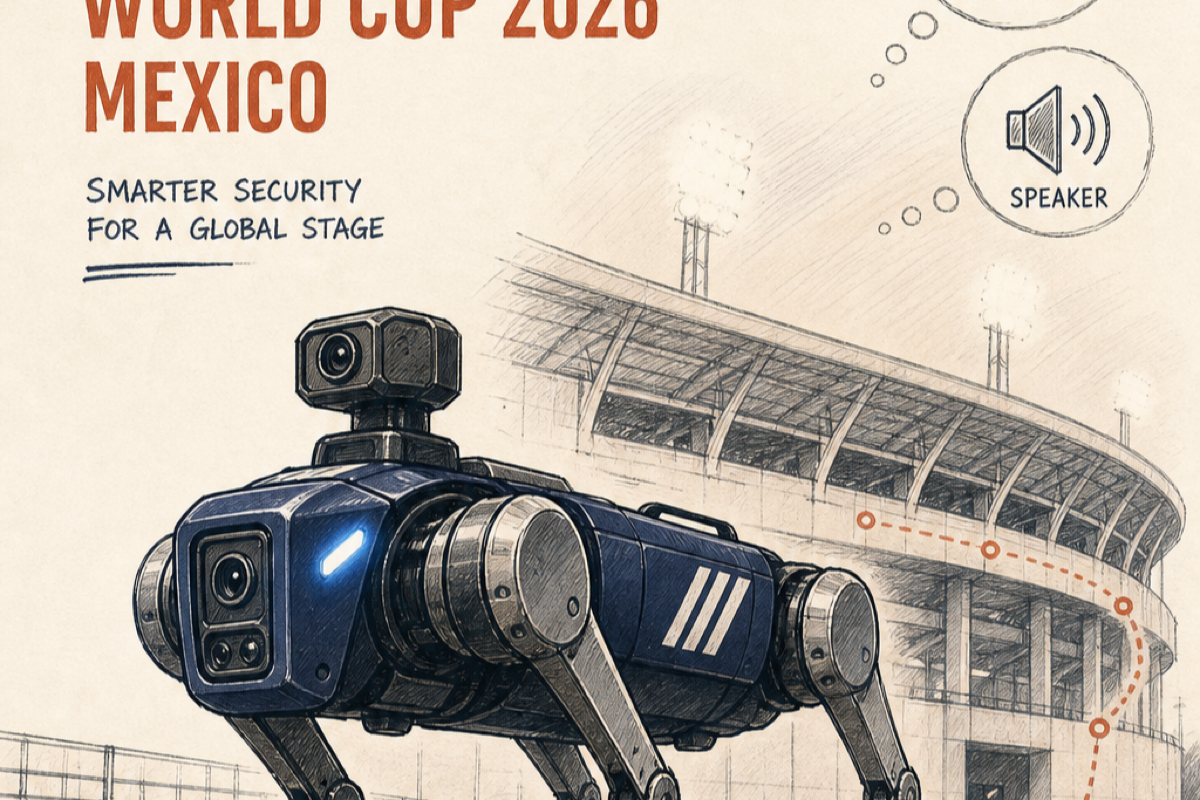
월드컵 경기장 외곽을 순찰하는 4족 로봇개

멕시코 몬테레이, 2026 월드컵 경기장에 중국산 로봇개 K9-X 4대 투입 — 무엇을 어떻게 감시하나

월드컵 경기장에 ‘로봇개 분대’가 등장했습니다. 멕시코 몬테레이 광역권의 위성도시 과달루페(Guadalupe)는 중국 우니트리(Unitree) 4족 로봇 4대로 K9-X라는 신설 부대를 만들고, 월드컵 경기장 주변을 사람 대신 돌게 했습니다. 카메라와 야간 시야 렌즈, 스피커를 단 4족 로봇이 5만 명 넘는 관중 동선을 어떻게 살피는지, 그리고 왜 굳이 ‘무장 없는 원격 조종’이라는 단서가 붙었는지 정리했습니다. ...

2026년 6월 25일 · 4 분 · 852 단어 · TechLLM
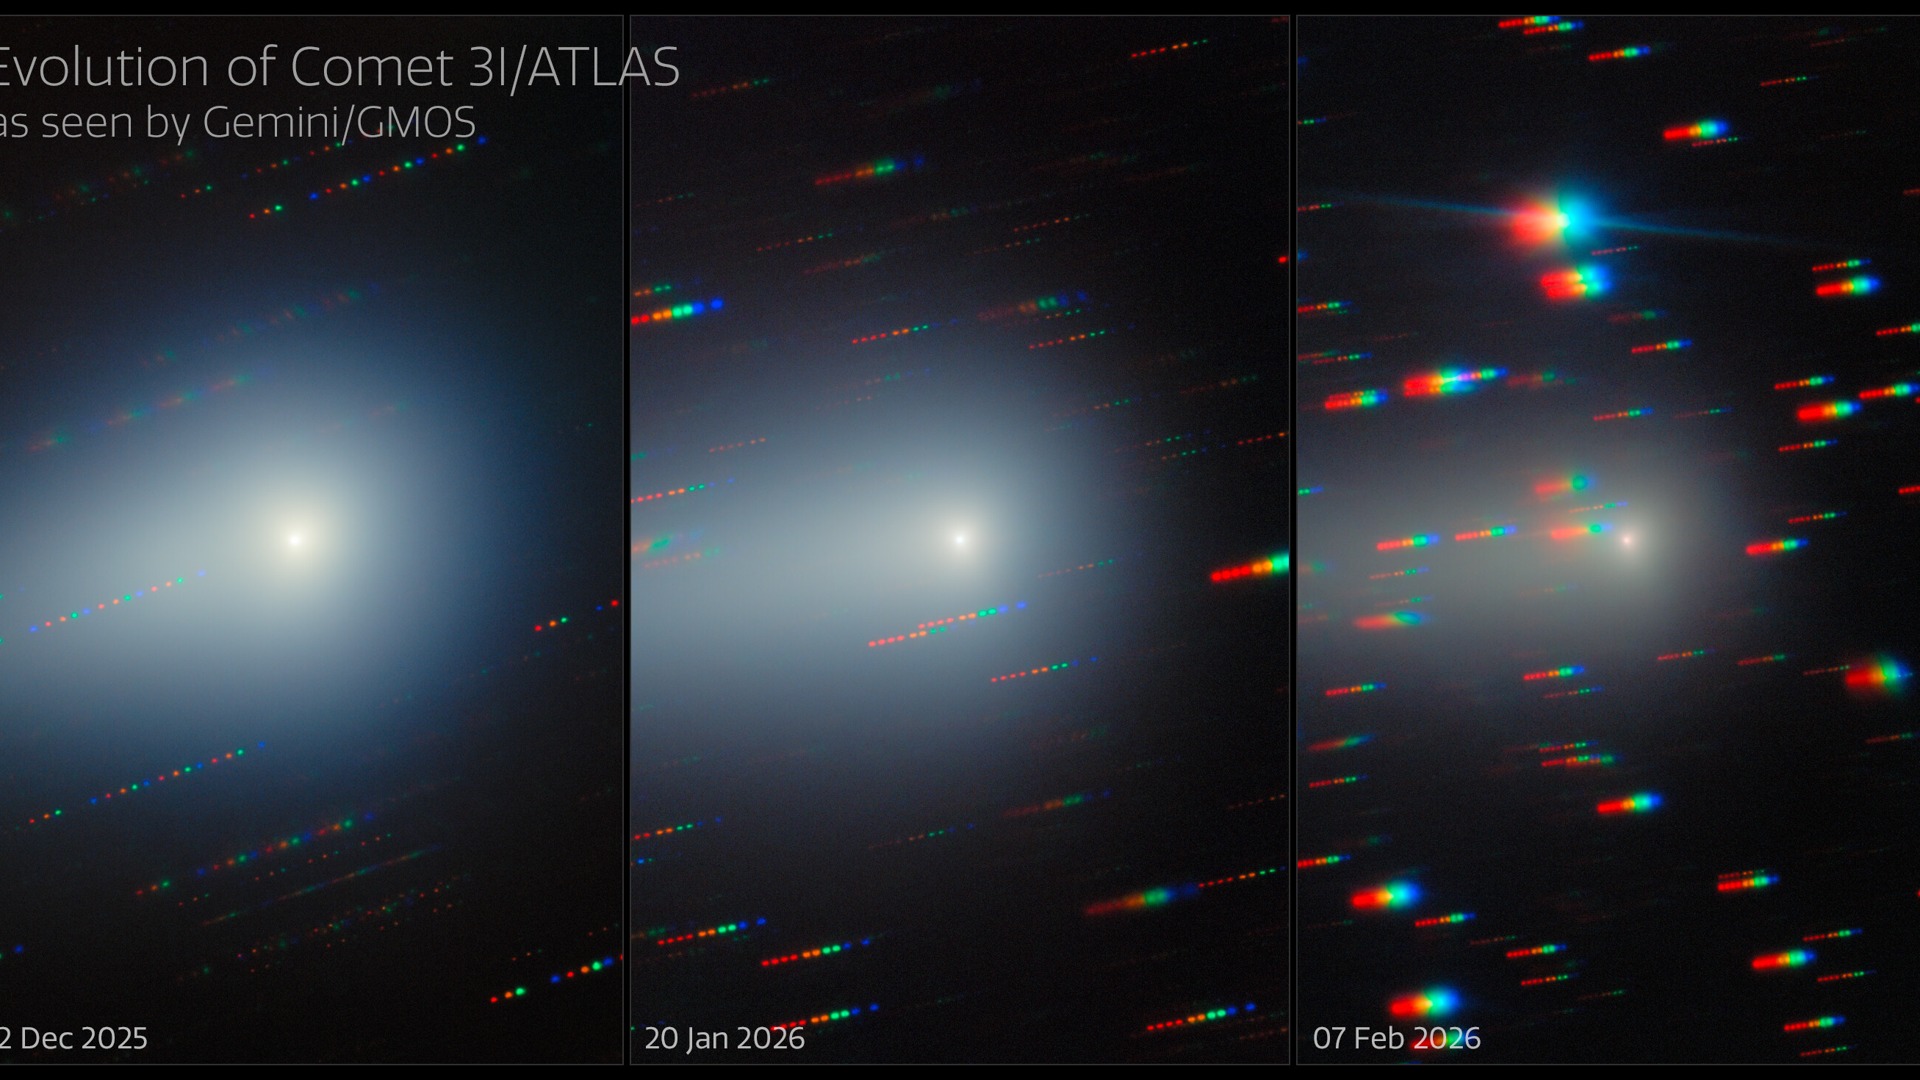
Gemini North 망원경이 한 달 반에 걸쳐 촬영한 인터스텔라 혜성 3I/ATLAS의 합성 이미지

Gemini North가 잡아낸 3I/ATLAS — 색이 바뀌는 인터스텔라 혜성

개요 태양계를 그냥 지나쳐 가는 손님 같은 천체가 있습니다. 어디서 왔는지 알 수 없고, 한 번 지나가면 다시는 오지 않죠. 우리가 그런 인터스텔라 천체를 처음 본 건 2017년 1I/오우무아무아, 두 번째가 2I/보리소프, 그리고 세 번째가 지금 이야기할 3I/ATLAS입니다. 2025년 7월에 발견된 이 혜성을 하와이의 Gemini North 망원경이 한 달 반에 걸쳐 끈질기게 따라붙었고, 그 결과가 NOIRLab의 이번 주 사진(Image of the Week)으로 공개됐습니다. ...

2026년 6월 17일 · 5 분 · 867 단어 · TechLLM
ARIS - Agentic and Relationship Intelligence System for Social Robots

로봇이 인간관계를 이해하는 시대 — ARIS: Social Robots를 위한 관계 지능 시스템

로봇이 내 대화를 듣고, 내가 누구와 무슨 관계인지 기억하고, 그걸 바탕으로 더 자연스럽게 대화하는 시대다. Monash University 연구팀이 그걸 실제로 만들어냈다. 이름하여 ARIS — Agentic and Relationship Intelligence System. 소셜 로봇을 위한 관계 지능 프레임워크다. ...

2026년 5월 17일 · 2 분 · 426 단어 · TechLLM
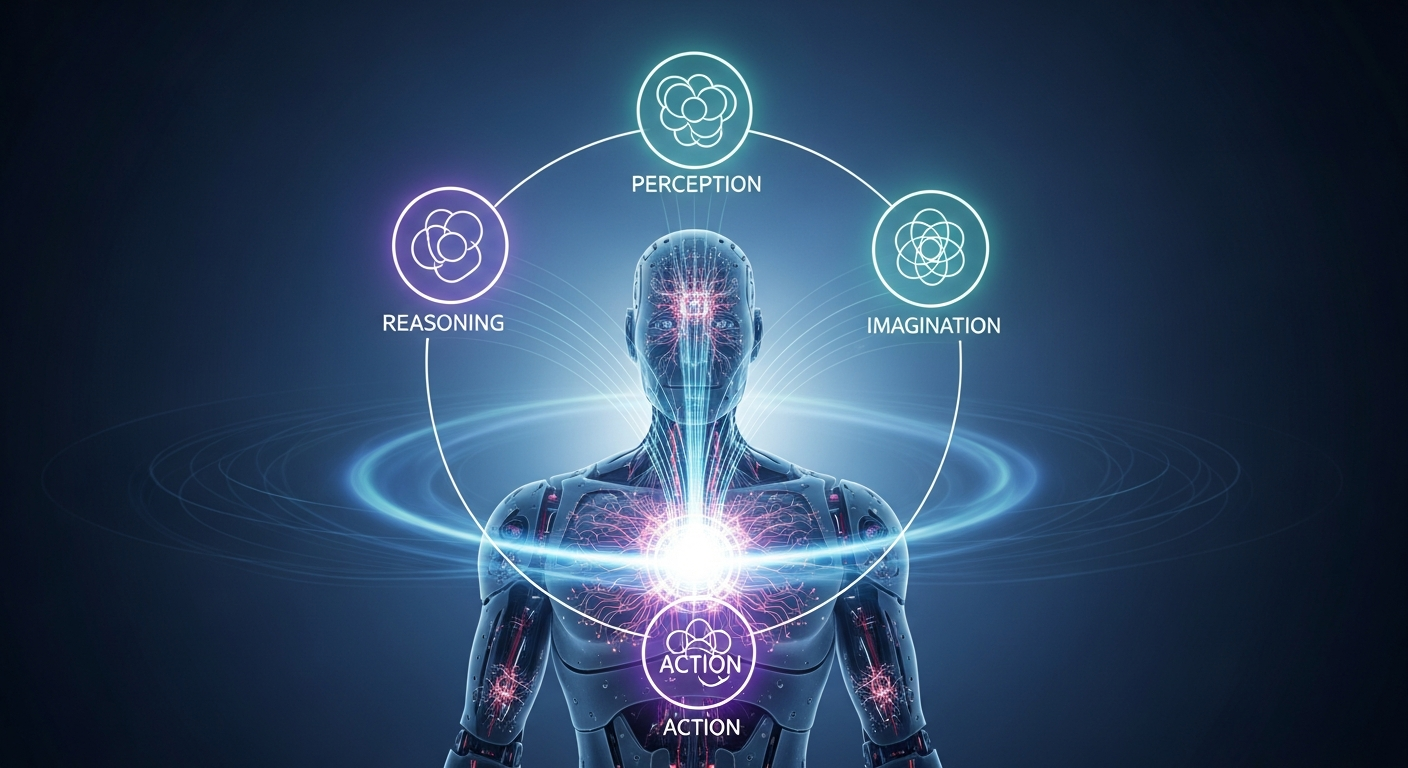
Pelican-Unified 구현체 AI 모델

로봇 AI를 하나로 — Pelican-Unified 1.0, 이해·추론·상상·행동을 단일 모델에

개요 로봇 AI의 오랜 가정은 ‘전문 모듈을 조합하라’였다. 인식 모듈, 추론 엔진, 행동 생성기를 따로 만들어 파이프라인으로 연결한다. Pelican-Unified 1.0은 이 가정을 버렸다. 이해, 추론, 상상, 행동 — 네 가지 능력을 하나의 학습 루프에 묶고, 하나의 체크포인트로 서비스한다. 그리고 전문 모델에 뒤지지 않는 성능을 냈다. ...

2026년 5월 16일 · 3 분 · 597 단어 · TechLLM
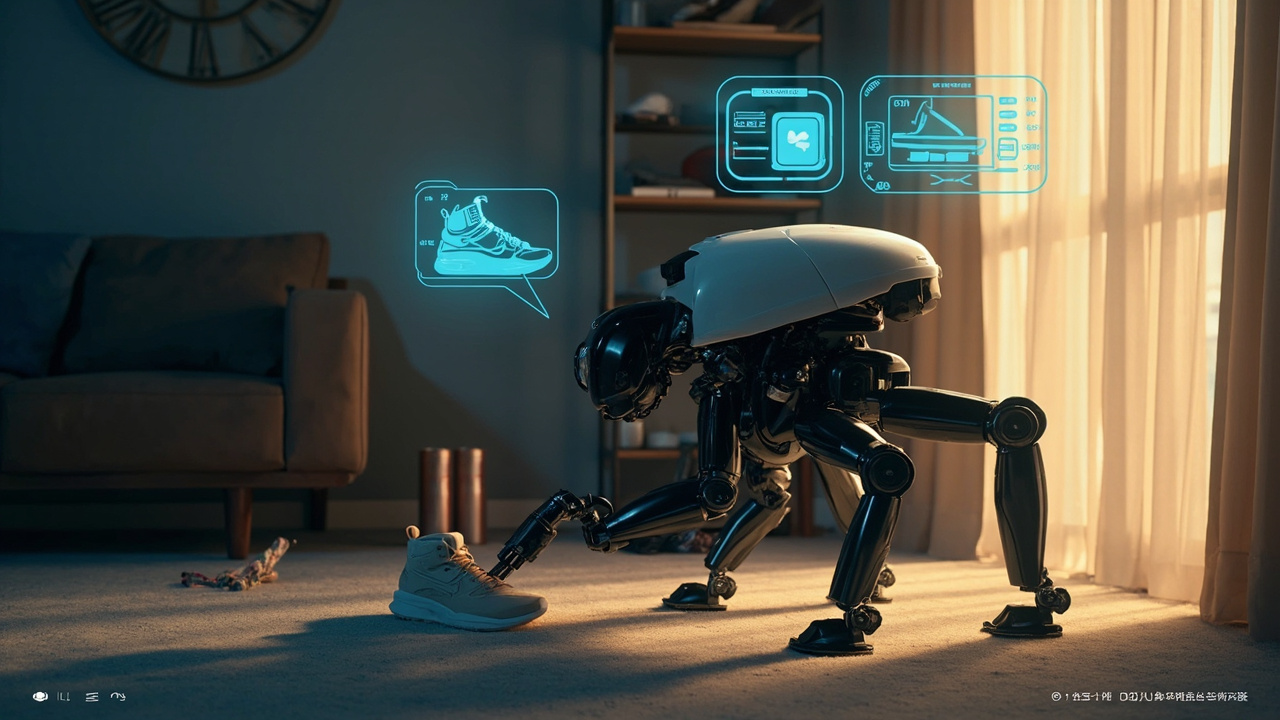
거실에서 자연어 지시로 신발을 정리하는 4족 로봇 일러스트

Spot이 거실 청소를 한다 — Boston Dynamics가 Gemini Robotics로 풀어낸 자연어 로봇 조종 아키텍처

핵심 요약 Boston Dynamics가 산업용 4족 로봇 Spot을 거실에 풀어 신발과 음료 캔을 정리하는 데모를 공개했다. 구동 모델은 Google의 비전-언어 모델 Gemini Robotics-ER 1.5다. 핵심 아키텍처는 Spot SDK 위에 얇은 layer를 올리고, Gemini Robotics에는 한정된 Tool 집합(navigate, take picture, identify, grasp, place)만 노출한 구조. 자연어 한 줄로 Tool 시퀀스를 즉석 구성한다. 작성된 명령은 “Make sure all of the shoes at the front door are on the shoe rack.” 단 한 줄. Gemini가 카메라 이미지를 평가해 객체를 식별하고, Spot의 navigation·manipulation 시스템이 실제 동작을 처리한다. “Operator + Tablet 역할을 LLM이 대신” 한다는 비유가 정확하다. 사람은 to-do 리스트만 던지는 팀장 위치로 올라간다. Tool 응답(“I picked up the object”, “I can’t pick up something while my hand is full”)으로 Gemini가 즉시 적응. 하지만 “새 능력 발명 금지” 가드레일로 API 외 제어는 차단된다 — 예측 가능성 + 적응성의 균형. Boston Dynamics는 이미 AIVI-Learning을 Gemini Robotics ER 1.6로 업그레이드해 Spot/Orbit의 시각 검사 도구에 적용 중. 모델 개선이 같은 하드웨어에 자동으로 흘러 들어온다. 산업용 로봇이 거실에서 신발을 정리한다 Boston Dynamics의 Spot은 공장과 발전소의 거친 환경을 위해 설계된 산업용 로봇이다. 그런 로봇이 거실에서 신발과 음료 캔을 줍는 데모는 어떤 의미일까. 핵심은 로봇이 새 환경을 학습한 게 아니라, 자연어 인터페이스가 환경 적응을 풀어냈다는 점이다. ...
2026년 5월 15일 · 6 분 · 1198 단어 · TechLLM
VLA 모델의 비동기 추론에서 발생하는 관측 stale 문제와 네 가지 보정 방법을 표현한 일러스트

VLA 로봇 모델 추론 지연 문제, 4가지 해법 통일 벤치마크 — A2C2가 가장 강했다

핵심 요약 VLA(Vision-Language-Action) 모델은 일반화된 로봇 제어의 길을 여는 한편, **추론 지연(latency)**이 비동기 실행 시 관측을 낡게(stale) 만든다. 이 문제를 풀기 위해 동시기에 제안된 네 방법(IT-RTC, TT-RTC, VLASH, A2C2)은 그동안 서로 다른 코드베이스·정책·프로토콜로 평가돼 우열을 가릴 수 없었다. 본 논문은 네 방법을 통일된 코드베이스 두 개로 묶어 Kinetix·LIBERO 두 벤치마크에서 추론 지연 d=0~20 단계까지 sweep해 비교했다. A2C2의 per-step 잔차 보정이 Kinetix·LIBERO 모두에서 강했고, TT-RTC는 가장 강건한 학습 기반 방법으로 추론 오버헤드 0이라는 강점을 보였다. VLA 실배포에서 어떤 보정 기법을 고를지는 목표 지연 범위와 추론 비용 허용도에 따라 갈린다는 것이 명확해졌다. VLA 모델과 ‘관측 stale’ 문제 Vision-Language-Action(VLA) 모델은 카메라 입력과 자연어 지시를 한 모델에서 받아 로봇 행동 시퀀스를 생성한다. 일반화 능력은 매력적이지만 모델 크기가 커질수록 한 번의 추론에 걸리는 시간도 길어진다. ...

2026년 5월 12일 · 4 분 · 682 단어 · TechLLM
Reachy Mini 에이전틱 앱스토어 — 자연어로 로봇 앱 제작

코딩 몰라도 로봇 앱 만든다 — Reachy Mini 에이전틱 앱스토어 등장

60년간 로봇은 로봇공학자가 만들었다. Hugging Face가 그 전제를 깨는 실험을 시작했다. 핵심 요약 Hugging Face가 오픈소스 데스크톱 로봇 Reachy Mini용 에이전틱 앱스토어를 출시했다 자연어로 원하는 동작을 설명하면 AI 에이전트가 코드 작성·테스트·배포까지 처리한다 출시 후 150명 이상의 제작자가 200개 이상의 앱을 올렸다 — 대부분 로봇 개발 경험 없음 현재 Reachy Mini 누적 출하량은 약 10,000대, 다음 30일 내 1,000대 추가 예정 전체 스택(하드웨어·소프트웨어·앱·에이전트 트레이스)이 오픈소스 어떻게 작동하는가 워크플로는 간단하다. 에이전트에게 이렇게 말한다. ...

2026년 5월 11일 · 3 분 · 468 단어 · TechLLM