여러 에이전트가 함께 배우는 중에 규칙이 바뀌면, 보상 점수의 흐름만 보고 ‘이제 상황이 달라졌다’고 알려주는 감시 방법이다.

여러 에이전트가 함께 배우는 중에 규칙이 바뀌면, 보상 점수의 흐름만 보고 ‘이제 상황이 달라졌다’고 알려주는 감시 방법이다. 무엇이 문제였나 — 여러 에이전트가 같이 훈련되면, 중간에 목표나 보상 방식이 바뀌어 예전에 배운 행동이 더 이상 맞지 않을 수 있다. 어떻게 풀었나 — PPR은 매 에피소드의 보상 합계를 부드럽게 만든 뒤, 최근 변화가 커졌는지 보고, 최근 구간과 이전 구간의 모양이 다른지 통계적으로 비교한다. 그래서 뭐가 좋아졌나 — 가장 빠른 방법은 아니지만, 같은 변화를 여러 번 울리는 불필요한 경보를 크게 줄여 실제 훈련 감시에 더 적합한 신호를 만든다. ...
2026년 9월 9일 · 5 분 · 1009 단어 · TechLLM

같은 번역 모델에게 '그냥 해', '방언 강조해서 해', '영어 거쳐서 해' 이렇게 세 가지로 시켜서 어디서 결정이 흔들리는지 보는 연구다.

같은 번역 모델에게 ‘그냥 해’, ‘방언 강조해서 해’, ‘영어 거쳐서 해’ 이렇게 세 가지로 시켜서 어디서 결정이 흔들리는지 보는 연구다. 무엇이 문제였나 — 신경망 번역은 한 문장을 넣으면 한 결과만 보여줘서 모델이 어떤 선택지를 고민했는지 알 수 없었다. 어떻게 풀었나 — 같은 모델을 세 가지 경로(직접/방언 안정화/영어 우회)로 돌려보고, 결과 차이가 어디서 생기는지 행동 지표로 측정했다. 그래서 뭐가 좋아졌나 — 경량 학습만으로도 방언 표현이 두 배 가까이 늘고, 문장 길이 들쭉날쭉한 문제도 크게 줄었다. ...

2026년 9월 7일 · 6 분 · 1077 단어 · TechLLM

어텐션 행렬을 어떻게 쪼개 표현하느냐에 따라 거대한 모델이 빈 상태에서 정보를 학습해 빠져나오는 속도와 경로가 완전히 달라진다는 것을 수학적으로 증명한 이론 논문이다.

어텐션 행렬을 어떻게 쪼개 표현하느냐에 따라 거대한 모델이 빈 상태에서 정보를 학습해 빠져나오는 속도와 경로가 완전히 달라진다는 것을 수학적으로 증명한 이론 논문이다. 무엇이 문제였나 — 어텐션은 모든 최신 거대 모델의 핵심 부품인데, 학습 과정이 수학적으로 어떻게 돌아가는지 거의 알려진 바가 없었다 어떻게 풀었나 — 모델의 차원을 무한대로 키우는 극한에서 어텐션-인덱스 모델이라는 틀을 세우고, 어텐션 행렬을 직접 쓰는 경우·대칭 형태로 묶는 경우·두 행렬의 곱으로 푸는 경우 세 가지를 비교했다 그래서 뭐가 좋아졌나 — 어떤 어텐션 구조가 언제, 왜 정보를 학습하기 시작하는지 정확히 알 수 있게 되었고, 무한 차원 동역학을 유한 차원으로 근사하는 방법도 함께 얻었다 ...

2026년 9월 6일 · 8 분 · 1526 단어 · TechLLM

이미지 검색 모델이 '빨간 컵이 파란 그릇 왼쪽' 같은 세부 설명을 잘 구분하지 못하는 문제를, 더 똑똑한 모델의 채점표를 가르쳐서 해결한 연구다.

이미지 검색 모델이 ‘빨간 컵이 파란 그릇 왼쪽’ 같은 세부 설명을 잘 구분하지 못하는 문제를, 더 똑똑한 모델의 채점표를 가르쳐서 해결한 연구다. 무엇이 문제였나 — 기존 MLLM 임베딩 모델은 ‘속성-객체 결합’ 같은 조합을 구분하지 못해, 비슷한 그림을 헷갈려 했다 어떻게 풀었나 — 같은 모델이라도 ‘교차 어텐션 재순위 모델’로 쓰면 이런 차이를 잘 본다는 사실을 이용해, 재순위 모델의 5단계 채점표를 임베딩 모델에 증류(가르침)했다 그래서 뭐가 좋아졌나 — 조합 추론 성능은 크게 끌어올리면서 일반 이미지 검색 능력은 유지했고, 다중 조건 검색(MCMR) 같은 실전 벤치마크에서도 이 개선이 그대로 옮겨갔다 ...

2026년 9월 5일 · 7 분 · 1296 단어 · TechLLM

여러 칩을 수직으로 쌓는 3D 반도체 설계 연구자들이 똑같은 문제로 서로의 알고리즘을 공정하게 비교할 수 있도록, 표준 테스트용 칩 설계 20개를 무료로 공개했다.

여러 칩을 수직으로 쌓는 3D 반도체 설계 연구자들이 똑같은 문제로 서로의 알고리즘을 공정하게 비교할 수 있도록, 표준 테스트용 칩 설계 20개를 무료로 공개했다. 무엇이 문제였나 — 기존 2D 칩 설계용 표준 테스트는 있었지만, 여러 칩을 수직으로 쌓는 3D 칩 설계용 표준 테스트는 없었다. 어떻게 풀었나 — 작은 칩 부품(계산·메모리·I/O·아날로그)을 레고처럼 조합해 난이도별 20개 테스트 설계를 만들었다. 그래서 뭐가 좋아졌나 — 이제 전 세계 연구팀이 동일한 3D 칩 문제로 자기 알고리즘의 성능을 공정하게 비교할 수 있게 됐다. ...

2026년 8월 28일 · 4 분 · 663 단어 · TechLLM
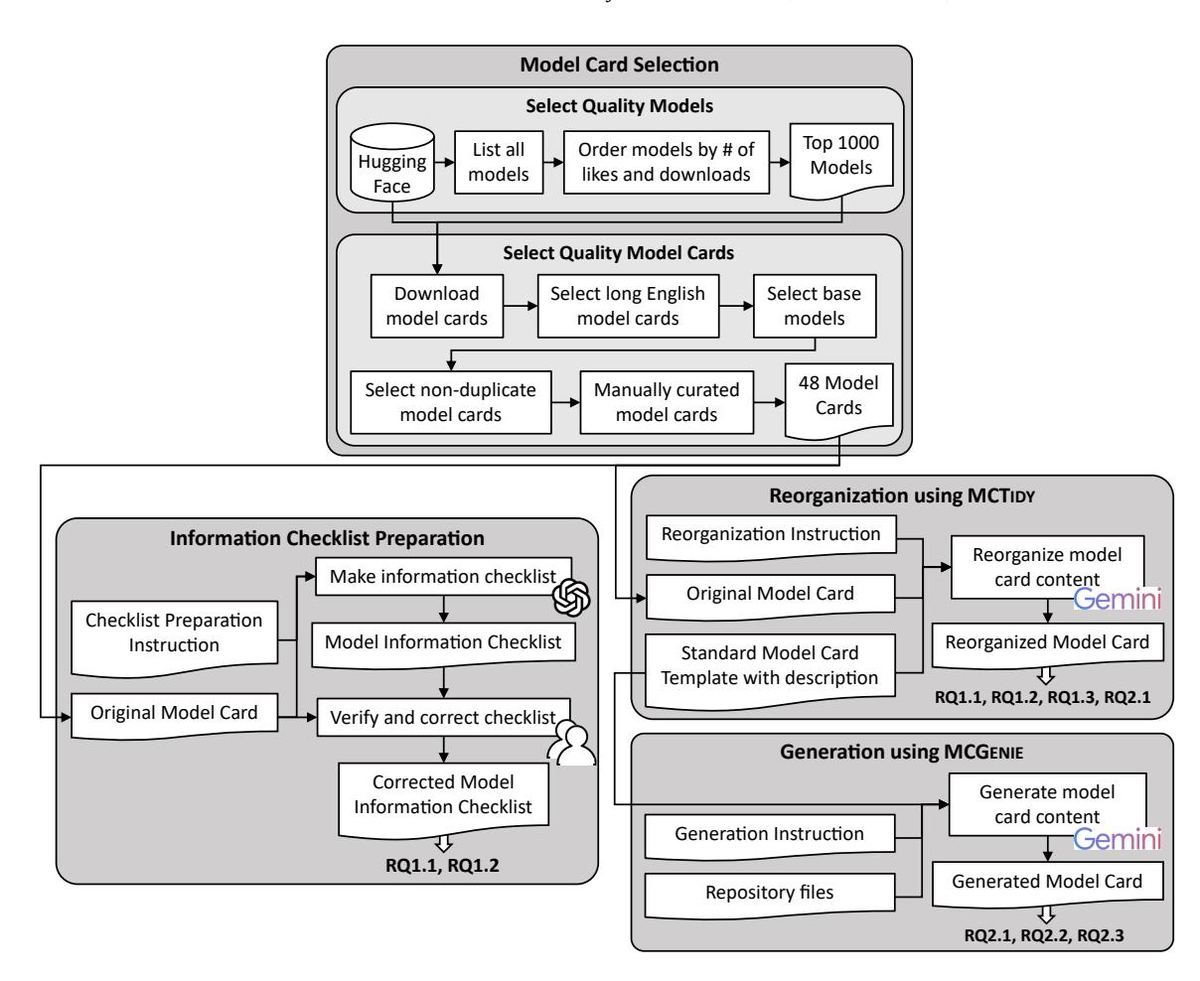
전체 연구 파이프라인: 944,178개 후보 → 다단계 필터링 → 48개 베이스 모델 선정 → MCTidy 재배치 → MCGenie 생성 → 평가

AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다.

AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다. 무엇이 문제였나 — 공개된 AI 모델들이 사용하는 설명서(모델 카드)가 양식도 제각각이고 아예 없는 경우도 많아, 어떤 모델을 어떻게 써야 안전한지 비교하기 어려웠다. 어떻게 풀었나 — 기존 모델 카드를 표준 양식으로 자동 재배치하는 MCTidy와, 저장소 파일·논문만 읽고 새 모델 카드를 자동 생성하는 MCGenie 두 시스템을 만들었다. 그래서 뭐가 좋아졌나 — 48개 모델 평가에서 정보 손실은 4.5% 수준으로 미미했고, 섹션 배치는 98.1% 정확했고, 자동 생성 카드의 절반 이상은 사실 오류가 없는 완성형으로 나왔다. ...

2026년 8월 27일 · 6 분 · 1229 단어 · TechLLM
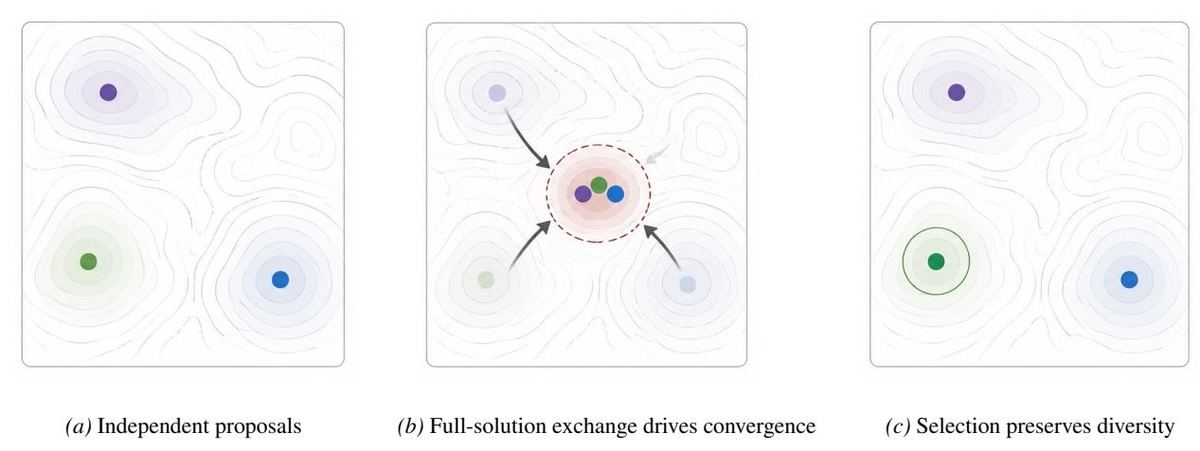
상호작용 세금의 메커니즘: 서로 다른 모델 패밀리가 구조적으로 다른 해를 찾지만, 풀-솔루션 교환 후 한 라운드 만에 수렴해 다양성이 사라짐을 시각화

여러 AI가 팀으로 일할 때, 서로의 완성된 답을 너무 일찍 공유하면 오히려 다 같아져서 결과가 나빠진다는 것을 보여준 연구

여러 AI가 팀으로 일할 때, 서로의 완성된 답을 너무 일찍 공유하면 오히려 다 같아져서 결과가 나빠진다는 것을 보여준 연구 무엇이 문제였나 — 여러 AI 모델이 팀으로 일하면 더 좋아진다는 보고와, 오히려 비용만 늘고 품질은 그대로라는 보고가 계속 충돌했다 어떻게 풀었나 — 이유는 ‘다 같은 팀이 아니다’였다. 서로 다른 성격의 AI들이 각자 다른 답을 만드는데, 서로의 완성된 답을 한 번만 봐도 모두 비슷한 답으로 수렴해버린다 그래서 뭐가 좋아졌나 — 답을 서로 보여주지 않고 각자 만든 다음 점수만 비교해 가장 좋은 답을 고르는 방식(MoA)만이 다양성을 지킨다는 것을 증명했다 ...

2026년 8월 26일 · 6 분 · 1263 단어 · TechLLM
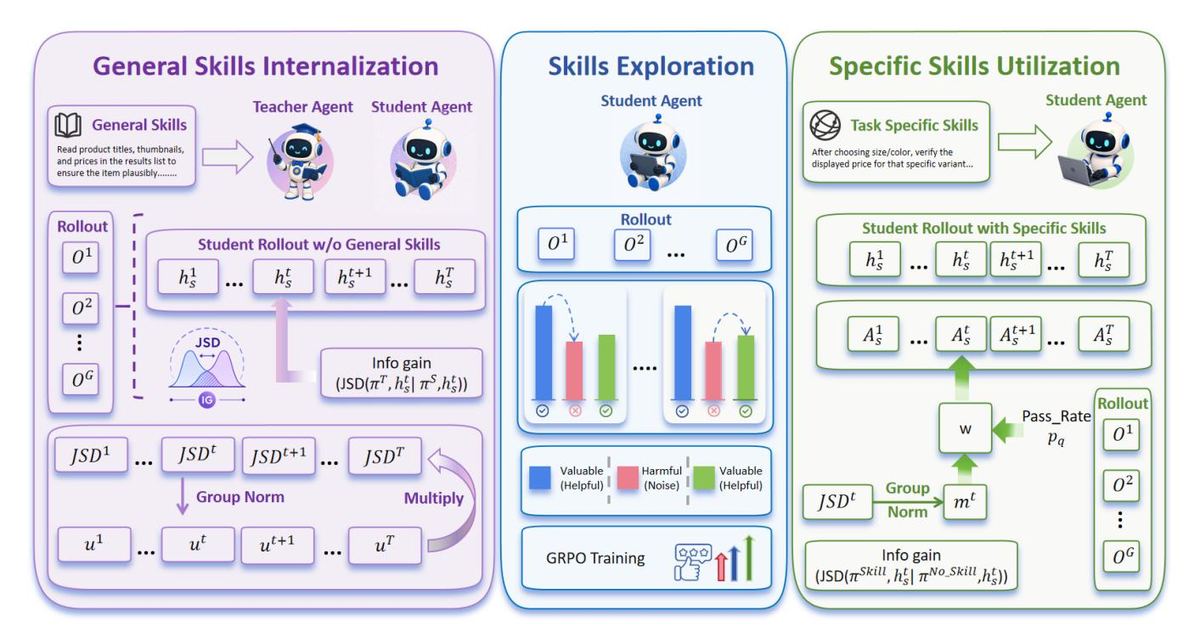
AUSO의 3단계 파이프라인 — General Skills Internalization → Skills Exploration(GRPO) → Specific Skill Utilization — 전체 구조 요약도

AUSO는 인공지능 에이전트가 '지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?'를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다.

AUSO는 인공지능 에이전트가 ‘지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?‘를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다. 무엇이 문제였나 — 기존 방법은 문제 전체가 성공했는지 실패했는지만 보고, 힌트를 외우는 단계와 힌트를 쓰는 단계를 단순히 갈랐다. 같은 과정 안의 모든 행동이 똑같은 대우를 받아서, 쓸데없는 행동까지 강해질 수 있었다. 어떻게 풀었나 — AUSO는 힌트를 넣었을 때와 뺐을 때 에이전트가 고르는 다음 행동이 얼마나 달라지는지를 수학적으로 잰 뒤, 힌트에 민감한 행동과 둔감한 행동을 구분한다. 민감한 행동은 더 크게 배우고, 방해가 되는 행동은 억제한다. 그래서 뭐가 좋아졌나 — 그 결과, 훈련 때 봤던 문제에서는 성능을 유지하면서 처음 보는 문제에서도 더 높은 성공률을 보였고, 필요 없는 행동이 줄어 한 문제를 끝내는 데 걸리는 단계 수도 짧아졌다. ...

2026년 8월 25일 · 7 분 · 1295 단어 · TechLLM
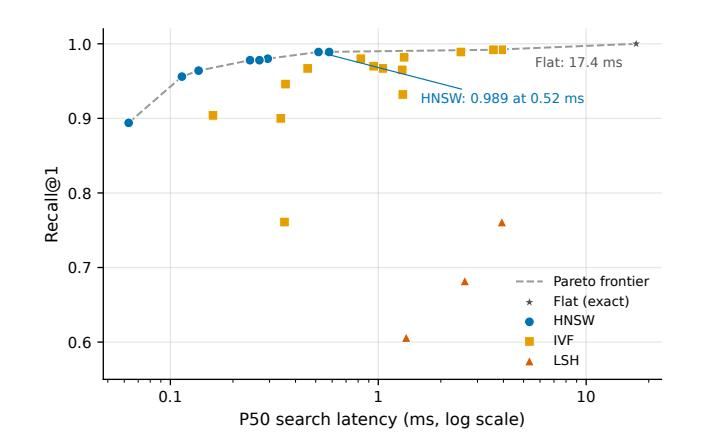
499K 벡터에서 4개 FAISS 인덱스의 Recall@1 vs P50 지연시간(log scale) Pareto frontier.

7가지 LLM 캐시 삭제 정책을 같은 조건에서 비교했더니 복잡한 기하학 기반 정책이 단순한 LFU보다 더 좋지 않았고, 매칭 임계값을 잘못 고르면 매치의 96%가 쓸모 없는 답변이라는 사실이 드러났다.

7가지 LLM 캐시 삭제 정책을 같은 조건에서 비교했더니 복잡한 기하학 기반 정책이 단순한 LFU보다 더 좋지 않았고, 매칭 임계값을 잘못 고르면 매치의 96%가 쓸모 없는 답변이라는 사실이 드러났다. ...

2026년 8월 24일 · 7 분 · 1380 단어 · TechLLM